自托管的数据库一旦承担"博客 + 监控 + 账号"多个服务的读写,增长期的痛会先落在单点上:一台库的 CPU 和连接数被打满,读多写少的流量全压在同一台机器。关系库通常有"一台能写、多台可读"的天然节奏——这正是主从复制(Replication)与读写分离(Read/Write Splitting)要解决的问题:把"写"集中到主库,把大量的"读"分摊到若干从库,再让应用自动选择该走哪条路。这篇讲清复制解决什么、主从怎么搭、读写分离怎么做与何时做、以及延迟兜底、故障切换与常见坑。
一、主从复制解决什么:把"读的流量"从单点库上卸下来
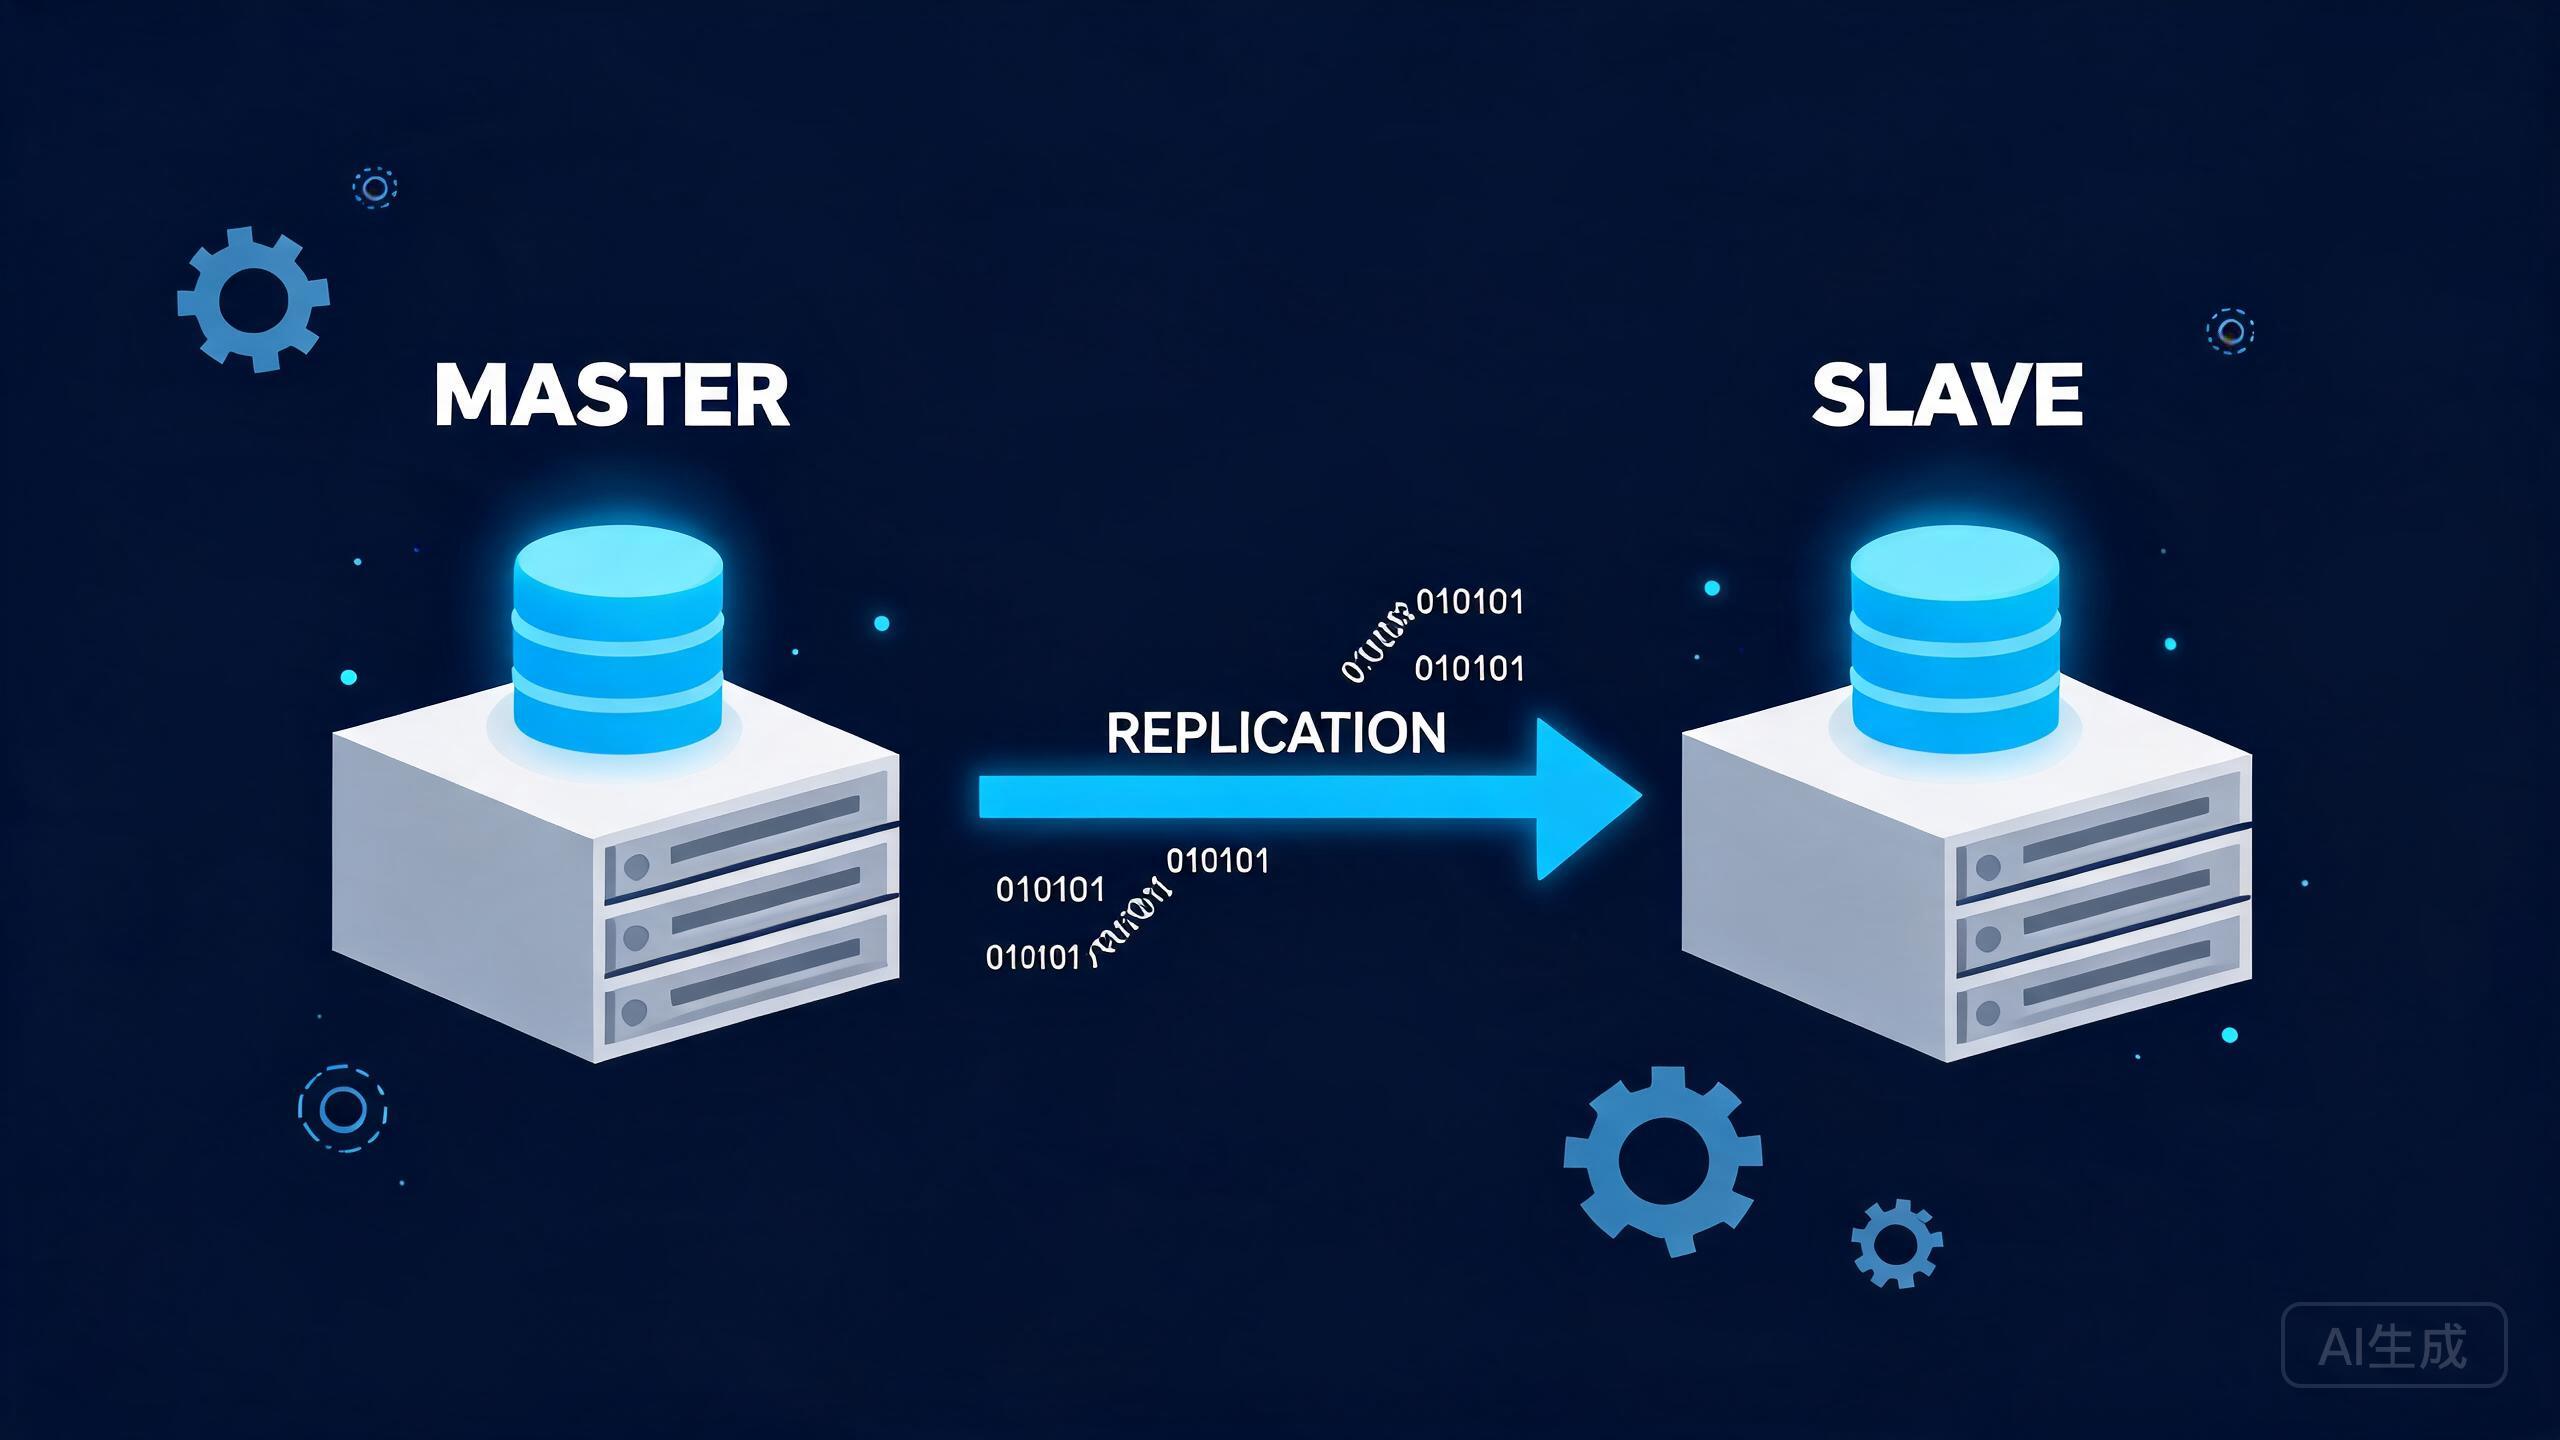
关系库性能瓶颈,大多数时候不在"写"而在"读":每次页面刷新、每次拉列表、每次查询都是读,往往远多于写。把一台库扛所有读写,到达一定量就是"CPU 高、连接耗尽、排查全是 Query"。主从复制的思路是:让一台主库(Primary)接受所有写,把数据变更不断复制到一台或多台从库(Replica),业务查询可以打到从库上——于是"写"集中、确定性高,"读"被分摊到多台、可并行。它本质上是把"单点扛全部"变成"写主读从"的分工架构,给增长期腾出横向扩展的可能。
但要先明确边界:复制解决的是"读的容量",不解决"写的容量"——如果瓶颈在写,主从意义不大,那是另一套分片/优化的话题。对自托管大多数场景(读多写少、一台主库跑多个服务),主从是性价比很高的减压手段,它让一台长期吃紧的库多撑很久,也提升了"某台机挂了可用副本顶上"的容错。
二、MySQL 主从怎么搭:binlog + 一个复制账号 + 一致位置
以 MySQL/MariaDB 为例,主从的核心是:主库开启二进制日志(binlog),从库拉取主库 binlog 并重放,从而获得与主库一致的数据副本。搭建步骤大致是:主库设置 server-id 与 binlog、创建专用复制账号;-从从库找一个一致的逻辑位置(用主库的备份在从库上恢复并记下 binlog 文件与位置,或冷启动对齐);从库 CHANGE MASTER 指定主库地址、账号与位置并 START SLAVE。之后每秒同步,直到停止复制。更现代的替代是 GTID,跟踪复制位置更省心。
# 主库 my.cnf 关键项
[mysqld]
server-id=1
log-bin=mysql-bin
binlog_format=ROW

# 主库上创建复制账号(最小权限)
# CREATE USER 'repl'@'从库IP' IDENTIFIED BY '强密码';
# GRANT REPLICATION SLAVE ON *.* TO 'repl'@'从库IP';

# 从库上指定主库并启动(位置号取自主库备份时刻)
CHANGE MASTER TO
  MASTER_HOST='主库IP', MASTER_USER='repl',
  MASTER_PASSWORD='强密码',
  MASTER_LOG_FILE='mysql-bin.000123', MASTER_LOG_POS=456789;
START SLAVE;
SHOW SLAVE STATUS\G   # 看 Slave_IO_Running 与 Slave_SQL_Running 是否都为 Yes
判断主从是否真正健康,不要只看"能连":`SHOW SLAVE STATUS` 里的两个 Running 都要是 Yes,且 `Seconds_Behind_Master` 要稳定在低位(没一直滞后)。只要 SQL/IO 线程有一侧不是 Yes,数据就不再实时同步,此时从库读到的都是旧数据——这就是"安静的延迟"最危险的地方。把"主从状态与延迟"纳入监控告警,是搭完复制后第一件必须做的事。
三、读写分离怎么做与适合谁:应用或中间层,何时才值得
有了一主一从,下一步是"读走去从库、写去主库"的分离。做法有两类:一是应用层自己路由(框架或代码里区分读写连接池),最灵活但侵入;二是中间件/代理层(如 ProxySQL、MySQL Router)把 SQL 按"是否写"自动分发到对应实例,应用透明、集中管理。大多数自托管用中间层更省心,因为它不改代码、天然把读引流到从库。但要注意:读写分离不是开了就有收益——只有当"读确实远多于写、且读确实打到从库上"才划算,否则多了节点、多了复杂度却没什么提升。
# 用 ProxySQL 做读写分离的最小思路
# 定义后端:mysql_servers 里主库 hostgroup 记为 10(写),从库 20(读)
# 规则:把 SELECT 分到读组(20),其余(INSERT/UPDATE/DELETE)分到写组(10):
#   INSERT INTO mysql_query_rules
#     (active, match_pattern, destination_hostgroup)
#     VALUES (1, '^SELECT', 20);
#   INSERT INTO mysql_query_rules
#     (active, match_pattern, destination_hostgroup)
#     VALUES (1, '^(?!SELECT)', 10);
容易踩的坑是"刚写完立刻读":主从是异步的,写进主库到同步到从库有毫秒级到秒级的延迟。如果一个接口"写入后马上查自己刚写的内容",查到走从库可能读旧值。解法:对该类"必须读最新的"查询强制走主库(应用标记或中间层规则),或让整体同步延迟足够低。这是读写分离最容易出"偶发读到旧数据"的地方,一定要在架构里明确"强一致路径 vs 最终一致路径"。
四、常见坑:延迟、故障切换、只读保护与备份
主从 + 读写分离跑起来,四个坑要防住。一是"延迟没有被看见":不盯 `Seconds_Behind_Master`,从库悄悄掉队了你还在上面读旧数据,加告警别让延迟静默。二是"故障切换别裸奔":主库挂了,哪台来接管写、应用怎么知道切换?要预先定好"从库提升为主 / 或重定向(VIP/代理)"的方案并可演练,别真出事才临时手忙脚乱。三是从库做成"super_read_only"防止误写污染副本;四是复制不替代备份——主从多副本不等于异地备份,binlog 与备份仍要按容灾策略做。把这些当排障 SOP:先看延迟与两个 Running 线程,再确认读写分离分组规则是否把该走的读/写分对了,最后检查切换与备份预案是否到位。
# 从库只读保护(防止误改副本)
[mysqld]
read_only=1            # 普通用户只读
super_read_only=1     # 连超级用户也禁写(复制进程不受影响)
把主从真正用稳的标准是"有监控、有切换预案、延迟可见":不是搭完复制就算组好,而是让它"失败能被发现、切换有预案、延迟不静默"——这样当流量上来或某台机挂了,你才不至于手忙脚乱。
五、边界:复制解决"读的容量",不是万能的扩展万能方
主从复制与读写分离的边界要认清:它主要缓解"读多写少"的读压力,改不掉"写的单点";当读到一定程度、单从扛不动,要走向"分库分表/多读副本/缓存"等更大扩展手段;而复制链路本身是新的故障点——从库数据不一致、切换误操作都会波及业务,因此要有预案与演练。对绝大多数自托管(一台主库跑多个服务、读多写少),主从 + 适当读写分离 + 延迟监控,能稳妥地让增长期多撑很久,但别指望它解决一切扩展与一致性。
回到自托管整体,主从复制与读写分离是把"读的流量"从单点库上卸下来、让增长期多撑几年的务实手段。落地要点:主库开 binlog、建最小复制账号,从库对齐一致位置并确认 IO/SQL 两个 Running 为 Yes;把读引流到从库(应用路由或用 ProxySQL 类中间层),对"必须读新"的查询强制走主库;紧盯延迟与主从健康、配好故障切换与从库只读、并保留独立备份。认清它化解的是读压力而非写单点,把"延迟可见、切换有预案、备份仍要做"这条闭环做成主从的价值前提。
结语
主从复制与读写分离的价值,是把"读多写少"带来的单点读压力,用"写主读从"的分工摊到多台库上,为自托管增长期腾出横向扩展空间。落地要点:明确复制解决读容量而非写单点的边界;按"binlog + 复制账号 + 一致位置"搭起主从并看两个 Running 线程;用应用路由或 ProxySQL 做读写分离,对强一致路径强制走主库;防住延迟静默、裸奔切换、从库误写与"复制替代备份"四坑。当这套主从 + 读写分离落地且延迟可见、切换有预案,自托管数据库才能从"一台扛全部"平稳过渡到"读写分工、能扛更长"的稳定状态。