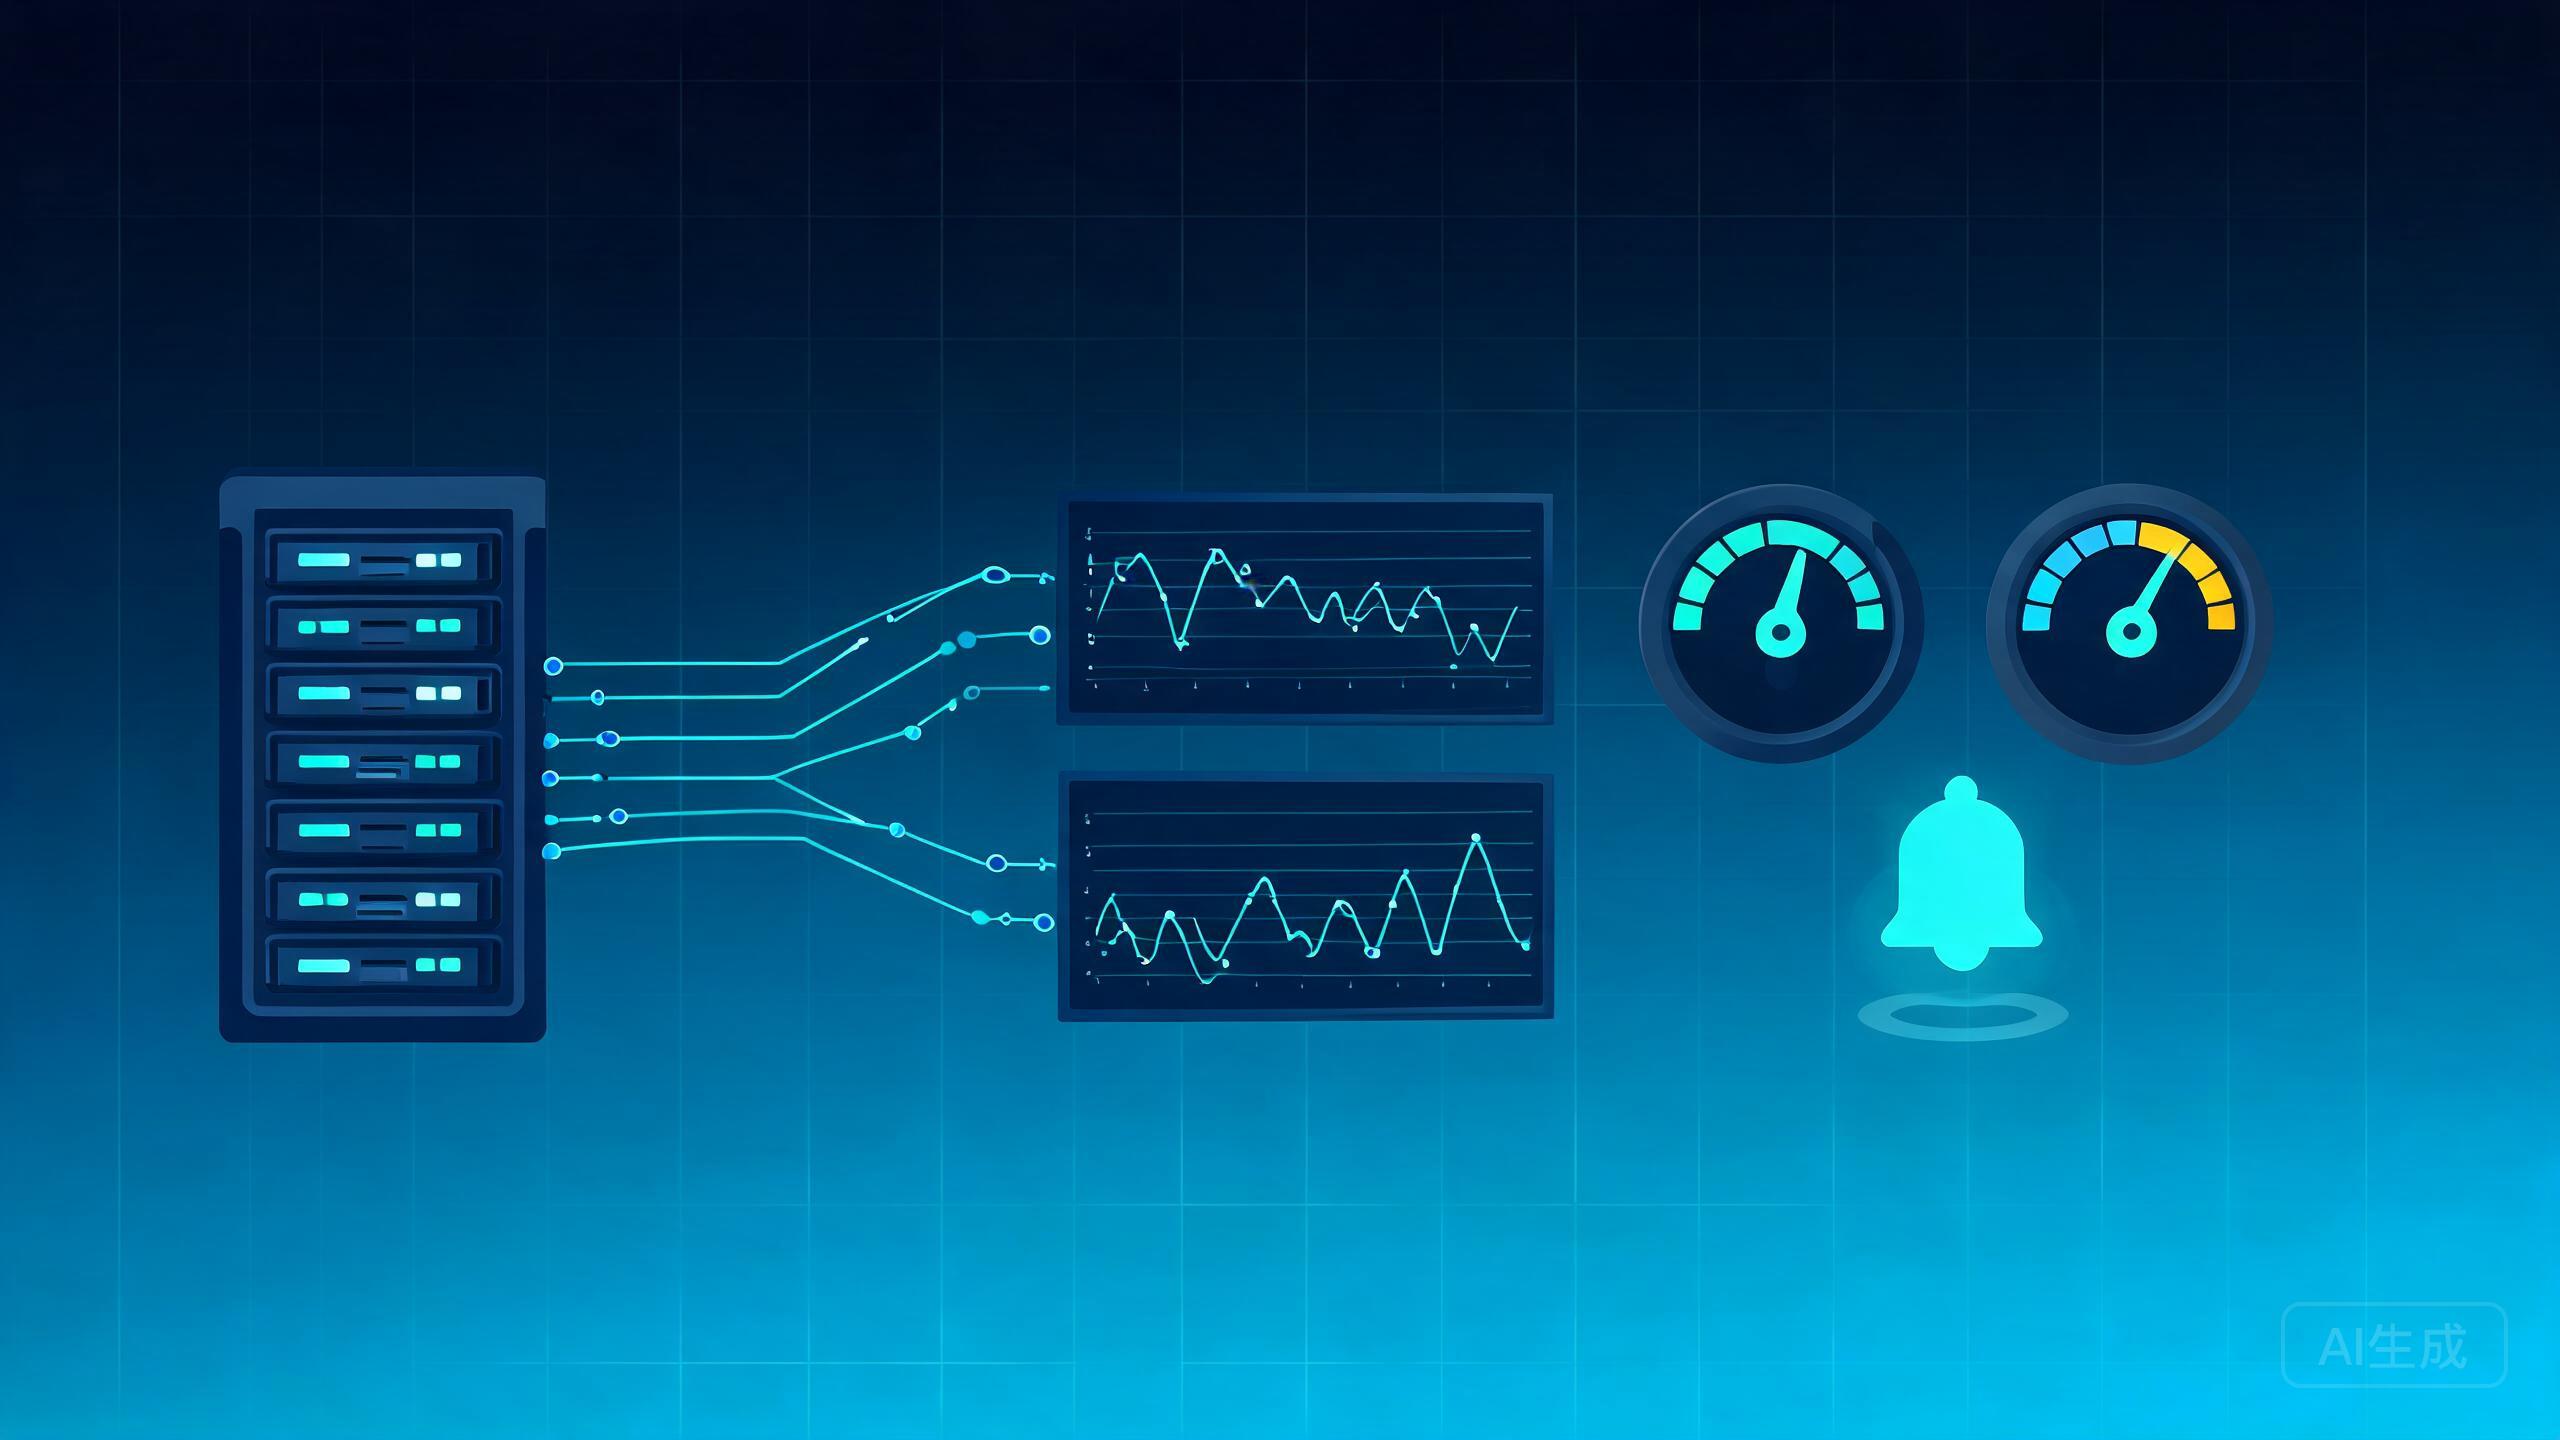
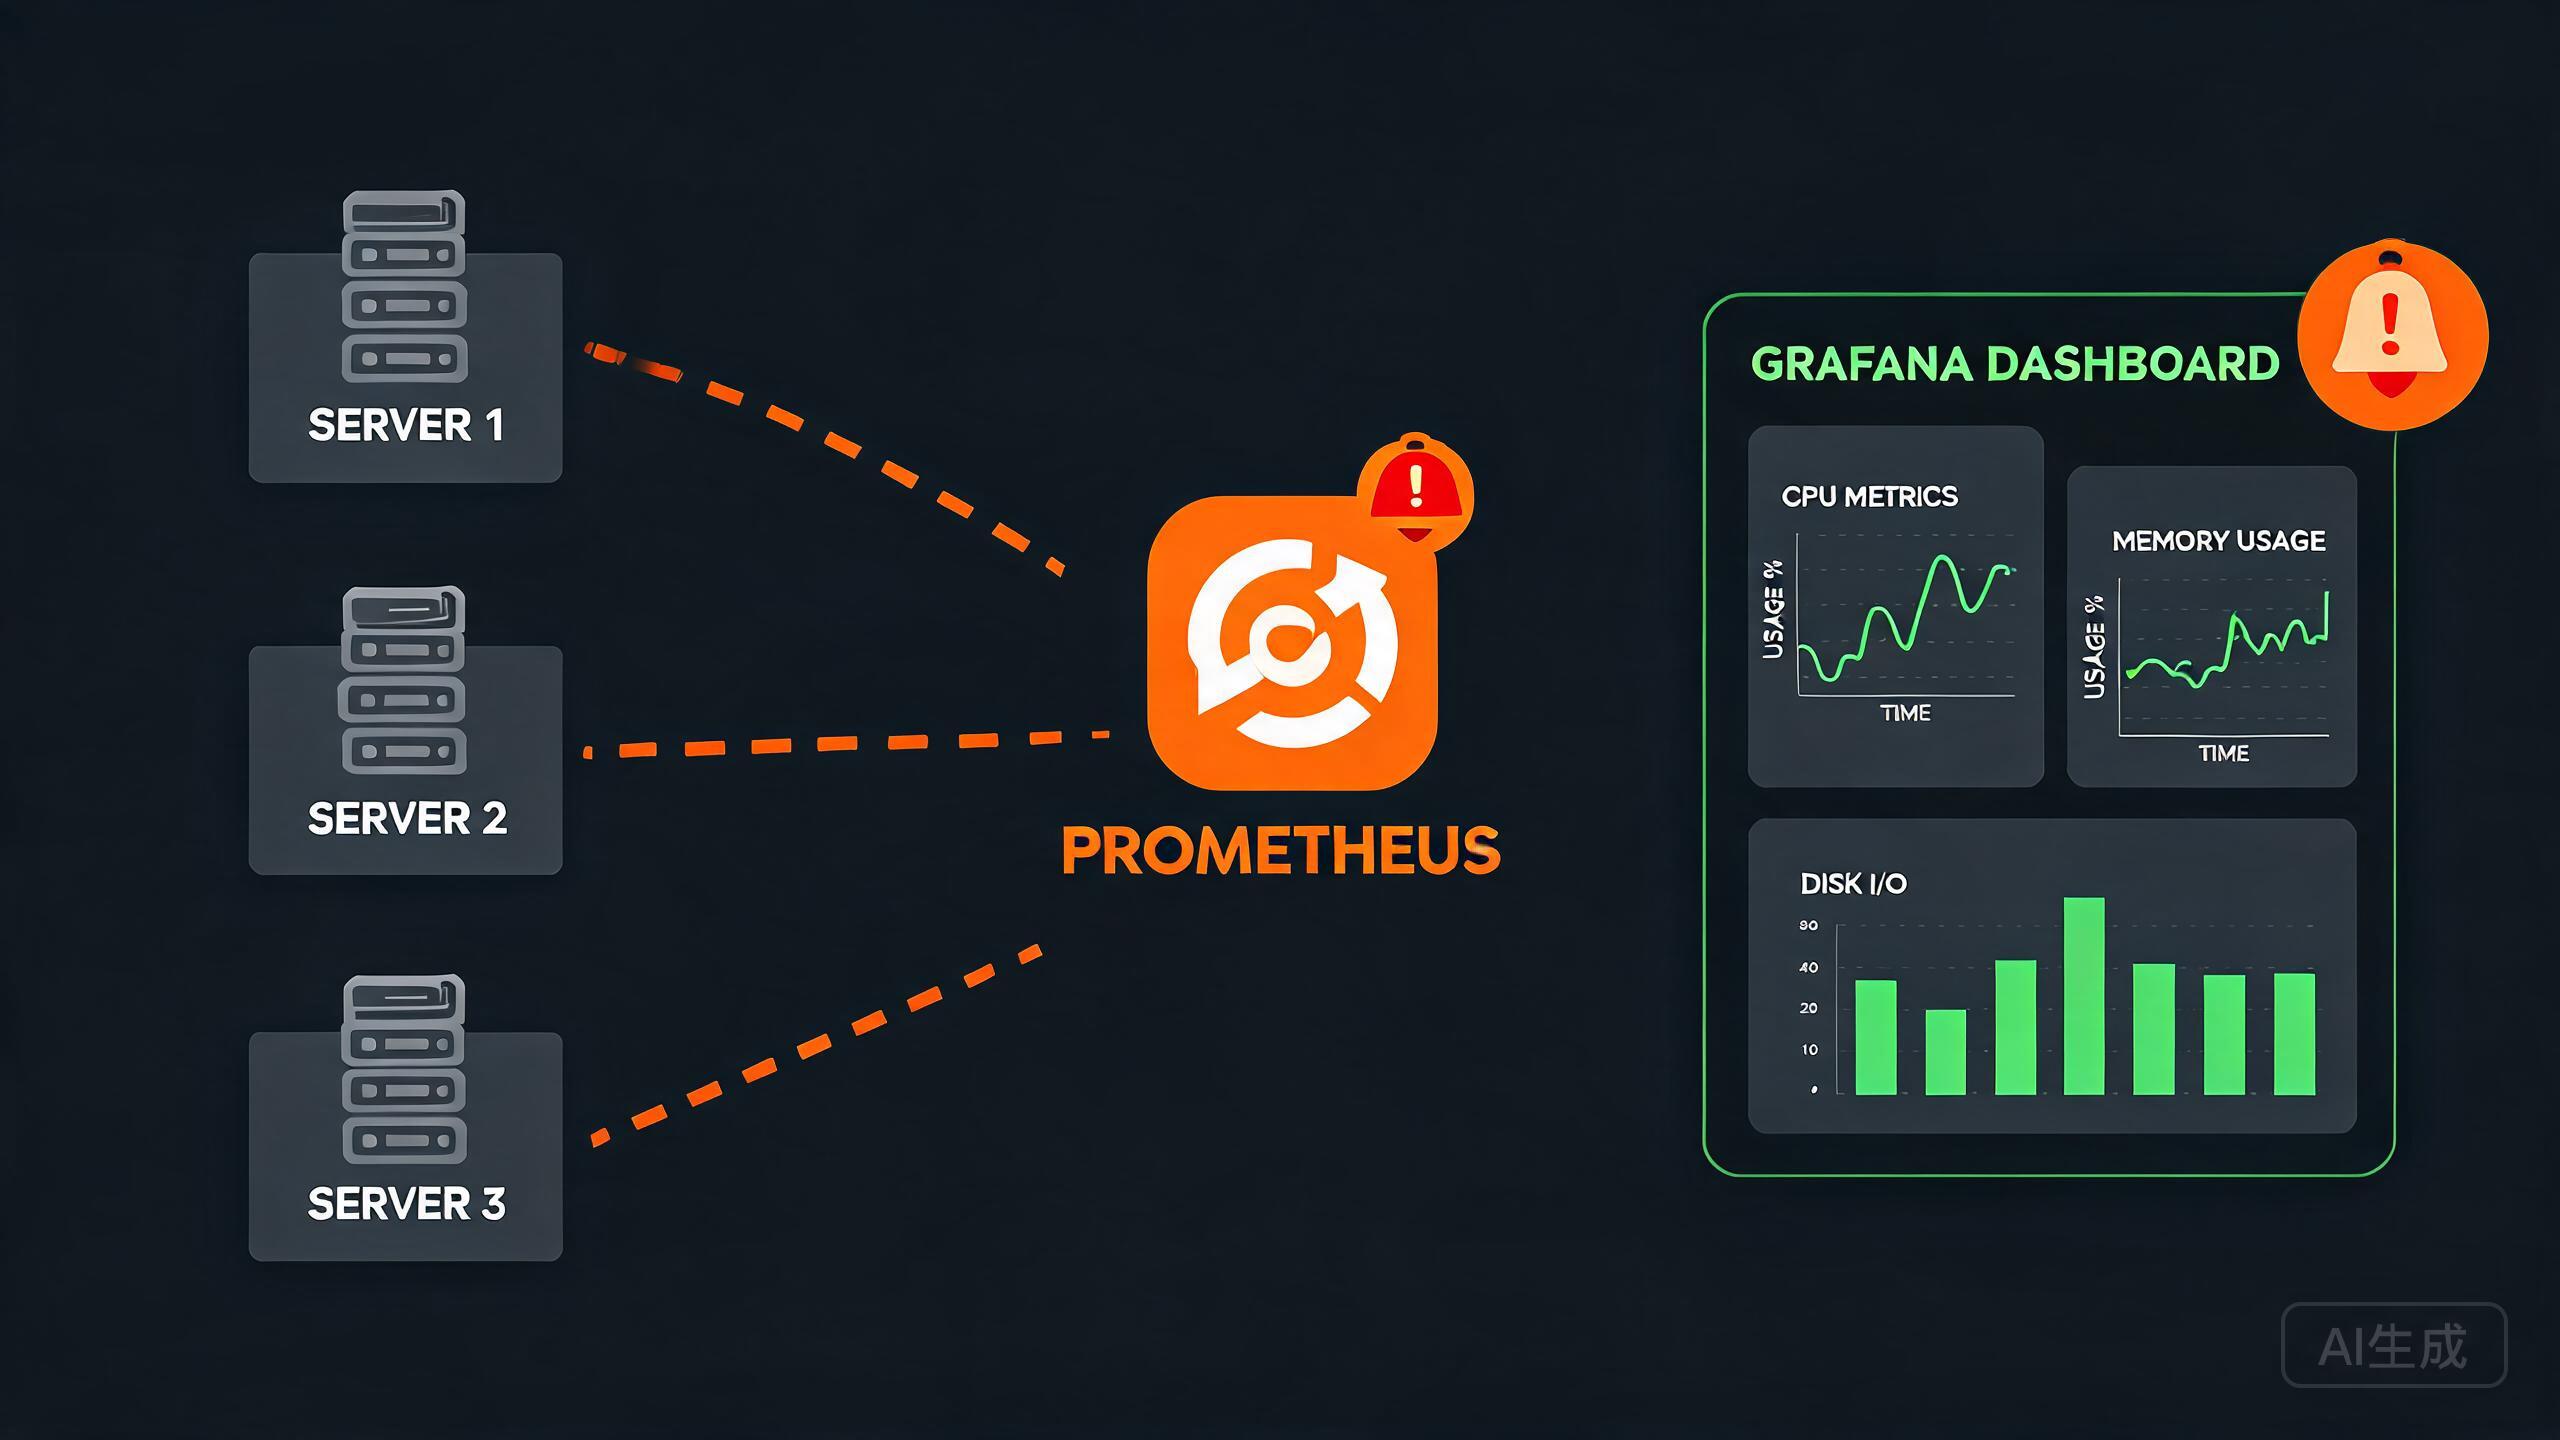
当一台自托管服务器上同时跑着系统指标(Prometheus)、应用日志(Loki)、数据库状态、甚至网页探活时,会冒出第二个麻烦:每个监控源都有自己的界面——CPU 要去这个面板看,日志要去那个页面翻,数据库状态又散布在第三个地方。零散、切来切去、对不上号。Grafana 的价值就是把这些不同来源的数据"拽到一张面板"统一可视化:定义数据源(Data Source),用同样的查询语言把指标、日志、业务统计放在同一块看板里散列、告警、关联。这篇讲清 Grafana 解决什么、怎么接多数据源、怎么把零散监控织成一张统一面板,以及资源与安全边界。
一、Grafana 解决什么:把"多个监控各看各的"变成"一块看板统揽"
自托管跑久了,各服务自带的监控会越来越多:系统层的 node_exporter、中间件的 exporter、日志的 Loki、数据库的指标…… 每个都有自己的查询入口和界面,出问题时你要开好几个页面、在心里把它们对起来。Grafana 就是那个"统一的可视化前端":它不自己存监控数据,而是通过"数据源"去连各处的数据库/时序库/日志库,再把查询结果用折线、柱状、表格、仪表盘(Gauge)组织到同一张 Dashboard 上。这样能做到"一个页面看懂整台机器 + 所有关键服务 + 出错点",并且同一套看板支持告警。
和自托管里别的可视化工具定位对比:Prometheus 管"采集与存储时序",Loki 管"存储与检索日志",而 Grafana 是"把这几类的查询结果统一画出来、并配置告警"的那一层。它不是又一个数据存储,而是"可视化 + 告警编排"的聚合层——这正是它设计上的价值:数据在哪不重要,重要的是你把它们汇总成一张能一眼看懂的作战图。
二、接多数据源:Prometheus、Loki、MySQL/探活 一处配置
Grafana 的多数据源能力是它区别于单点看板的根本。所谓数据源,就是"一个可被 Grafana 查询的后端",比如 Prometheus、Loki、InfluxDB、MySQL,乃至一个简单的 HTTP 探活接口。你在 Grafana 里为每个后端加一个数据源(填地址、凭证即可),之后在面板的每个 Panel 里选"用哪个数据源 + 查什么",就能在同一个 Dashboard 混排来自不同后端的指标与日志。这也是从"零散监控"升级为"统一监控"的关键一步:先把你要关注的每类数据都注册成数据源。
# 用 Docker 起 Grafana,接 Prometheus 与 Loki 两个数据源(已各有一个实例)
docker run -d --name grafana --restart unless-stopped \
  -p 127.0.0.1:3000:3000 \
  -e GF_SECURITY_ADMIN_PASSWORD="强密码" \
  -v /srv/grafana:/var/lib/grafana \
  grafana/grafana

# 在 Grafana UI 里添加数据源:
#   数据源 Prometheus:URL 填 http://prometheus:9090
#   数据源 Loki   :URL 填 http://loki:3100
# 之后新建 Dashboard,在一个 Panel 里:
#   - 用 Prometheus 查询:rate(node_cpu_seconds_total{mode="idle"}[5m])
#   - 用 Loki 查日志: {app="nginx"} |= "5\\d\\d"
多数据源的核心价值在于"关联观察":当页面 503 时,你可以在同一块看板上看到"CPU 是不是飙了(Prometheus)、这个 5xx 是否有对应日志(Loki)、数据库连接数是否打满(MySQL 数据源)"——把"发生了什么"与"为什么"放到同屏,排障速度会快一个量级。这正是用单点看板(各工具自带 UI)做不到的。
三、把零散监控织成一张统一面板:变量、下钻与告警
"统一面板"不等于把很多 Panel 简单堆在一起,而是有组织地编排。先用变量(Variables)把"同类但不同对象"做成下拉选择(如"选择哪个服务"),一个 Panel 就能覆盖所有服务;再用下钻把"总览 → 详情"串起来;最后给关键指标配告警(Alert),让 Grafana 在指标越界时通过邮件/Webhook 通知你。这样你的 Dashboard 从"一排排静态图"变成"一打开就能知道哪出了问题"的运维仪表盘。
# 用变量让一个 Panel 覆盖所有服务的请求量
# 变量 query:  label_values(http_requests_total, app)
# Panel 查询(PromQL):
# sum(rate(http_requests_total{app="$app"}[5m])) by (instance)

# 告警规则示意(PromQL-based alert):
# expr: rate(http_requests_total[5m]) == 0
# for: 5m        # 持续 5 分钟才触发,避免瞬时抖动误报
# 通知方式:可接邮件、Telegram、钉钉/飞书 Webhook 等
组织原则可概括为"先总览、再细分、能下钻、能告警":一屏总览看全机健康(CPU/内存/磁盘/流量),再按服务细分请求量、错误率、延迟,底层接日志能点进去看上下文,越界就告警。把零散来源"拉进来 + 组织好 + 配上告警",才能真正做到"有问题时不是靠你盯着,而是它自己来找你"。
四、常见坑:资源、数据源探活、时间对齐与正则迁移
统一面板做起来有四个高频坑。一是"资源与部署":Grafana 是长驻服务,规划好内存与磁盘;别让它和一堆数据源挤爆。二是"数据源探活":Grafana 靠 HTTP 去连各后端,网络不通、地址写错、凭证过期都会让 Panel 空转——先确认数据源"能连上"再谈面板好看,且密码/Token 按环境变量注入别硬编码。三是"时间对齐与采样":不同数据源的采集间隔、时区可能不同,做对比 Panel 时要把时间范围和步长对齐,否则 5 分钟步长 vs 30 秒步长画一起会错位。四是"改查询与迁移":换 Prometheus 版本、指标改名、加 label 都可能让旧 Panel 查空——把主要查询和变量定义为可复用、注释清楚,升级前先小范围验证。
# 数据源连通性排查思路(先确认这层再修面板):
#   curl http://prometheus:9090/api/v1/targets   # 看采集目标是否 up
#   curl http://loki:3100/ready                 # 看 Loki 是否就绪
# 再进 Grafana 的 Data Source 页面看每个源的「Save & Test」结果
把这套当排障 SOP:先"数据源能连吗",再"查询有数据吗(Panel 空往往是指标名/label 变了)",最后才看"面板是不是没对齐"。Grafana 的价值是聚合,而聚合的前提是每个源都被确认可靠——别在数据源都没打通时花时间美化面板。
五、边界:Grafana 是"看板和告警",不是"数据存储"也非"日志后端"
Grafana 的边界要认清:它不替代 Prometheus/Loki 做存储,也不替代数据库;一个 Grafana 宕了只是"看不了面板",真正做数据保护的是背后的时序库/日志库与它们的备份。其次,统一面板的"数据可信度"取决于各源的正确采集——数据源配置错、探活不准,统一出来的图反而是误导。最后是安全:Grafana 里常配数据库/云凭证,绑定好登录权限、HTTPS、并最小化暴露,别让一个可读监控面板变成泄露内部拓扑入口。
把 Grafana 放回自托管整体看:它是把"零散、各管各的监控源"汇总成一张作战地图的聚合层。落地要点:先把 Prometheus/Loki/MySQL 等后端都注册成数据源并确认能连;用变量、下钻与告警把面板从"陈列图"升级为"能发现问题并通知你的仪表盘";防住资源、数据源探活、时间对齐与升级迁移四坑;并认清它"只负责看与告警、数据靠背后组件与备份"的边界。当这套统一面板建好,你就能在出问题时一个页面看穿整台机器与关键服务,把"盯着监控"变成"监控自己来找你"。
结语
Grafana 统一监控面板的价值,是把分散在 Prometheus、Loki、数据库等各处的指标与日志,汇总到一张能一眼看懂、能下钻、能告警的作战图上。落地要点:把每个后端注册成数据源并先确认连通;用变量覆盖同类对象、用下钻串联总览与详情、给关键指标配告警;组织原则"先总览、再细分、能下钻、能告警";防住资源、探活、时间对齐与升级迁移四坑。边界认清它"不存数据、安全靠配置"——当你把多源数据真正织成一张可告警的统一面板,自托管的可观测性才算从"各家各看"升级为"一屏统揽、问题自报"。