服务器挂掉之前,通常不是突然砸下来的,而是一连串指标先变了:内存占用爬升、磁盘填满、请求响应变慢。问题是这些信号散落在十几台容器的日志和 top 里,没有一个人能同时盯着。Prometheus + Grafana 这套自托管监控栈解决的是"把服务器和容器的数百个指标统一收进来、画成图、越界就报警"这件事。下面把它从概念到告警落地讲清楚。
一、Pull 模型:监控不是"上报",而是"定时去拉"
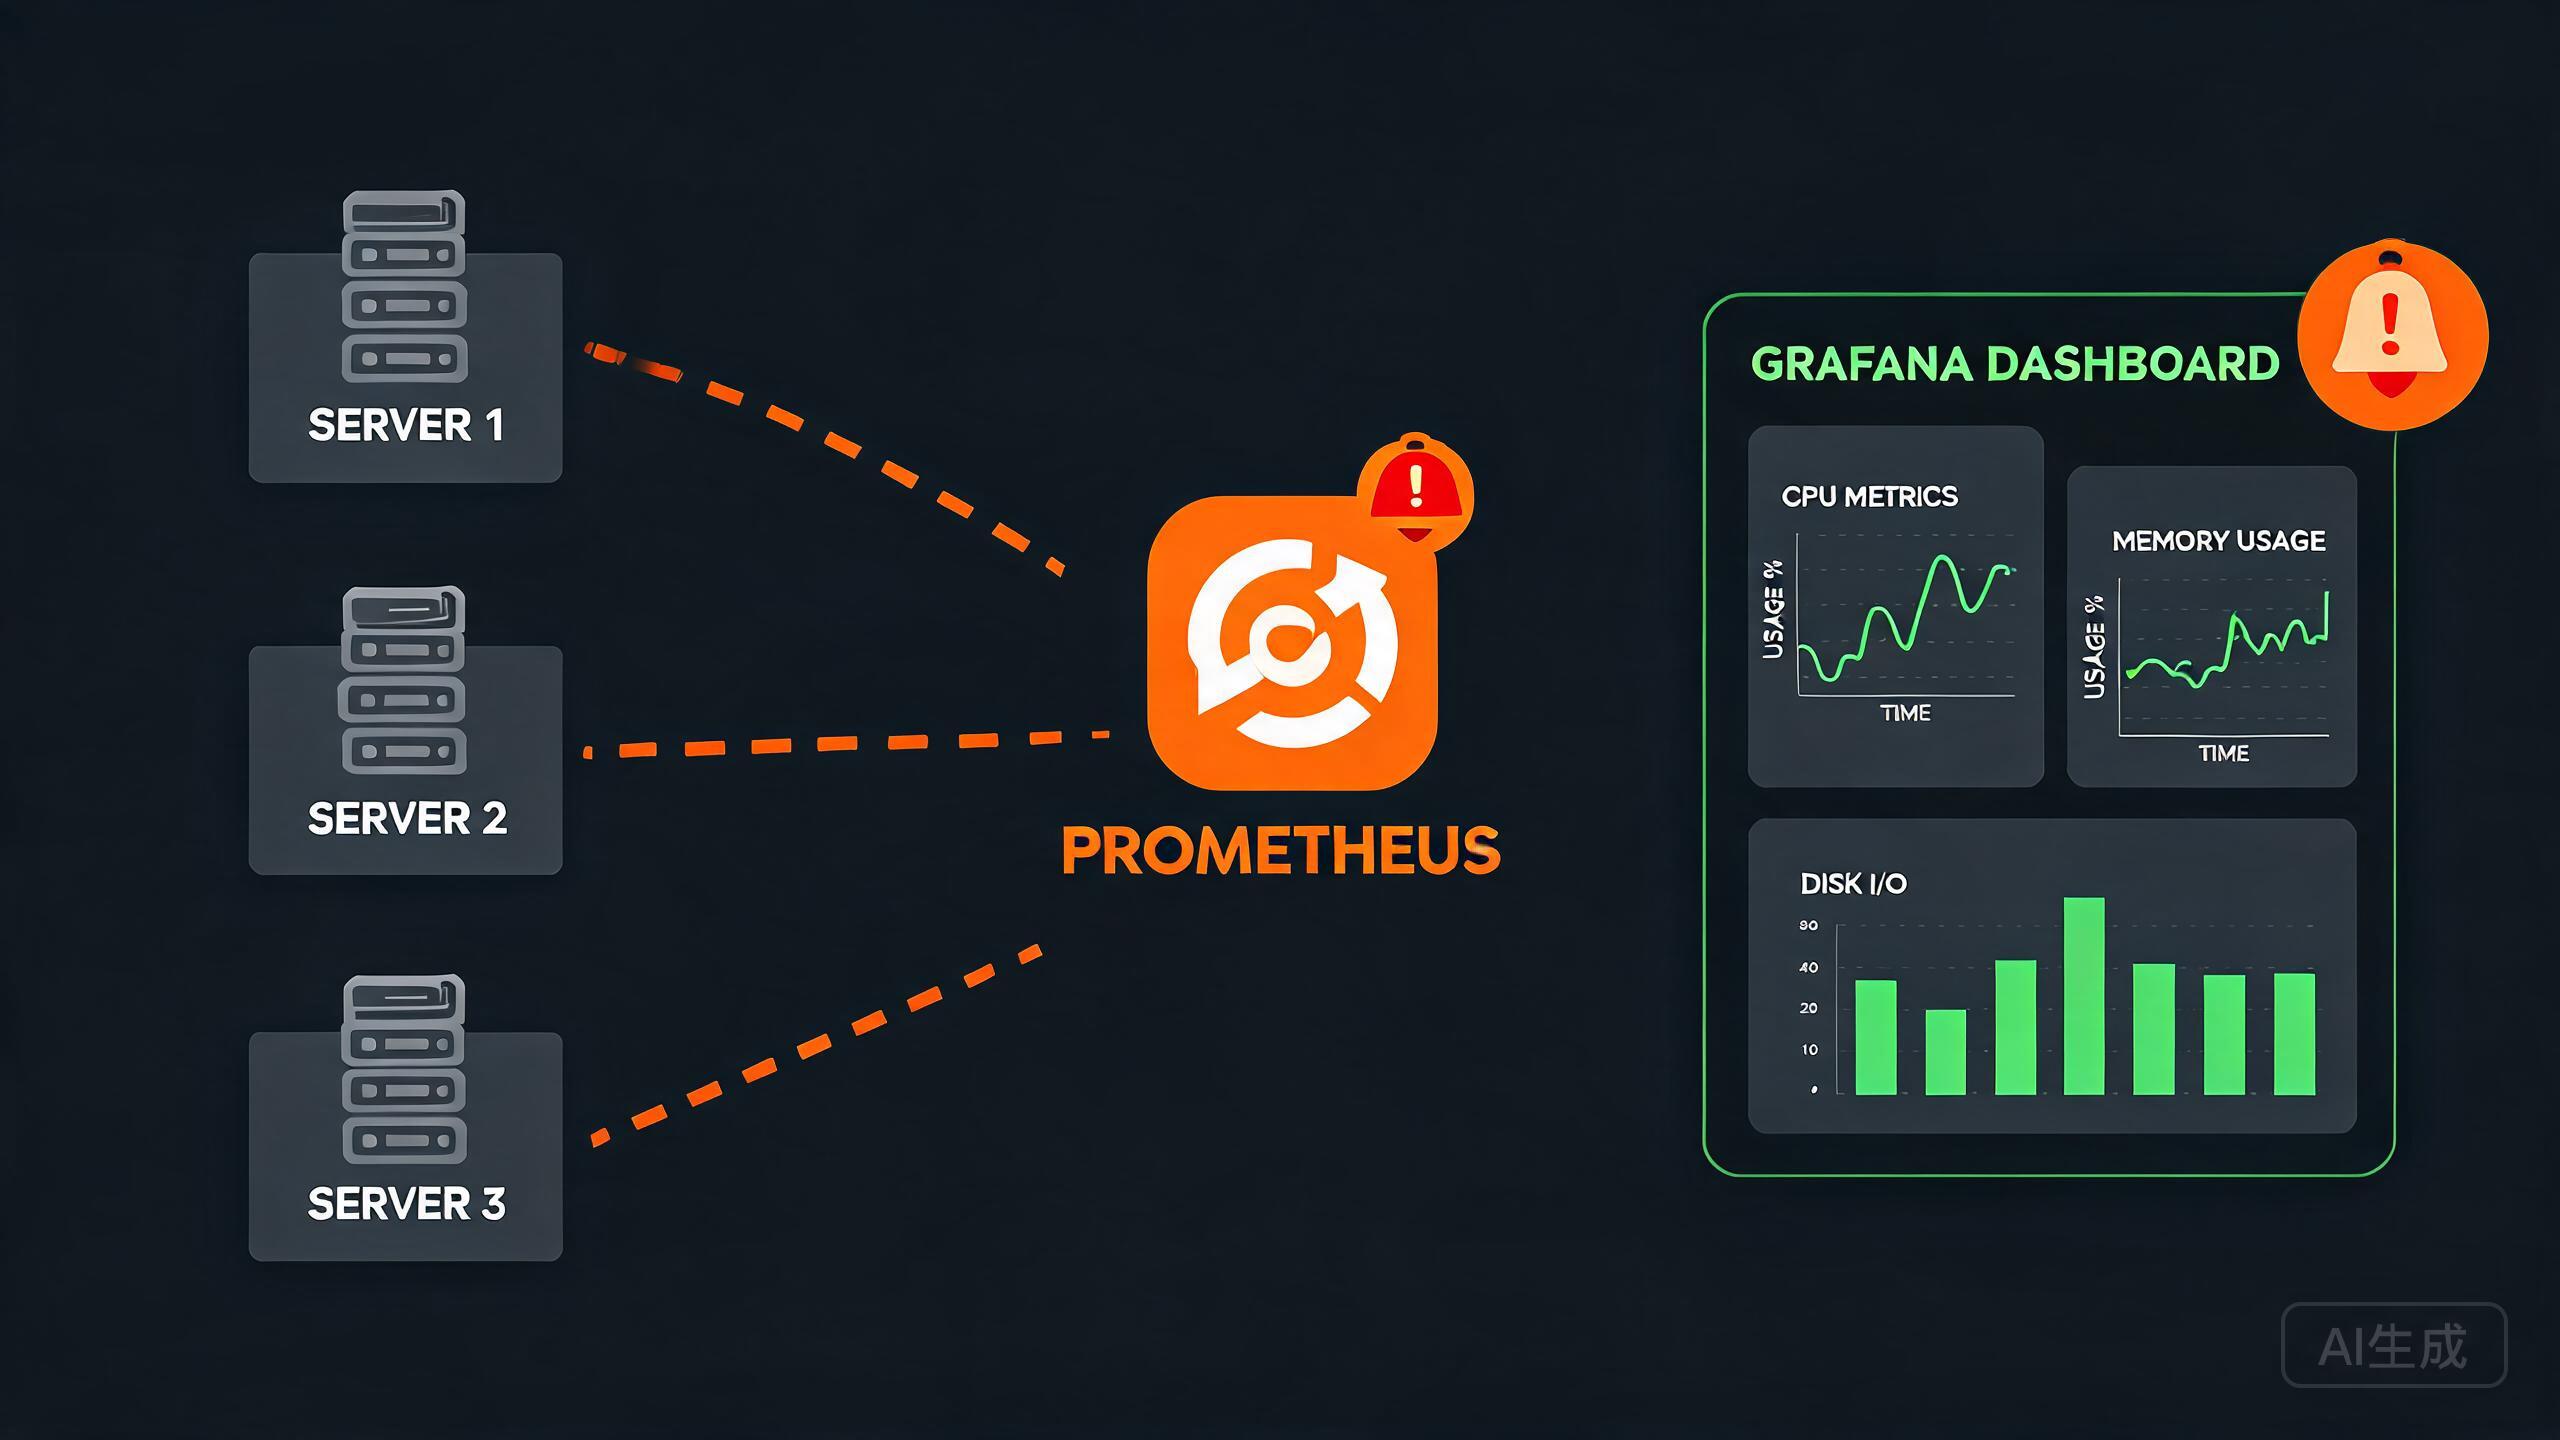
Prometheus 的核心设计是一条:监控端主动去拉指标,而不是让被监控对象推上来。它每隔固定间隔 scrape_interval 请求目标暴露的 /metrics 端点。这个取舍带来两层好处:一是被监控服务无需关心谁在看、何时看,只要被动暴露端点;二是谁挂了 Prometheus 一清二楚——拉不到就说明"目标才不在线"。被监控对象本身要有可拉取的能力,所以需要一个 exporter:一个把系统内部状态转换成 Prometheus 指标格式的轻量进程。
一台 Linux 主机配两个 exporter 就够覆盖九成需求:node_exporter 暴露 CPU、内存、磁盘、网络等主机指标;cAdvisor 由 Google 开箱在 Docker 里暴露每个容器的 CPU/内存带宽与网络累计量。把它们和 Prometheus 一起用 compose 编排:
services:
  prometheus:
    image: prom/prometheus:v2.53.2
    command:
      - --config.file=/etc/prometheus/prometheus.yml
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - prom_data:/prometheus
  node-exporter:
    image: prom/node-exporter:latest
    pid: host            # 读到宿主真实进程
    command: [ --path.procfs=/host/proc, --path.sysfs=/host/sys ]
    volumes: [ /proc:/host/proc:ro, /sys:/host/sys:ro ]
  cadvisor:
    image: gcr.io/cadvisor/cadvisor:latest
    volumes:
      - /:/rootfs:ro
      - /var/run:/var/run:ro
      - /sys:/sys:ro
      - /var/lib/docker/:/var/lib/docker:ro
    privileged: true     # cAdvisor 必须,指标换特权
volumes:
  prom_data: {}
抓取配置里把两个 exporter 和未来的黑盒探活目标都登记成 job,并加上 relabel_configs 传主机名做标签,方便之后按机器分组查询。
二、PromQL:用查询把"原始数字"变成"结论"
指标本身是每秒一飘的数字,真正有用的是把它们组合成"结论"。PromQL 的一点点语法就够用。查 CPU 使用率:100 - avg(rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100;查某容器内存占用:container_memory_usage_bytes{name=~".*freshrss.*"} / 1024 / 1024。几个要点:rate(x[5m]) 计算的是"过去 5 分钟的增长速率",更适合看变化的量;sum without / by 决定按哪个标签聚合;指标名后缀 _total 的计数器必须用 rate 才能反映真实使用强度。instant vector 是某一刻的值,range vector 是一段时间的序列,理解这两个类型对排查"为什么图上总是空的"很有用。
三、告警:Prometheus 只负责判断,Alertmanager 负责送
Prometheus 的 alerting_rules 只做一件事:表达式满足条件就触发一条告警。真正把告警送达(邮件、Telegram、钉钉、Webhook)的是 Alertmanager,它负责聚合、抑制、静默,避免一挂全挂时的告警风暴。先写规则:
groups:
  - name: host
    rules:
      - alert: HostHighCPU
        expr: 100 - avg(rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100 > 90
        for: 10m
        labels: { severity: warning }
        annotations:
          summary: "{{ $labels.instance }} CPU 超 90%"
      - alert: ContainerDown
        expr: up == 0
        for: 2m
        annotations: { summary: "{{ $labels.job }} 拉取失败" }
关键参数是 for:它要求条件连续满足一段时间才真正报警,能滤掉负载冲刺的假警。Alertmanager 通过 receiver 把告警投递到不同渠道,并按 severity 分发:warning 只发一个静默频道,critical 才发短信/电话,否则凌晨四点你会被一个可容忍的抖动吵醒。
四、Grafana:图表化与看板化那一层
Grafana 是坐在 Prometheus 前面的展示层,配置好它的数据源指向 Prometheus,就能把一个目标的值点成折线、仪表、热力图,并分享给其他人看。值得早点动手的是把"必看"场景做成看板:磁盘空间按天看增长斜率、单容器内存是否存在泄漏式爬升、站点可用性(配合 blackbox_exporter 探测网页/端口连通性)。别把看板堆成什么都有的大杂烩,每个看板回答一个明确问题,图太多反而没人看。Telegram 的通知里带上 Grafana 的告警图链接,能少开一堆终端。
五、存储与管理:指标也别丢
Prometheus 自带本地时间序列存储,但它是单机、受磁盘约束的。单机场景最该做的是落盘到命名卷并设好保留期(--storage.tsdb.retention.time),同时做好备份,否则你花力气搭的这套监控在硬盘故障时跟着一起没了。指标数据是"时间敏感"的,历史越久体积越大,一般保留 15–30 天足够排障,更长历史交给 Thanos/Cortex 这类远端方案,不必在单机上无限堆。
结语
监控栈投入的核心不是"多一个漂亮的仪表盘",而是把"服务器到底怎么了"变成可回答的问题:磁盘哪块在涨、哪个容器在漏内存、哪个站点对外面已经不可用。Prometheus 的 Pull 模型、PromQL 的表达力、Alertmanager 的分发,这三件套把"看与报"从手工巡检变成自动巡航。搭好之后,你第一次真正相信:出问题时不是它先找上你,而是我先知道。