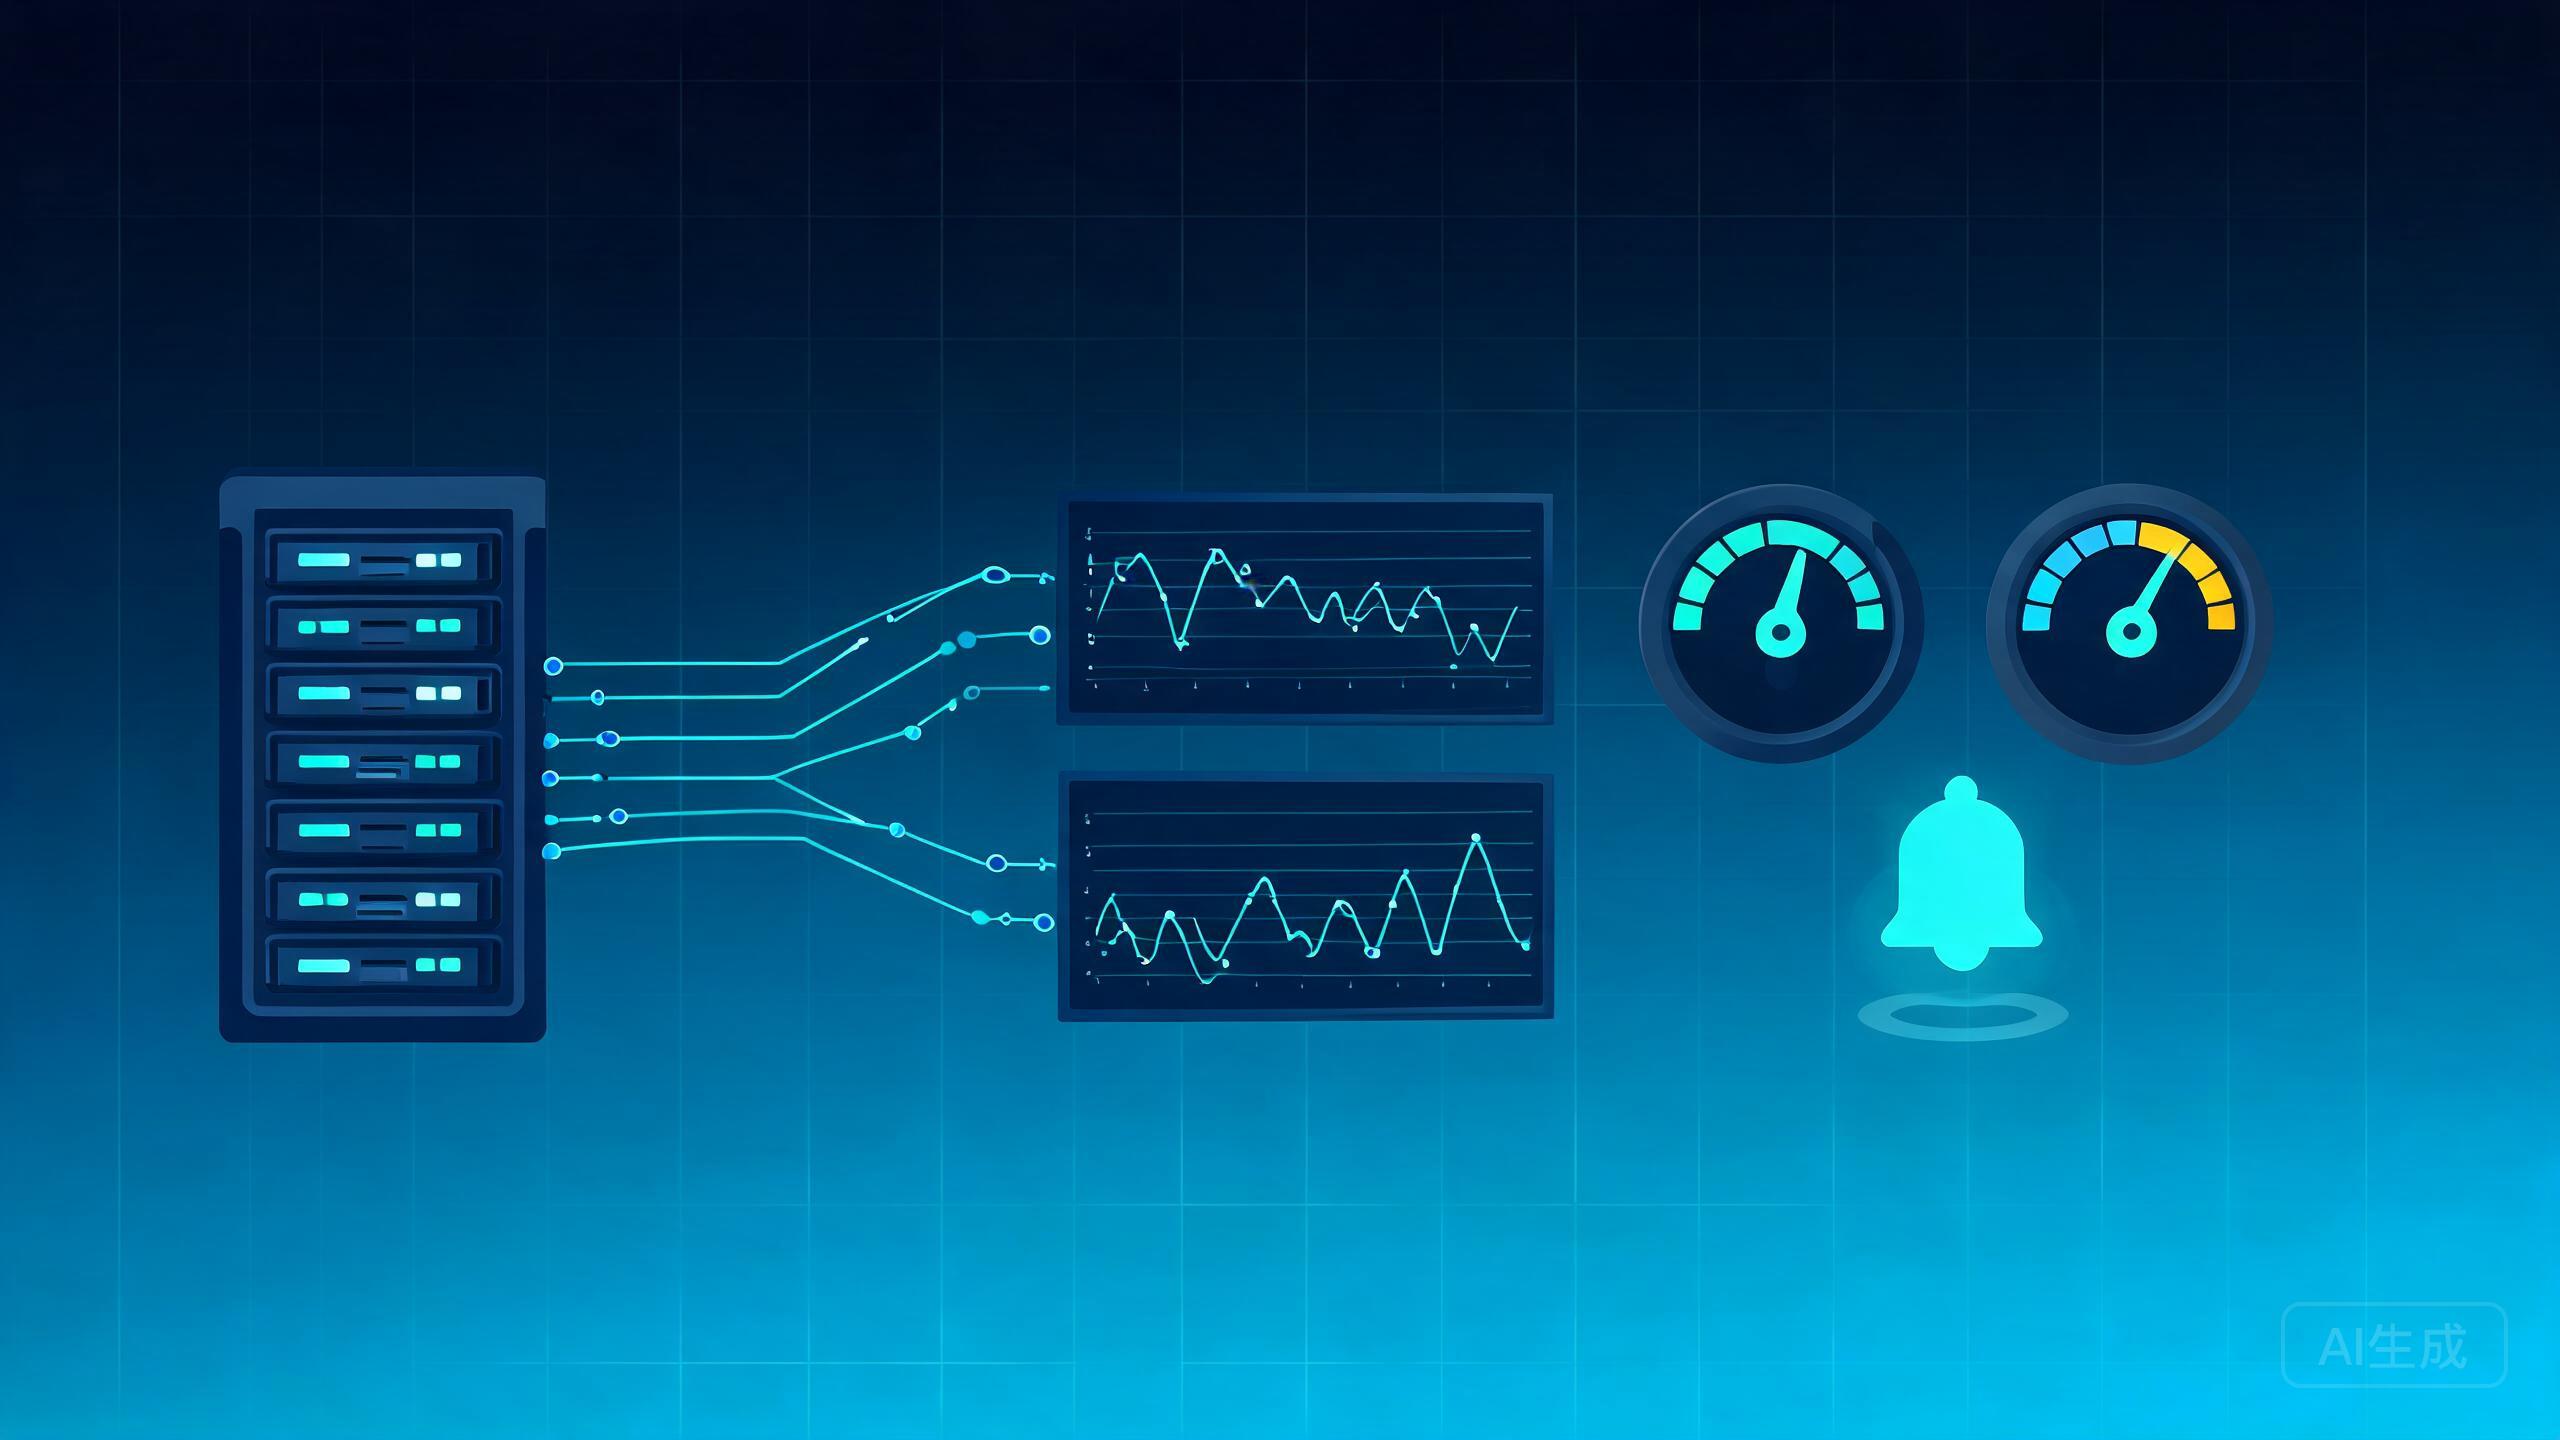
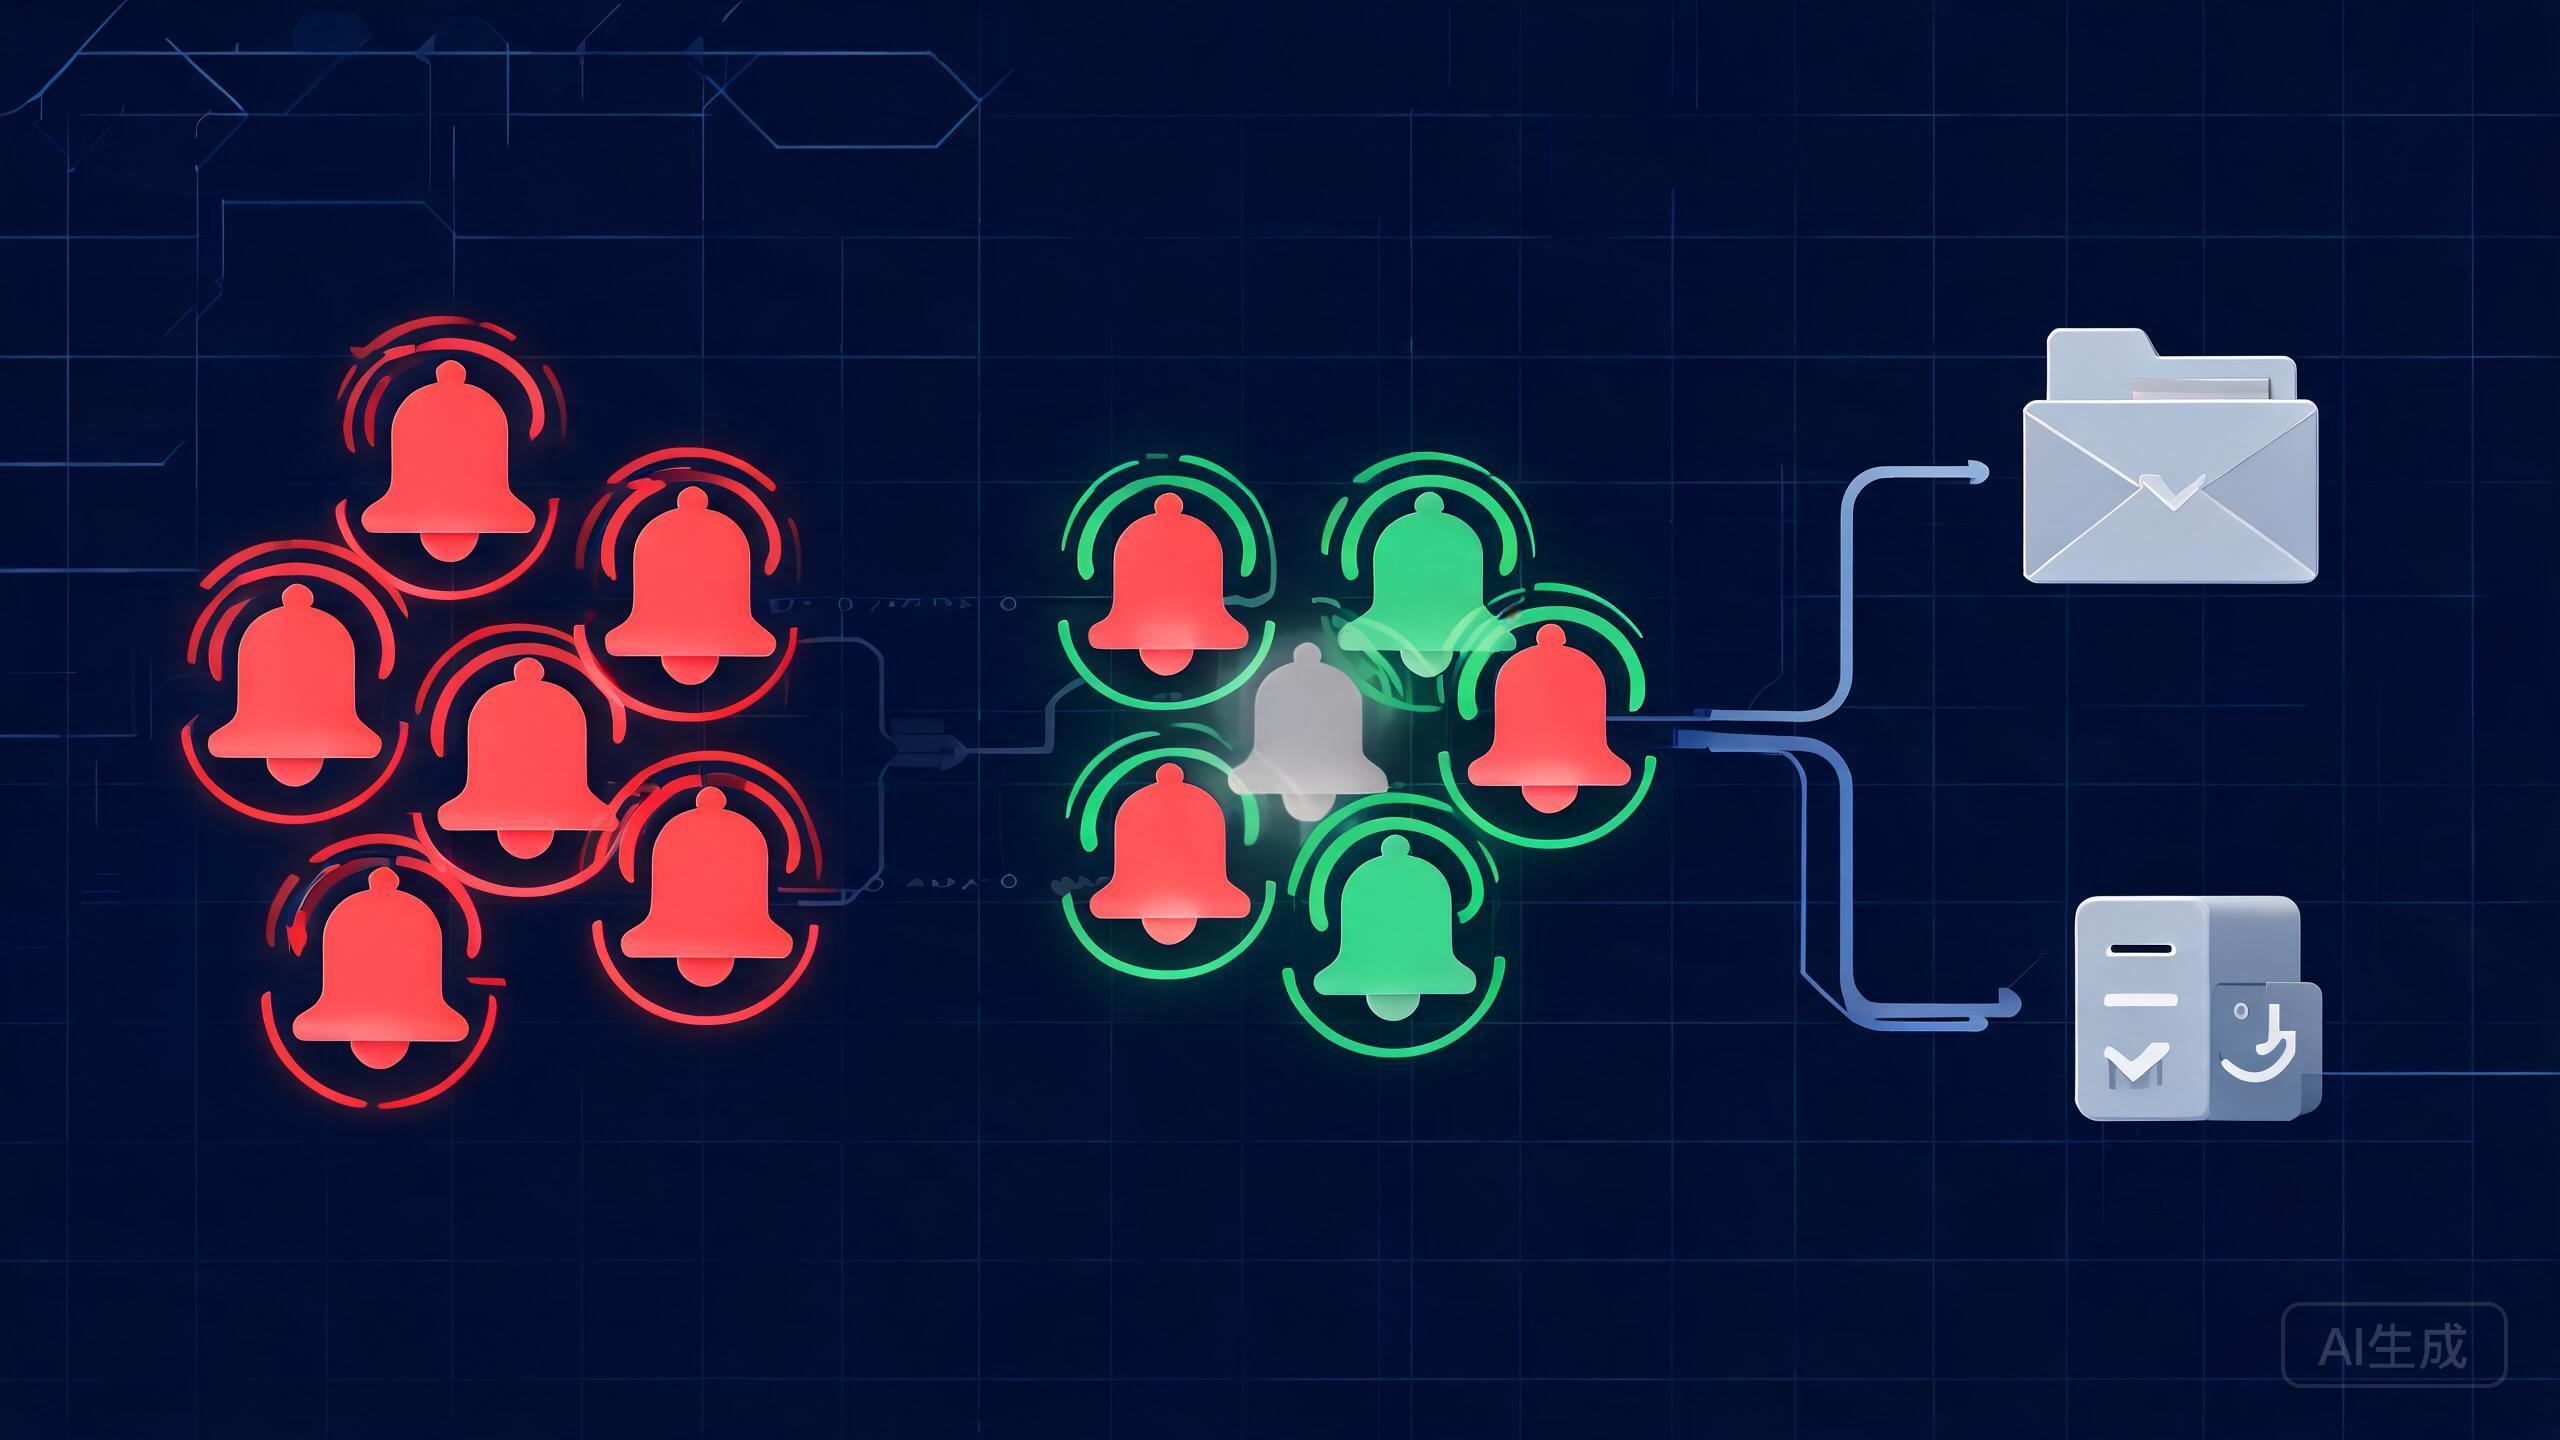
自托管最阴险的事故,不是报错,而是"机器其实已经病了,但没人发现"。磁盘悄悄写满、内存被某个进程吃光、某个服务从昨晚起就不通了——等到用户叫起来才去查,往往已经晚了。Prometheus + Grafana 这套组合解决的正是"尽早、主动地看见这台机器的状态":Prometheus 负责定期去"抓取"各种指标并存储成时间序列,Grafana 把指标画成面板,Alertmanager 在达到阈值时把告警推给你。这篇讲清这套监控栈的架构、怎么用 exporter 采集、怎么写查询与告警规则,以及一个容易被忽略的"自托管监控到底在监控什么"的问题。
一、Prometheus 的模型:拉取式指标收集 + 时间序列
监控怎么拿到数据,行业内其实分两派。一派是"推送式"(比如 Zabbix 早期、或者各种 agent 主动上报),另一派就是 Prometheus 坚持的"拉取式":Prometheus 每隔一段时间(默认 15 秒)主动去问每一个被监控对象"你现在的指标是多少"。被监控对象只要暴露一个 HTTP 地址,输出一段固定格式的指标文本,Prometheus 就能抓走并按"指标名 + 标签"存成时间序列。
这个模型带来几个好处。一是"被监控方极其轻"——它不需要装一个复杂的 client 主动上报的守进程,只要暴露一个很小的指标端点;二是"抓到哪去了"握在自己手里——Prometheus 是按它自己的时序(scrape)去采,谁挂了它会因为抓不到而立刻暴露;三是时间序列的写法统一,所有指标都是"名字 + 键值标签",查询语言也由此统一。缺点也要知道:拉取式对"防火墙后面的内网、临时不固定 IP 的目标"比较别扭,这类场景才需要额外的 push gateway 或监控代理来中转。
二、最小架构:Prometheus + 节点 exporters + Grafana
自托管最常见的起步是一组清晰的三件套:一台(或一台服务器里)跑 Prometheus 本身;被监控的每台机器上跑一个很小的"节点导出器(node_exporter)",把 CPU、内存、磁盘、网络这些系统指标暴露出来;Grafana 负责把这个 Prometheus 当作数据源,展示面板。先给一套 Docker 起三个服务的模板:
# docker-compose.yml
version: "3"
services:
  prometheus:
    image: prom/prometheus
    ports: ["9090:9090"]
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - ./prom-data:/prometheus
  node-exporter:
    image: prom/node-exporter      # 采集宿主机系统指标
    pid: host
    network_mode: host
  grafana:
    image: grafana/grafana:latest
    ports: ["3000:3000"]
    environment:
      - GF_SECURITY_ADMIN_PASSWORD=改这里
    volumes:
      - ./grafana-data:/var/lib/grafana
# prometheus.yml:告诉 Prometheus 去抓谁
global:
scrape_interval: 15s # 每 15 秒抓一次
scrape_configs:
- job_name: "node"
static_configs:
- targets: ["你的服务器IP:9100"] # node_exporter 的地址起起来之后,用浏览器看 Prometheus 的 /targets 页面能看到所有被抓对象及健康状态,在 /graph 里能直接写 PromQL 查询指标。Grafana 登录后会让你加数据源(选 Prometheus,填它的地址),然后就能从官方/社区"仪表盘库"或自己画面板。特要说一句:把 Grafana 和 Alertmanager 端口关在公网后面,前面加前面的反代 + 认证那一层,别让监控后台裸奔。
三、告警才是灵魂:Alertmanager 把"阈值"变成"通知"
光有面板还不够,因为人不会一直盯着屏幕。Prometheus 的告警链路由两部分组成:规则(recording/alert 规则)在 Prometheus 里判断"指标满足某条件就产生告警事件",然后把告警交给 Alertmanager——它负责"去重、分组、抑制、路由",并按你的规则把通知发到邮箱、钉钉/飞书 webhook、Slack 等。先看最核心的告警规则文件:
# alert_rules.yml:被 prometheus.yml 用 rule_files 引用
groups:
  - name: host_alerts
    rules:
      - alert: 磁盘快满
        expr: node_filesystem_avail_bytes{fstype!~"tmpfs|overlay"} / \
              node_filesystem_size_bytes{fstype!~"tmpfs|overlay"} < 0.1
        for: 5m                 # 持续 5 分钟才触发,避免偶发抖动误报
        labels:
          severity: warning
        annotations:
          summary: "{{ $labels.mountpoint }} 磁盘使用率超过 90%"
      - alert: 节点宕机
        expr: up == 0
        for: 2m
        labels: { severity: critical }
        annotations: { summary: "{{ $labels.instance }} 已失联超过 2 分钟" }
这里两行值得反复体会。一是 `for: 5m` 这种"持续了一定时间才告警"的机制,能滤掉大量瞬时抖动;二是 `expr` 里写的 PromQL 就是你判断异常的判据。写规则的核心是"宁可少一点精的,不要一堆误报的"——告警疲劳会让真的第三优先级告警被忽略。用 Alertmanager 的分组来合并同类告警,用 route 按严重度路由到不同通知渠道。
四、PromQL:读指标的语法,两三句话讲透
你不需要数学式的精通 PromQL,但读懂最常用的几个模式就够了。基本形态是 `指标名{标签过滤器}` 选出一组时间序列,然后可以加函数或运算:
# 看单台机器的 CPU 使用率(减去空闲率)
100 - (avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100)

# 看内存使用量(已用 / 总量)
node_memory_MemTotal_bytes - node_memory_MemAvailable_bytes

# 看"过去 5 分钟每秒新增的网络字节数"(rate 把累计计数器变成速率)
rate(node_network_receive_bytes_total[5m])

# 看某个指标最高的是谁(topk 思路)
topk(5, node_load1)
几个关键约定记牢就能事半功倍:计数器类指标(`_total` 结尾,如字节、请求数、包数)要总是配 `rate[窗口]` 转成"每秒速率"才有意义;`{标签="值"}` 用来过滤,`by (标签)` 用来分组聚合;`up` 内置指标表示"这个被监控对象现在还抓不抓得到"。会这三个模式,日常排查 90% 的指标查询都能搞定。
五、别把监控变成"监控的堆叠":先想清监控什么
自托管最容易犯的错不是配置错,而是"监控了一切却什么都没监控到"。把所有 exporter 堆上去、把告警开到震天响,结果一是资源被无谓消耗,二是真正要命的问题被淹没。更务实的原则是"自顶向下分层想清楚":先盯"这台机器还活着吗、磁盘内存要不要爆"这类生存指标,再盯"核心服务(数据库、反代、应用)还回不回应"这类可用性,最后才是业务层面的运行指标。逐层补齐,而不是一上来就抓最底层的千条指标。
另一个容易被忽视的坑是把 Prometheus 的存储不当回事。Prometheus 本地存储按配置保留期限(默认 15 天),指标越多吃得越多,磁盘要留够余量、配合批量清理;想要更长周期的历史归档,再把数据对接到对象存储/长期存储,而不是无限加大保留期硬扛。最后,也是前面反复出现的原则——监控本身要有"冗余":至少让 Prometheus + Grafana 有基本的可靠性,因为"监控挂了你不知道系统快出事了"是最讽刺的事故。
结语
Prometheus + Grafana + Alertmanager 的真正价值,是把"靠人肉发现故障"变成"机器持续盯着、到阈值就主动喊你"。落地要点:用 node_exporter + Prometheus 采集和存储系统指标,用 Grafana 画板,用 Alertmanager 把"算出来的异常"路由成通知;会用 `rate[窗口]`、`up` 和 `for` 约束这三四个模式就够了;最关键的是自顶向下想清楚"该监控什么",并给告警留抑制和分组避免疲劳。当你把"磁盘快满""节点失联""核心服务不回"这几个告警真正配起来之后,这台机器的可靠性就上了一个台阶——你终于是在故障发生前就收到提醒,而不是等它变成事故才半夜起来救火。