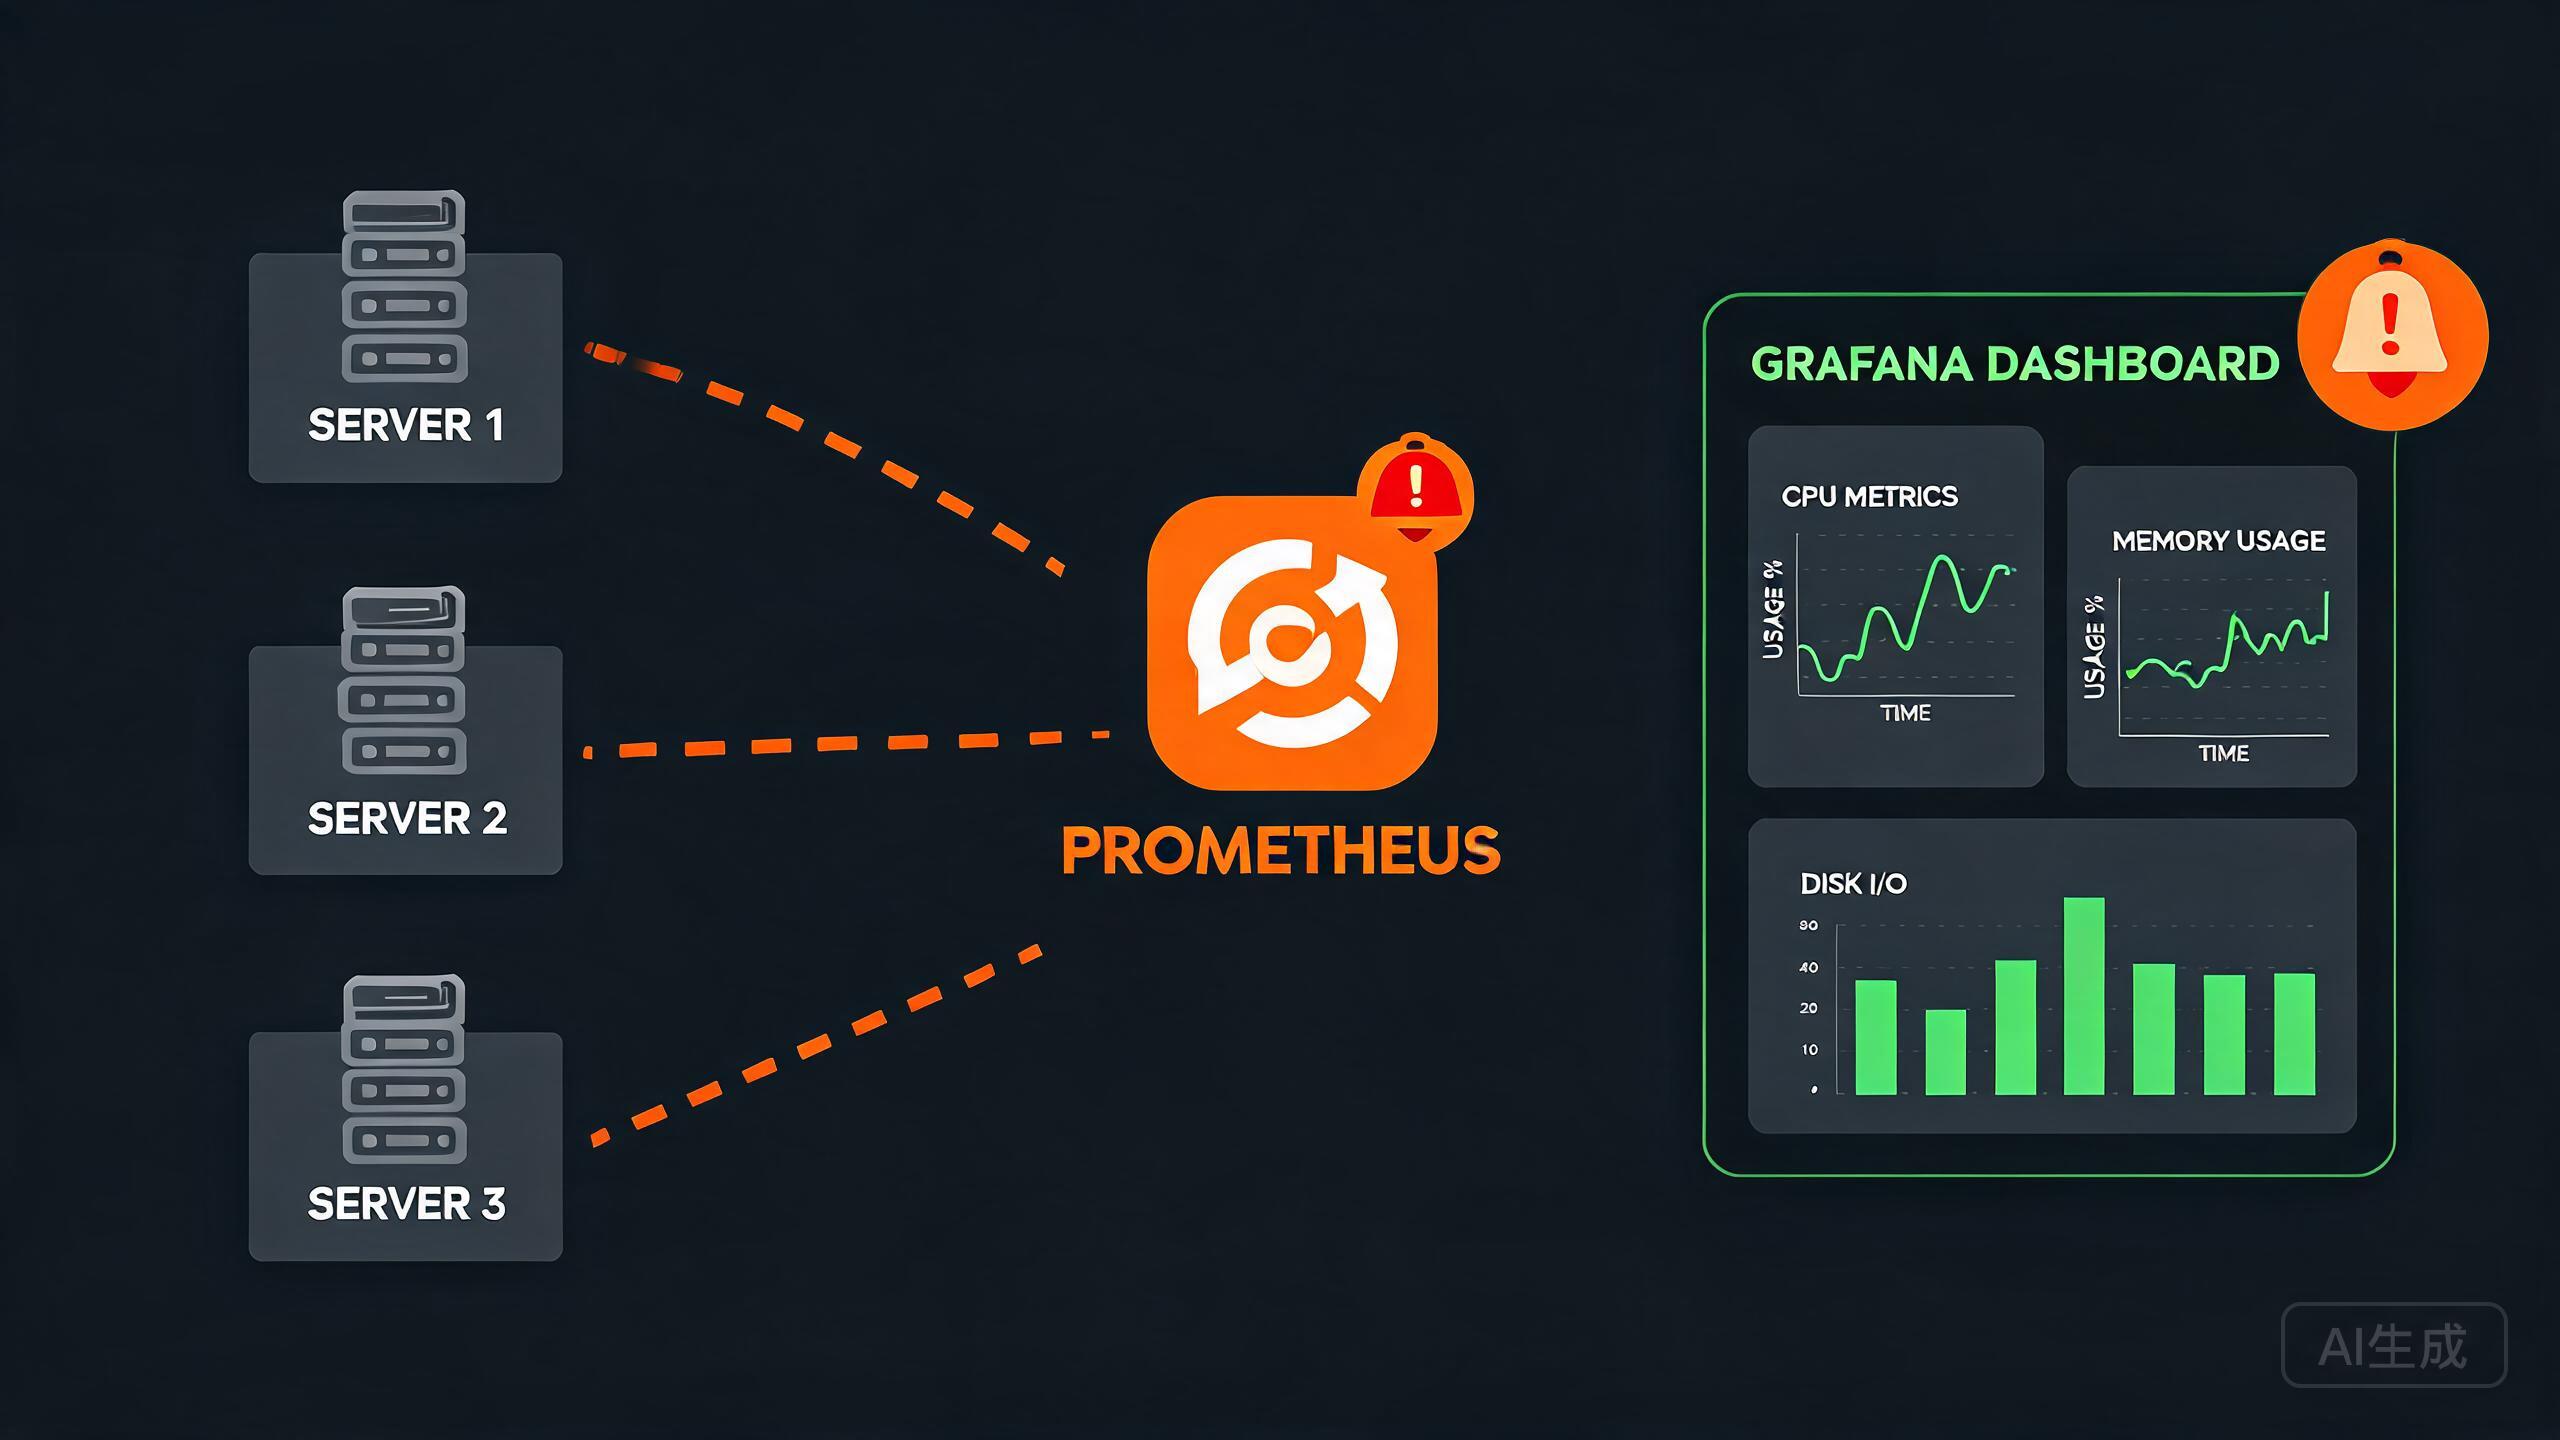
监控搭好后,下一个难题往往不是"有没有告警",而是"告警太吵":同一个故障触发十几条、半夜被无关告警轰炸、关键告警被埋在一堆杂讯里没人看。Prometheus + Alertmanager 是自托管可观测性里最主流的告警落地:Prometheus 负责按规则算出"该报警",Alertmanager 负责把它们"分组、去重、抑制、路由、转发"给合适的通知渠道。这篇讲清告警降噪解决什么、Alertmanager 的分组/抑制/路由怎么配、Prometheus 规则怎么写、以及它与死信/静默的边界。
一、告警降噪解决什么:把"洪水般的事件"收敛成"有人说人话的关键通知"
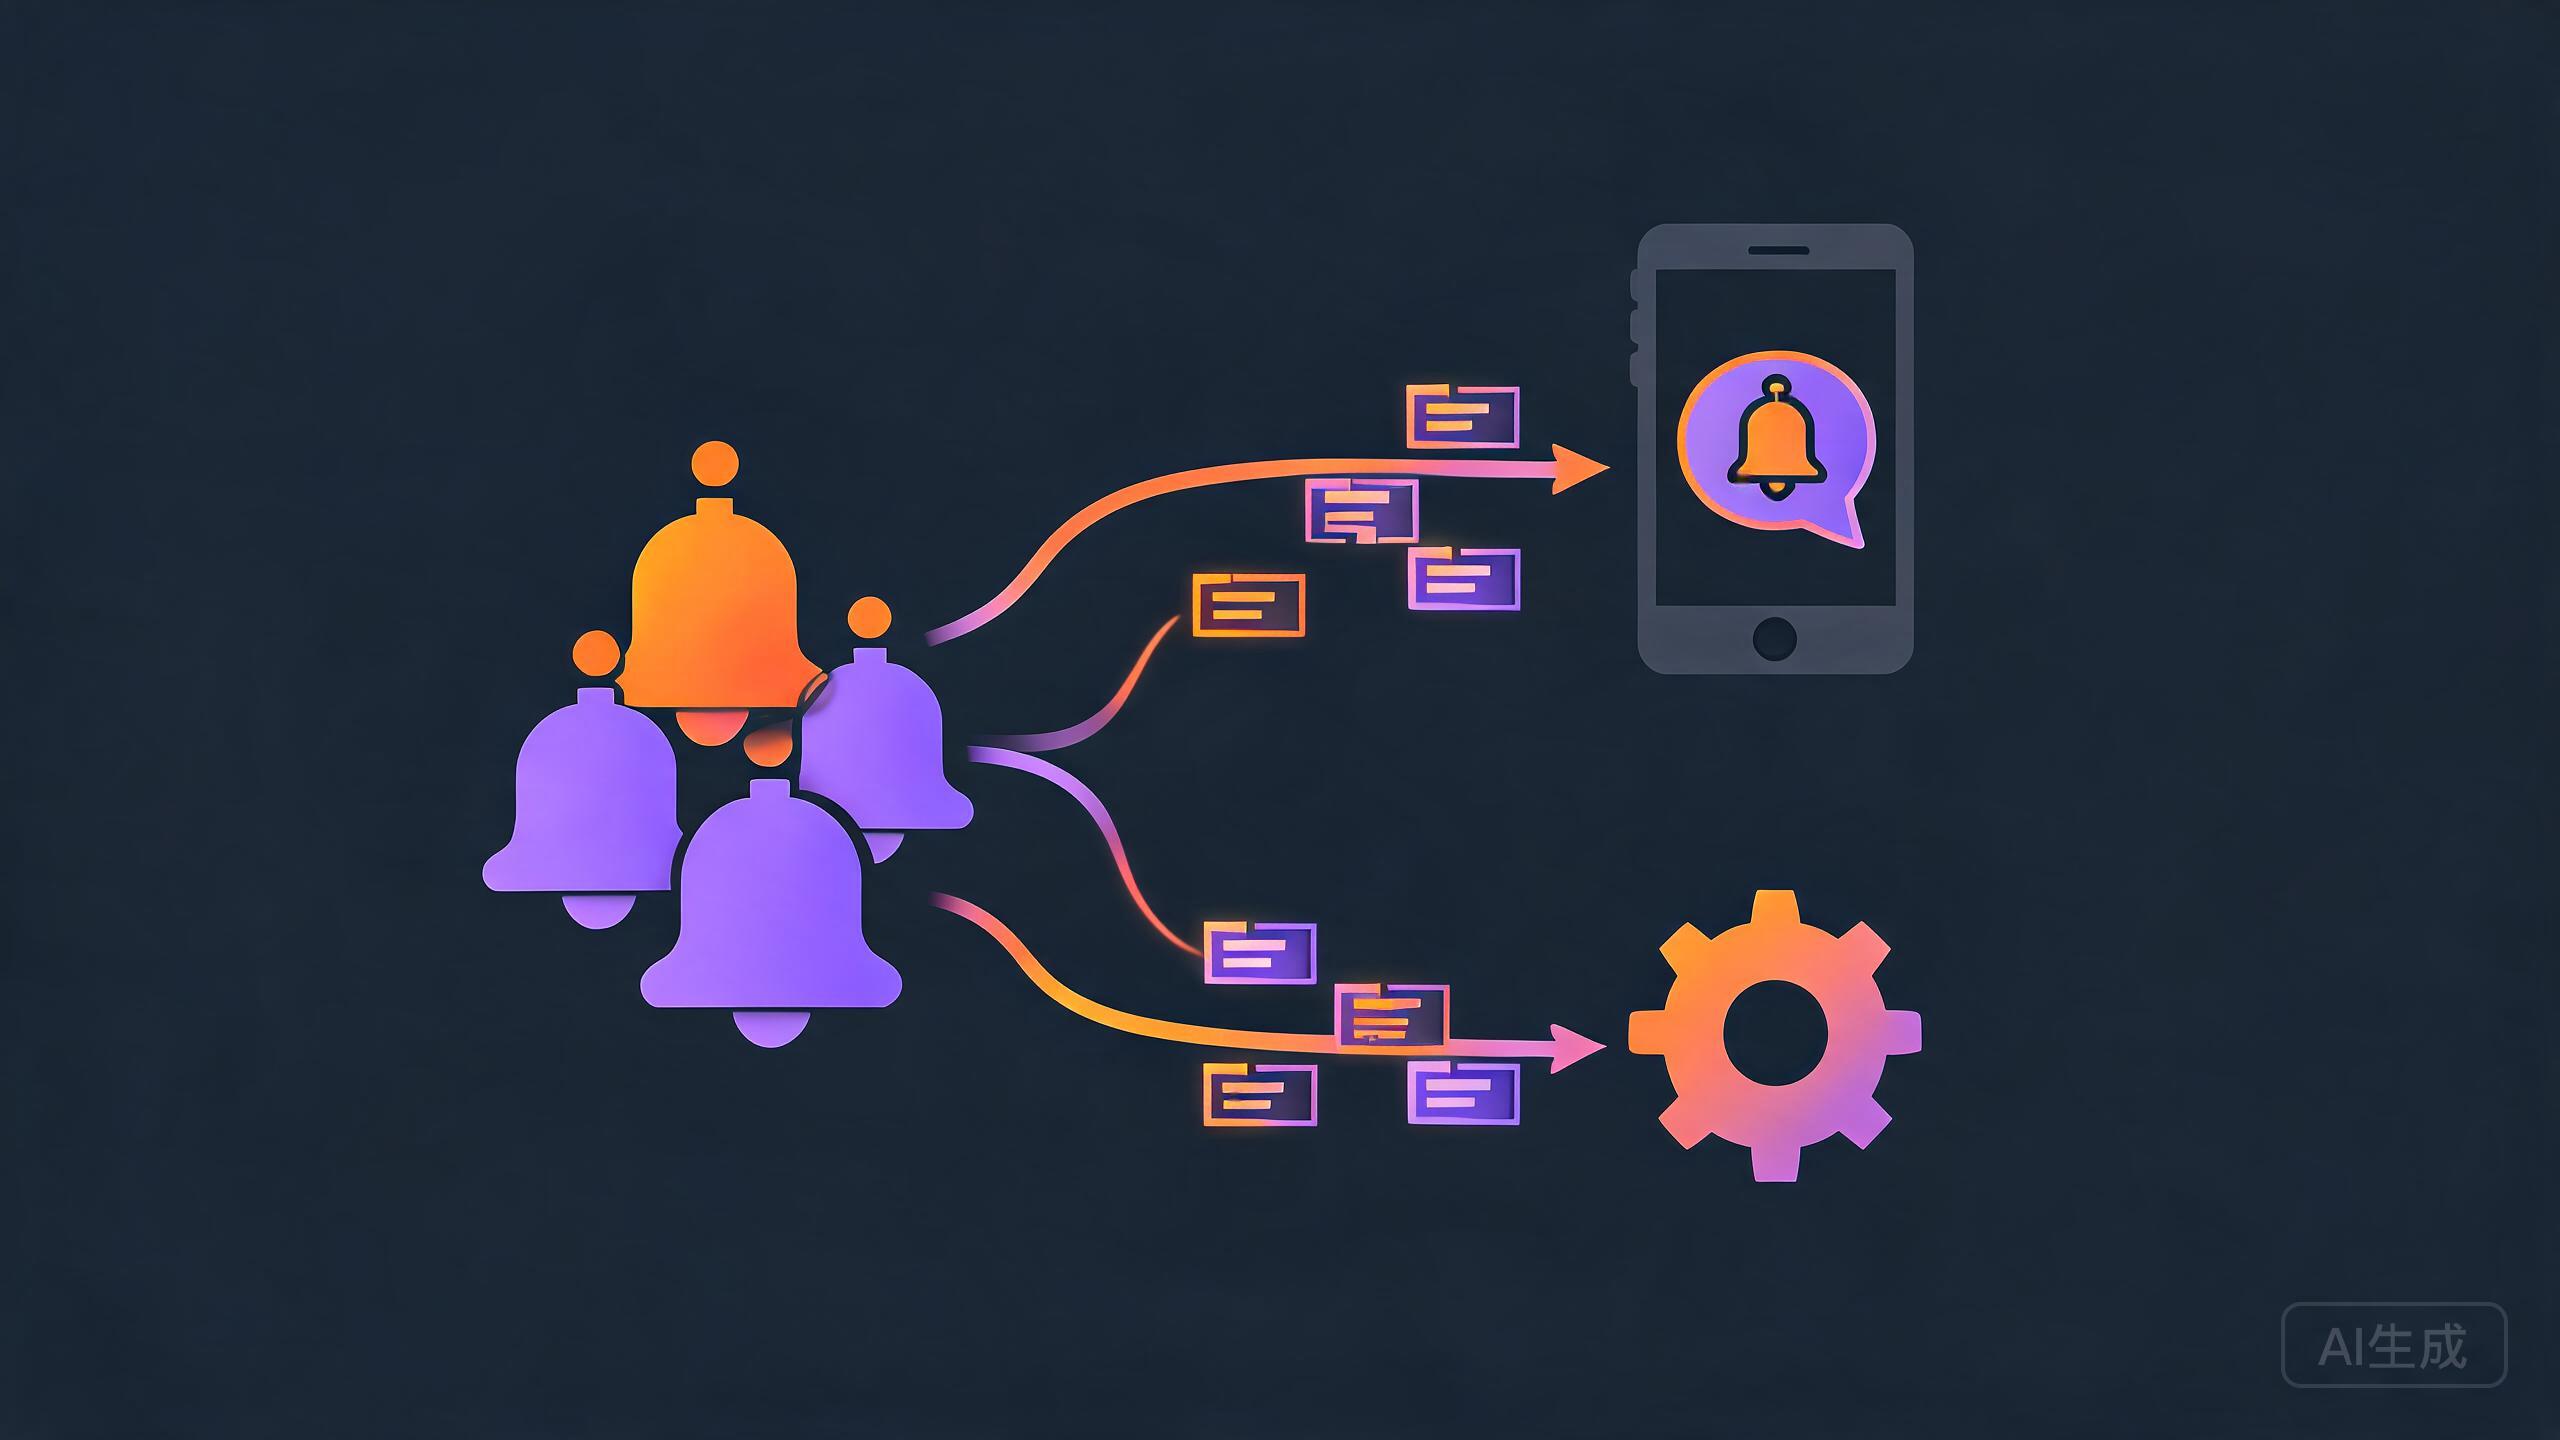
裸的告警体验很糟:P95 延迟高、某 Pod 重启、磁盘快满、某探针失败……几十条一起涌来,真正要人处理的"根因"被淹没;同一根因的连带故障重复发。Alertmanager 用四个机制把"事件"精炼成"通知":分组(Grouping)——把同标签/同告警的一批收敛成一条(如"同服务多节点 5xx"并成一条);抑制(Inhibition)——根因告警在时,掩盖其衍生的次要告警(如 master 挂了,忽略对它的探针告警);静默(Silence)——发布的变更/已知维护期主动"闭嘴"一段时间;路由(Routing)——按标签把不同告警转到不同渠道与优先级(如服务团队只收自己负责的、关键级别走更醒目通知)。目标:人收到的每一声铃声都"信息密度够、决策成本低"。
二、路由怎么配:route + receiver 把"谁的事发给谁"
Alertmanager 的配置核心是"路由树 + 接收者":接收者(receiver)是通知目的地(邮件/Webhook/Slack 等);route 定义"告警按什么标签走哪个 receiver",可嵌套匹配。把"不同服务告警分给不同负责人/渠道、共用分组去重"配好,就避免了"所有告警一股脑进一个渠道"。上面说的分组/抑制在 route 与 inhibit_rules 里声明,静默则用 silences 或临时建一条。下面是一个"按环境/服务路由、按告警名分组、抑制连带告警"的最小示例。
# alertmanager.yml(核心片段)
route:
  receiver: default
  group_by: [alertname, service]        # 分组:同"告警名+服务"收敛成一条
  group_wait: 30s                       # 新组首次通知的等待窗口(聚一会再发)
  group_interval: 5m                   # 同一组若继续变,通知间隔
  repeat_interval: 4h                  # 长时间未解决的重发间隔
  routes:
    - matchers: [ env="prod" ]
      receiver: ops-prod              # 生产告警走 ops 渠道
      continue: true
inhibit_rules:                         # 抑制:master 挂了就不重复报对它的探针
  - source_matchers: [ alertname="NodeDown", instance="master" ]
    target_matchers: [ target="master" ]
    equal: [ service ]
路由的坑:一是"group_by 太少"——几条相关告警各自成组、轰炸式通知;反过来"group_by 太多/含高基数标签"又收敛不了;二是"repeat_interval 太短"——没人处理的告警每隔几分钟就重复轰炸;按"多久没人看才该重发"来配;三是"静默建了不删 / 建了忘开中止"——维护期过了还闷着关键告警。把分组与抑制调顺,是"告警不吵但有响必中"的关键。
三、Prometheus 侧规则:让"触发"足够准,别靠 Alertmanager 硬拦
降噪的另一半在源头:Prometheus 规则(rules)要"信号真实、表达式可持续、有 for 判定"。用 `for` 指定持续多久才触发,过滤瞬时毛刺(如 CPU 偶发 1 秒 90% 不报警、持续 5 分钟才报);用合理阈值避免"永远在报警的告警"(如磁盘">=85% for 30m"而非"非空就报")。规则文件里写清楚 on-sanitization 的标签(谁都负责、什么环境),让它自然被上面的路由匹配。
# prometheus 规则文件片段(rules/node.yml)
groups:
  - name: node
    rules:
      - alert: NodeHighCPU
        expr: avg(rate(node_cpu_seconds_total{mode="idle"}[5m])) < 0.1
        for: 5m                # 持续 5 分钟才告警,滤掉瞬时尖峰
        labels:
          service: infra        # 供 Alertmanager 路由
        annotations:
          summary: "{{ $labels.instance }} CPU 持续过高"
规则的常见问题:"表达式太复杂/不含 for"导致误报频繁;"阈值硬编码"没有随着机器规格调整;"没有 labels 组织"让路由无从下手。把信号做准,比在 Alertmanager 里堆抑制更能降噪。
四、边界与场景:它管"怎么通知人",不替代数据存储与根因
Alertmanager 是"告警收敛与派发层",它不替 Prometheus 存时序(那是 TSDB 的活)、也不替人判断根因(它只是把"信号"组织成"通知")。边界要认清:"静默"是人为暂缓、不是系统兜底,别把永远需要抑制的告警一直挂着而不修规则。适合自托管"人人有分工、告警不能吵"时落地。把"规则准 + 分组/抑制/路由顺 + 静默受控"配好,监控就从"报警轰炸"变成"事后可追溯、来了就有处理价值"的体系,与前文的 Grafana/监控看板配合,自托管运维才算真正"看得明、响得对"。