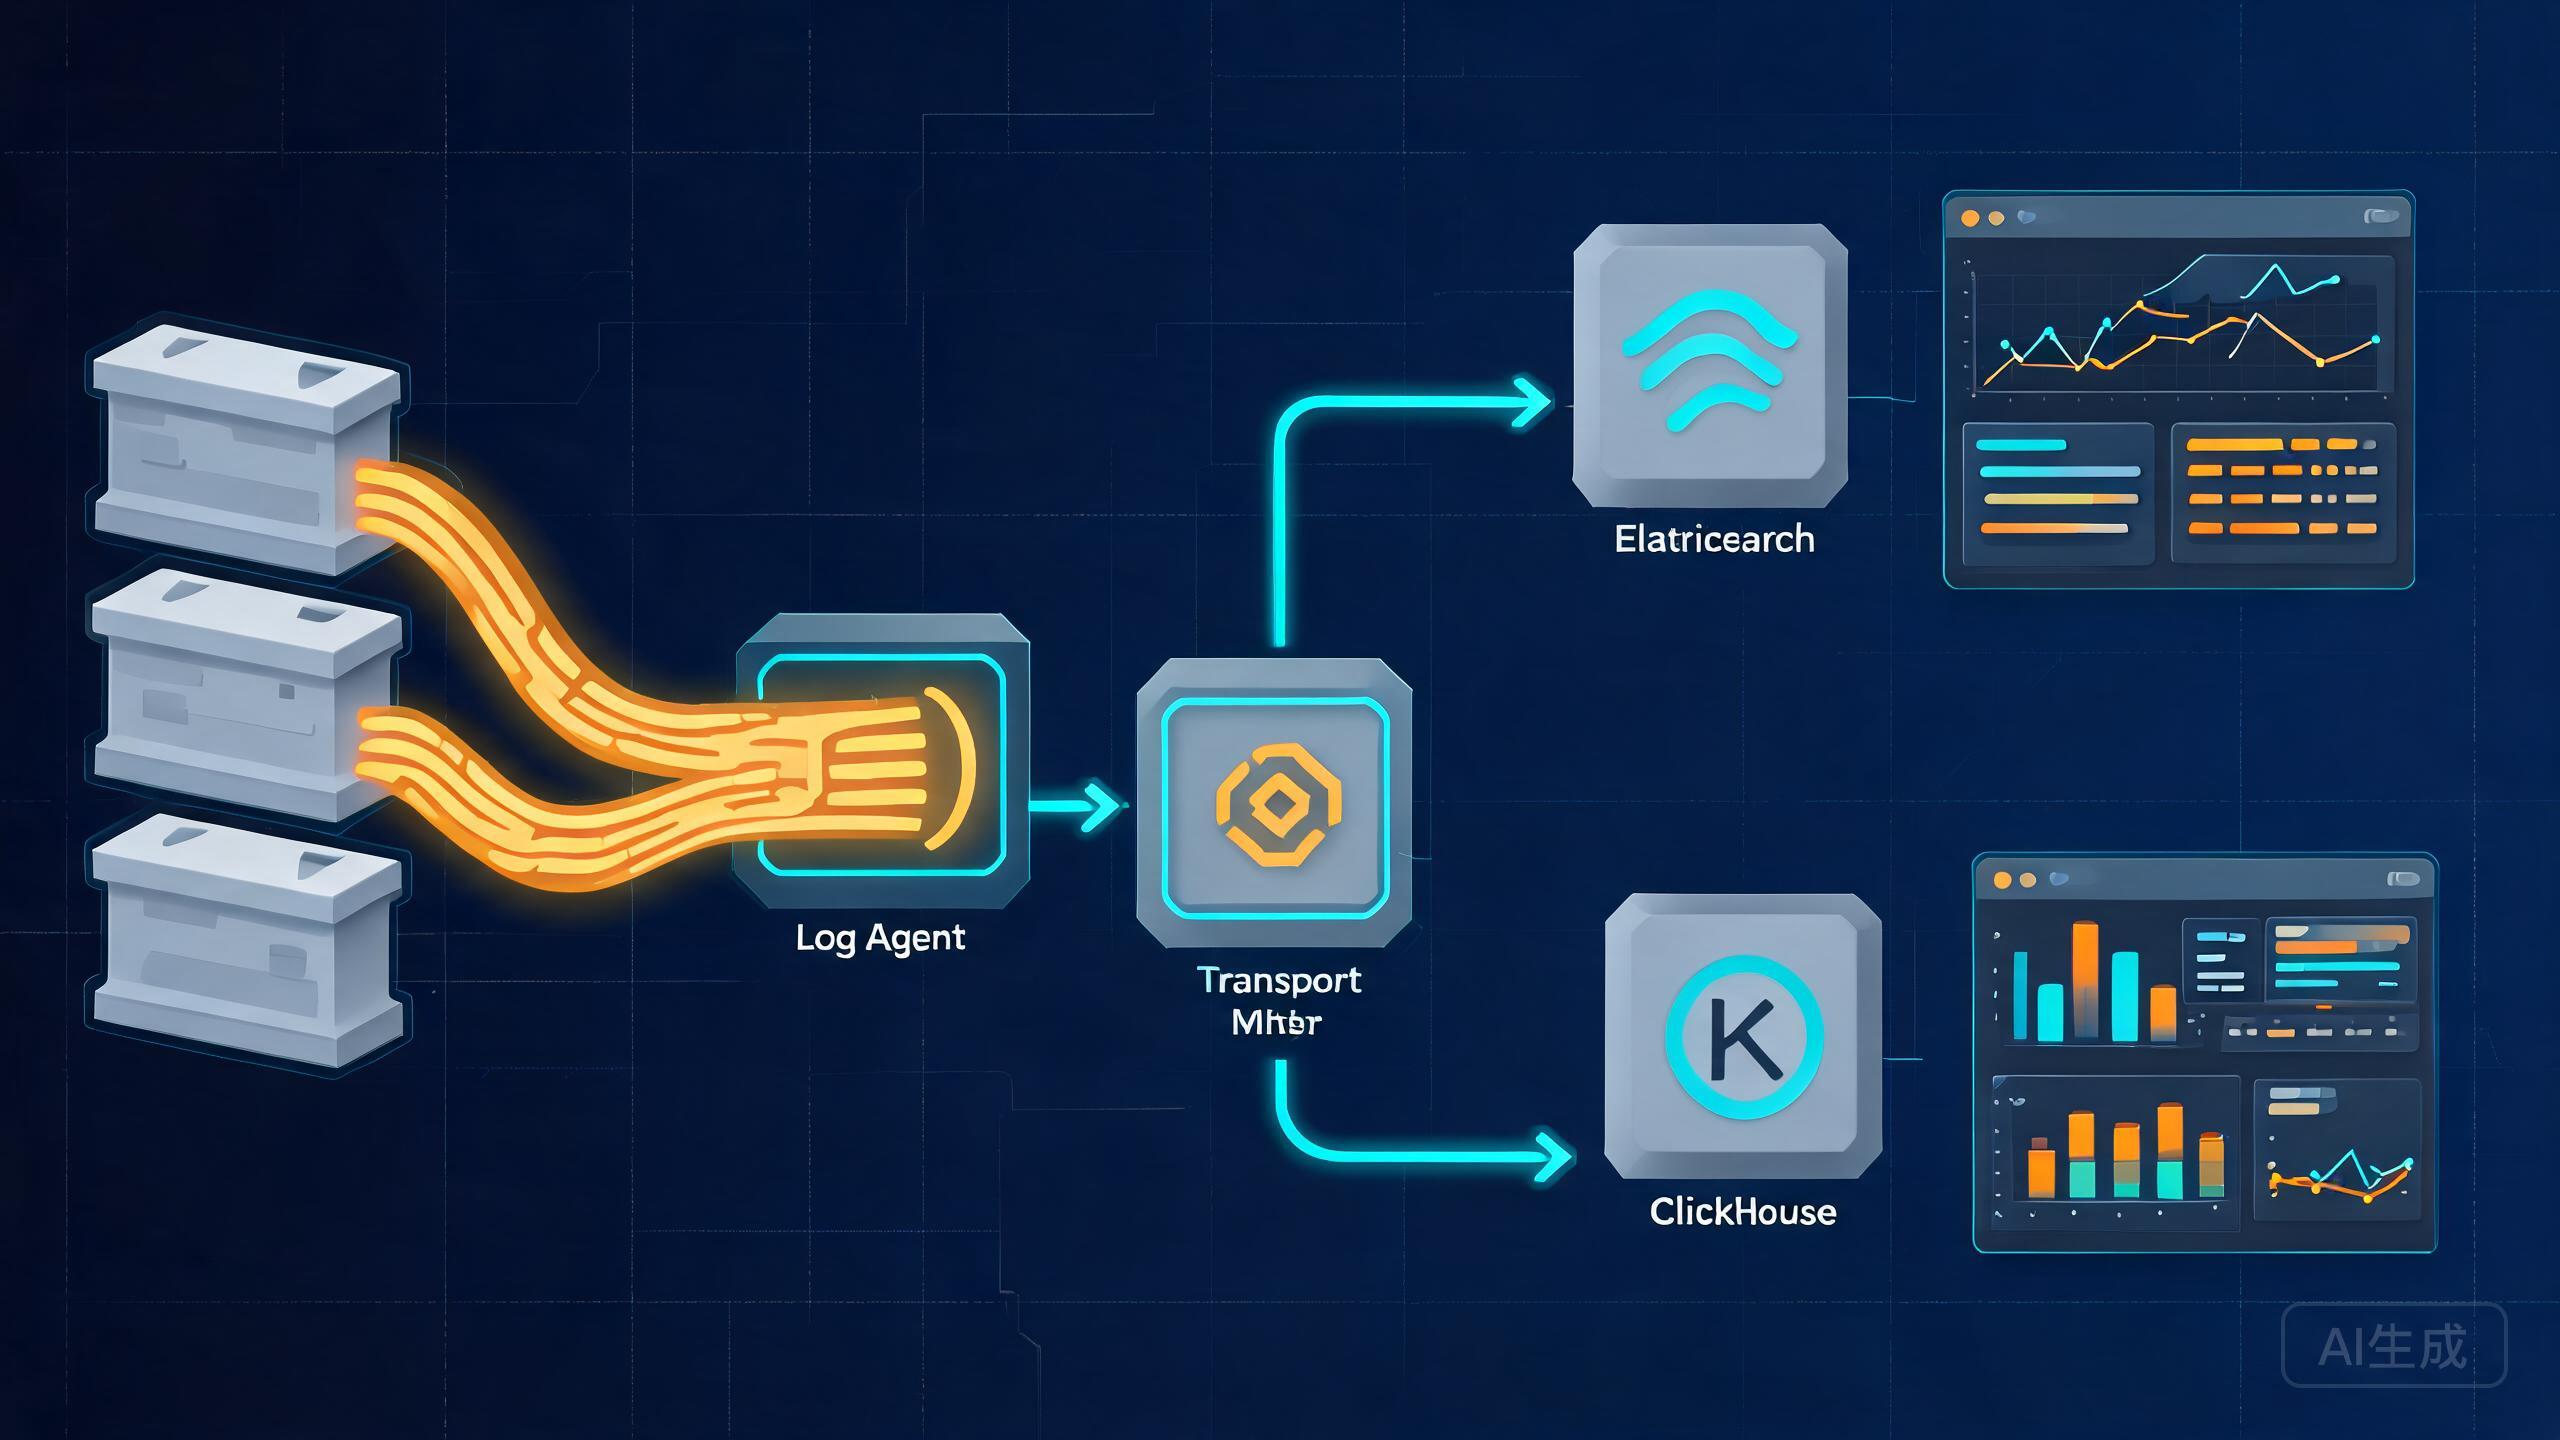
自托管跑起来后,日志、访问埋点、监控指标、事件流水会不断堆积——这些"海量、只追加、按时间分析"的数据,放进传统关系库要么建一堆索引还很慢,要么清掉又可惜。ClickHouse 就是为"分析型查询(OLAP)"生的开源列式数据库:它为"大表上的聚合/分组/过滤"做了极致优化,查询速度常常秒杀 MySQL 的相同语句若干数量级。这篇讲清 ClickHouse 解决什么、列式存储怎么读、怎么把日志/指标导进去、表引擎与分区怎么理解,以及它"能干什么、早不要拿来干单行事务"的边界。
一、ClickHouse 解决什么:让"海量日志/指标"能痛快地做分析
区别两类负载:交易型(OLTP)——银行转账那种单行写入、小事务、要强一致,MySQL/PostgreSQL 擅长;分析型(OLAP)——"这个小时每台机器的错误数"、"过去一周各端访问量的聚合"这种在大数据集(几千万到几十亿行)上做聚合/分组/过滤/排序,传统行式库靠索引也会退化很慢。ClickHouse 用"列式存储 + 向量化计算 + 稀疏索引 + 压缩"专门干后者:一次只读查询涉及的几列(而非整行),配合高压缩与 SIMD 向量化,几亿行聚合秒级返回。自托管里最常见的接入:把 Nginx/应用日志、Prometheus 指标、Kafka 里的事件流水都灌进去,做"事后想怎么查就怎么查"的分析。理解它先抓"列式"——它是为"少列大范围扫描聚合"服务的,不是为"反复改几行"服务的。
二、表引擎与分区:理解 ClickHouse 数据怎么组织
ClickHouse 的玩法集中在"表引擎(MergeTree 家族)+ 分区 + 排序键":最常用的是 MergeTree 系(日志数据天然适合),它按"分区键 + 排序键"组织数据、后台合并,天然支持时间分区(按天/月)便于丢弃旧数据与优化扫描。规划表时给三样:ENGINE(MergeTree)、ORDER BY(排序键,决定稀疏索引与压缩率,通常把查询过滤字段/时间放进去)、PARTITION BY(分区键,如 toYYYYMMDD(ts))。列尽量用字符串/日期数字、少用高基数随意字段,压缩与查询都快。
-- 一张典型的"按天分区的日志分析表"
CREATE TABLE app_log (
  ts        DateTime,
  level     LowCardinality(String),
  service   String,
  path      String,
  status    UInt16,
  msg       String
) ENGINE = MergeTree
PARTITION BY toYYYYMMDD(ts)        -- 按天分区,方便按天查询与清理
ORDER BY (ts, service)             -- 排序键,配合过滤与压缩
TTL ts + INTERVAL 30 DAY DELETE;    -- 自动淘汰 30 天前数据

-- 导入一查:历史数据用 HTTP 批量灌入,别一行行 insert
# 示例:把日志批量喂进去(HTTP 接口,行按 tab/JSON 分隔)
curl -s 'http://10.0.0.6:8123/?query=INSERT+INTO+app_log+FORMAT+JSONEachRow' \\
  --data-binary @/srv/logs/rows.ndjson
接入数据要批量、按时间追加(ClickHouse 不适合高频单行 insert 抖动);导入完成后立刻能查、返回聚合秒级。别把"每次都要 update/delete 单行"的写法带进来——它是分析库不是事务库。
三、典型查询与注意点:聚合就那么快,但别乱写高基数 join
ClickHouse 的强项是聚合查询,弱项是全表任意维度 join 与超高频单行写。查询上把要统计的维度放好、用 Materialized View(物化视图)预先聚合能更快;高基数字段(如随机 UUID 当标签)既费压缩又拖查询;join 尽量用它在导入时"先各自建好、查时少 join"。典型注意:一是"别为了省事建了超多分区"(分区过碎、后台合并压力大,按天/周平衡);二是"把所有列都塞进 ORDER BY"(过度、浪费);三是"导入用错格式或高频小批"拖低吞吐。下面是一条常见的按时间/维度聚合。
-- 过去 1 小时每个服务的 5xx 数量(列式聚合秒出)
SELECT service, countIf(status >= 500) AS errs
FROM app_log
WHERE ts >= now() - INTERVAL 1 HOUR
GROUP BY service
ORDER BY errs DESC
LIMIT 20;
四、边界与选型:分析库不是万能数据库
ClickHouse 的边界很清楚:它是 OLAP,别拿它做 OLTP——单行点查、频繁 update/delete、强事务、高并发写小事务不是它的主场(这些仍是 MySQL/PostgreSQL);它的"实时性"是"批量导入后秒查",不是"严格一致事务账本"。但它非常适合作"自托管可观测性/日志/事件的分析后端":日志、监控指标、埋点流水灌进去,按需切片聚合。这段话和前面的衔接也顺理成章:Kafka 负责把事件流多路分发,ClickHouse 常被当作其中一路"囤起来好分析"的下游。把它当"数据分析引擎",与事务库各司其职,自托管的数据层就"能存也查得动"。