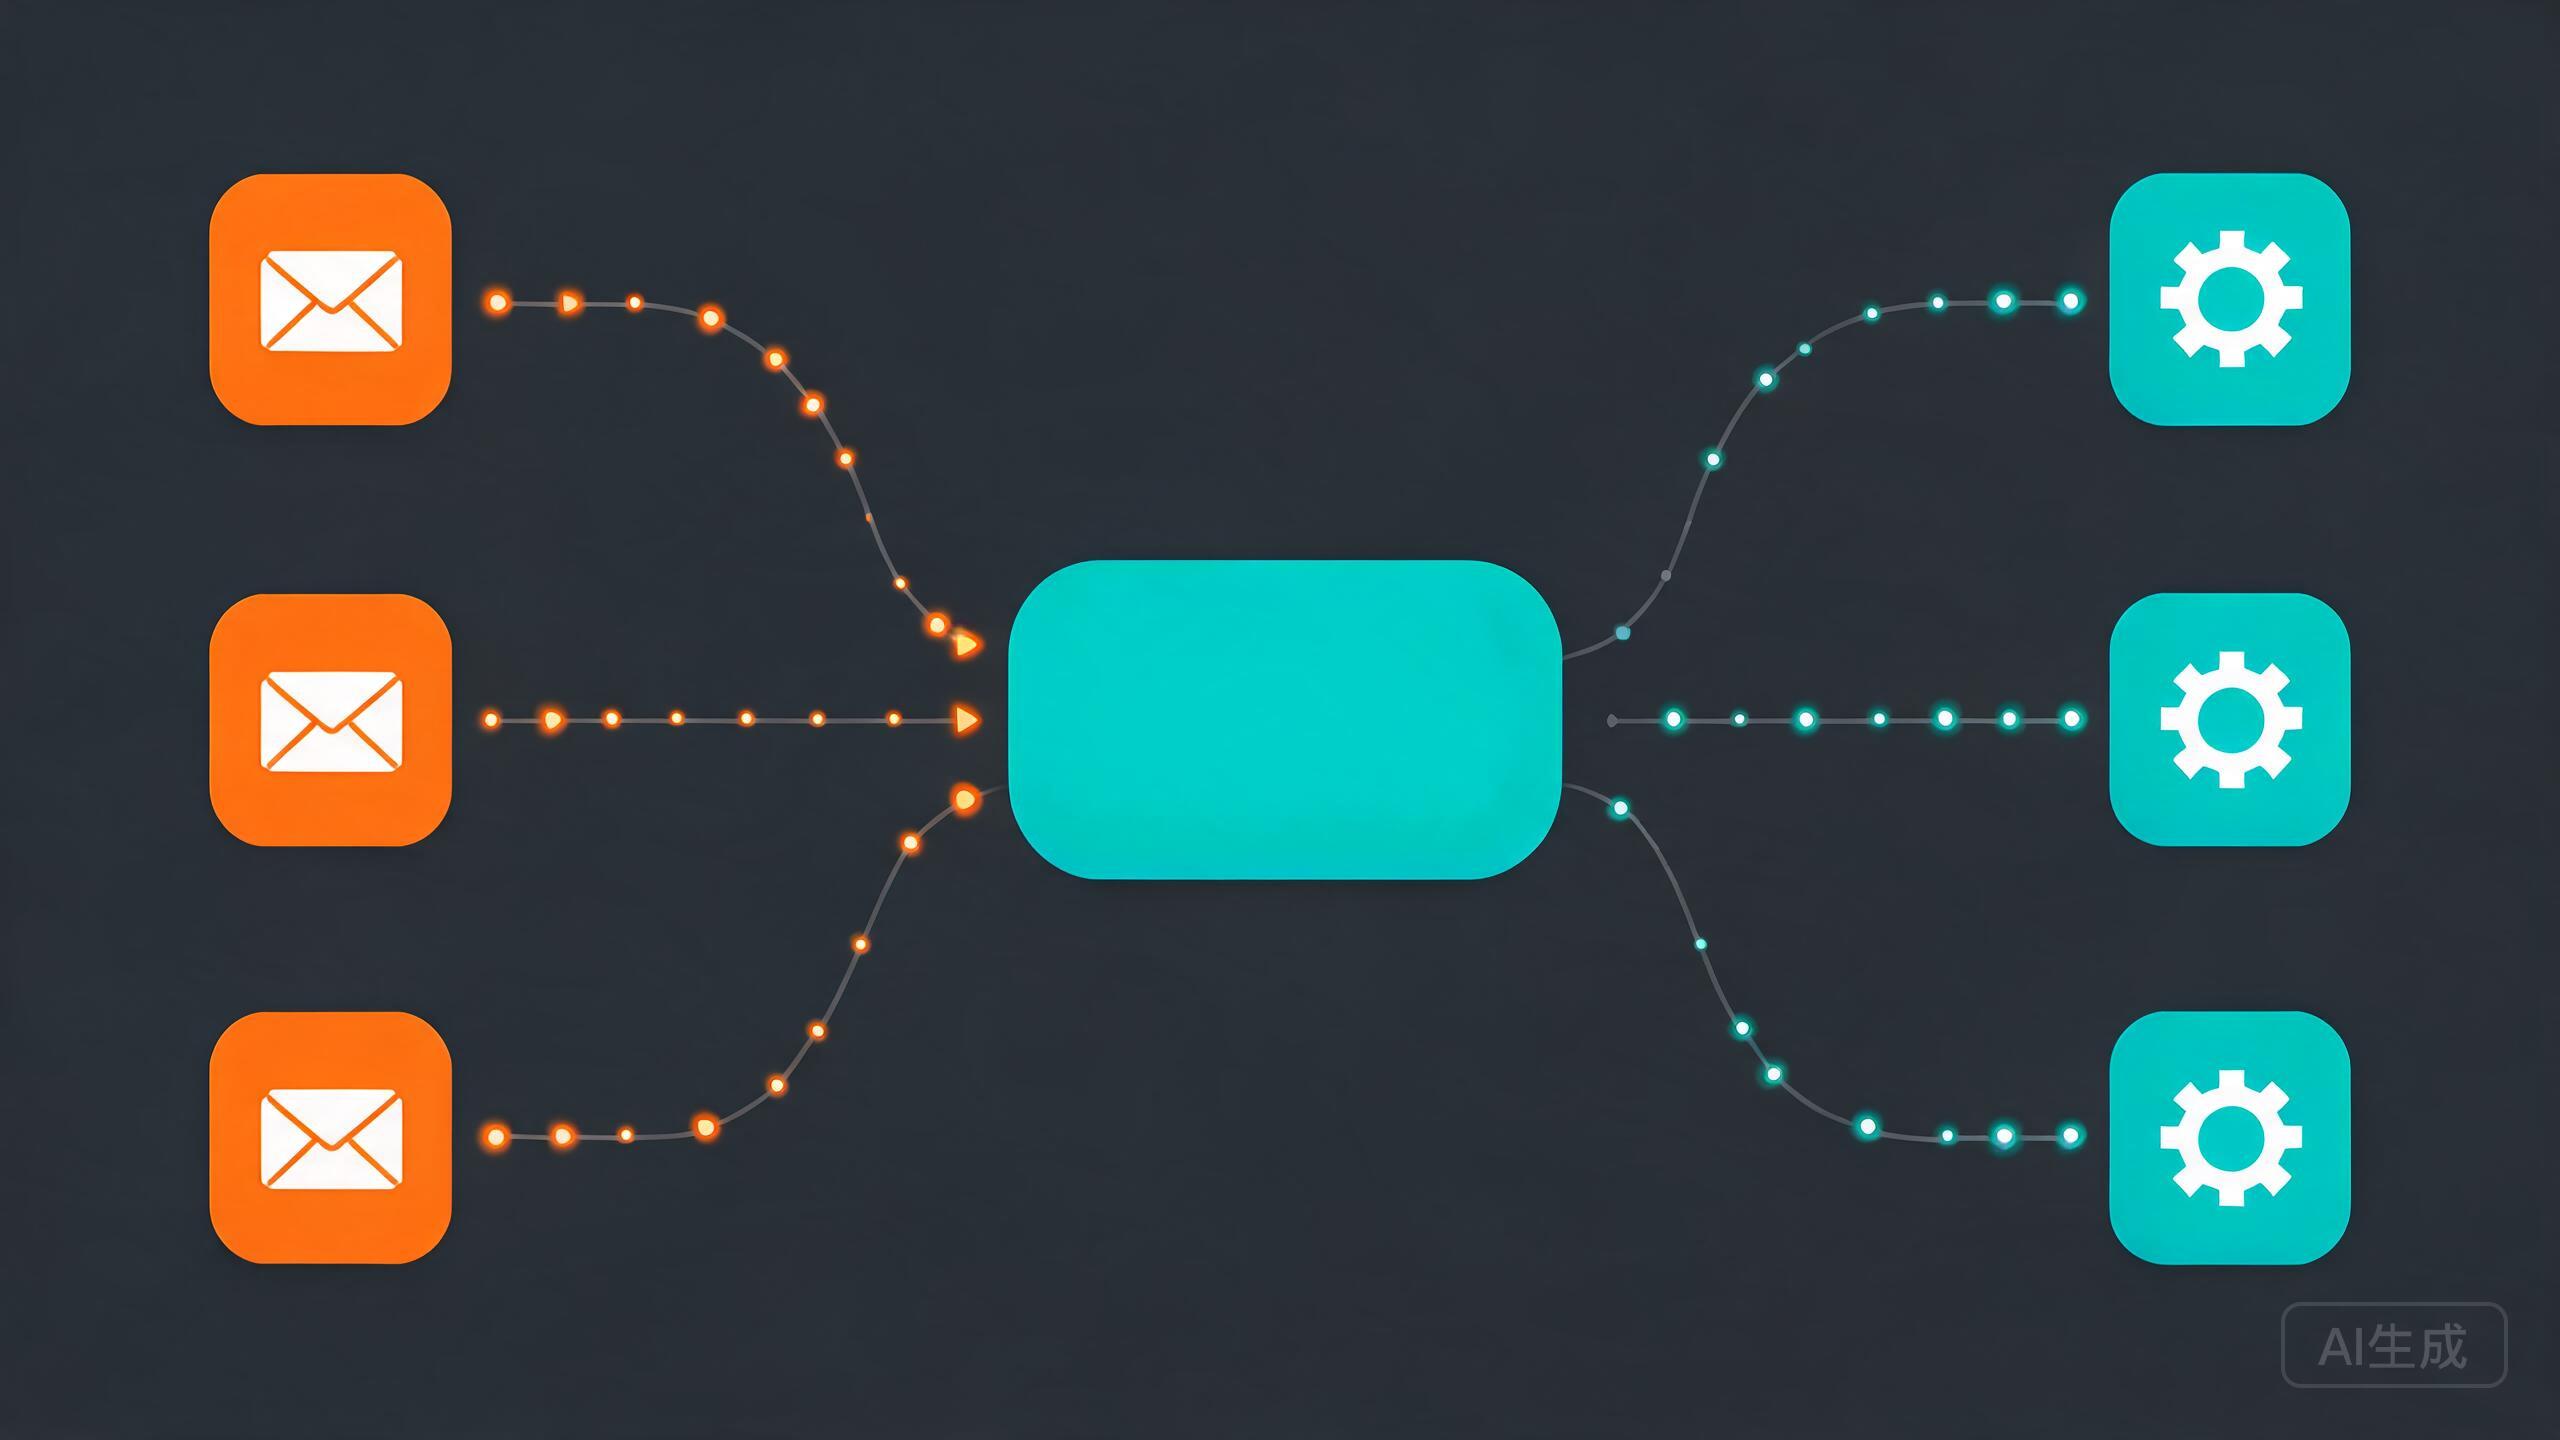
当自托管的"事件流"多起来——业务日志、埋点、告警、数据库变更、各类"要广播给多套处理系统"的实时消息——用"点对点消息队列"(前文 RabbitMQ 那一类)会显得不够:它擅长"把一条消息交给一个消费者消费掉",但扛不住"同一份数据要被多个团队/多套系统反复读、还要能按时间回溯、能支撑流式统计"。Kafka 解决的就是这个问题:把事件当作"可重复读取、可回溯、可分区分发"的持久化日志流。这篇讲清 Kafka 解决什么、主题/分区/消费者组怎么理解、最小集群怎么起、以及"数据处理用流 / 任务分发用队列"的边界。
一、Kafka 解决什么:把"事件"变成可持久、可多读、可回溯的日志流
Kafka 的核心模型是"分区的、持久化的提交日志":每条消息按 key 落到某个分区,分区内有序,消息写入即持久化,且不会因为被谁读走就消失——消费者用 offset 自己"定位读到哪",因此同一份日志能被多个消费者组各自独立消费,还能用新消费者从过去某个 offset 读回。这带来普通队列/邮件列表没有的三个能力:重放(重新处理历史事件)、多读(同一数据喂给存储与实时计算等多路下游)、流式处理(对连续事件做聚合统计)。它天然为"高吞吐、可水平扩展、错峰解耦"设计。自托管里典型:汇聚多服务日志到 ClickHouse(前文时序/分析库)、作为埋点与事件背板让多套系统消费同一事件、做变更数据捕获的载体。理解它先把"日志流"想清楚:不是"发一条收一条",而是"往一个永不删尽的日志末尾追加,谁需要谁按自己的速度从这读"。
二、主题 / 分区 / 消费者组:三个概念决定它有多能打
抓 Kafka 就看三样:Topic(主题,一类消息的逻辑容器)、Partition(分区,Topic 被切成的并行单元,是并行度与顺序性的来源,一个分区内有序,跨分区分组内不一定严格有序)、Consumer Group(消费者组,一组协同消费同一 Topic 的消费者,分区在组内分发)。写入时按 key 哈希选分区(同 key 进同分区 → 保序);消费时"一个分区同一时刻只被组内一个消费者接管"保证不重复抢、也保证分区内顺序。调优并行度就是加分区;要"保证相同实体顺序"就让它们 key 相同落进同分区。
# 主题:3 个分区、2 副本(副本=冗余与高可用,跨 broker 分布)
kafka-topics.sh --bootstrap-server k1:9092,k2:9092,k3:9092 \\
  --create --topic app-events --partitions 3 --replication-factor 2

# 生产者:指定 key 保证同实体进同分区、保序
echo 'msg' | kafka-console-producer.sh --bootstrap-server k1:9092 \\
  --topic app-events --property parse.key=true --property key.separator=:

# 消费者:同组消费该主题;想看全部则新起组从 --from-beginning 读
kafka-console-consumer.sh --bootstrap-server k1:9092 --topic app-events --group my-group
常见配置坑:分区数定了再改成本高,先按长期吞吐预留;副本数 1 无冗余、>2 提示耗更多存储与网络,起步副本 2/3 稳妥;"消费者组下再加消费者也不一定提升吞吐"——组内吞吐被"分区数 ÷ 组内消费者数"上限卡住,加分区才能真正并行。
三、最小集群怎么起:多 broker + Zookeeper(KRaft) 的取舍
Kafka 集群由多个 broker(存储与服务节点)组成,并需要"元数据协调"。新版本默认用 KRaft(内建元数据,QJM/Raft 自行选主),旧版则是 ZooKeeper。自托管首选 KRaft 跑奇数个 broker(如 3)就够:broker 之间通过内部协议同步副本、topic 分区分摊到各节点,某 broker 挂了副本在其他节点顶上。起一个三 broker 的 KRaft 集群,关键是把每个节点的 node.id 与 controller 配置说清、并保证内网端口互通。
# 以 KRaft 模式的最小配置(每 broker 一份,node.id 换成 1/2/3)
process.roles=broker,controller
node.id=1
controller.quorum.voters=1@10.0.0.11:9093,2@10.0.0.12:9093,3@10.0.0.13:9093
listeners=PLAINTEXT://:9092,CONTROLLER://:9093
advertised.listeners=PLAINTEXT://10.0.0.11:9092
log.dirs=/var/lib/kafka

# 首次初始化后启动(各节点 id 分别执行)
kafka-storage.sh format -t "$(kafka-storage.sh random-uuid)" -c config/kraft/server.properties
kafka-server-start.sh -daemon config/kraft/server.properties
# 验证:会话
kafka-broker-api-versions.sh --bootstrap-server 10.0.0.11:9092,10.0.0.12:9092,10.0.0.13:9092
集群层面的坑:一是"副本数 1 图省事"——broker 一挂数据不可用,至少 2/3 副本;二是"存储与磁盘依赖"——Kafka 强依赖持久化与顺序追加,数据目录要上 SSD、别和系统盘共用、配足大小(它保留的是"日志",不像队列读走会删);三是"分区/主题泛滥"——主题越多、分区越多,元数据与端开销越大,按业务收敛。
四、边界与选型:流式数据用 Kafka,任务分发仍可走轻量队列
Kafka 与普通消息中间件各有擅长:要"一道消息多个下游、按时间回溯、高吞吐流式"→Kafka;要"简单可靠地把任务分派给一个工作进程、按需死信/延迟"→RabbitMQ/NATS 这类更轻、易上手。别把 Kafka 当"高性能 RabbitMQ"硬塞简单任务——部署与运维成本高出一截。边界也要认清:Kafka 保证"分区内顺序 + 至少一次",要"精确一次/去重"得靠幂等生产者与事务;它管数据的"流式分发与缓冲",不替代流处理引擎(计算/聚合在其上单独做,如配合 ClickHouse 或处理框架)。把它当"持久的、可分发的日志背板",配合一套消费处理链,自托管的数据搬运动线就从"到处轮询"变成"事件驱动"。