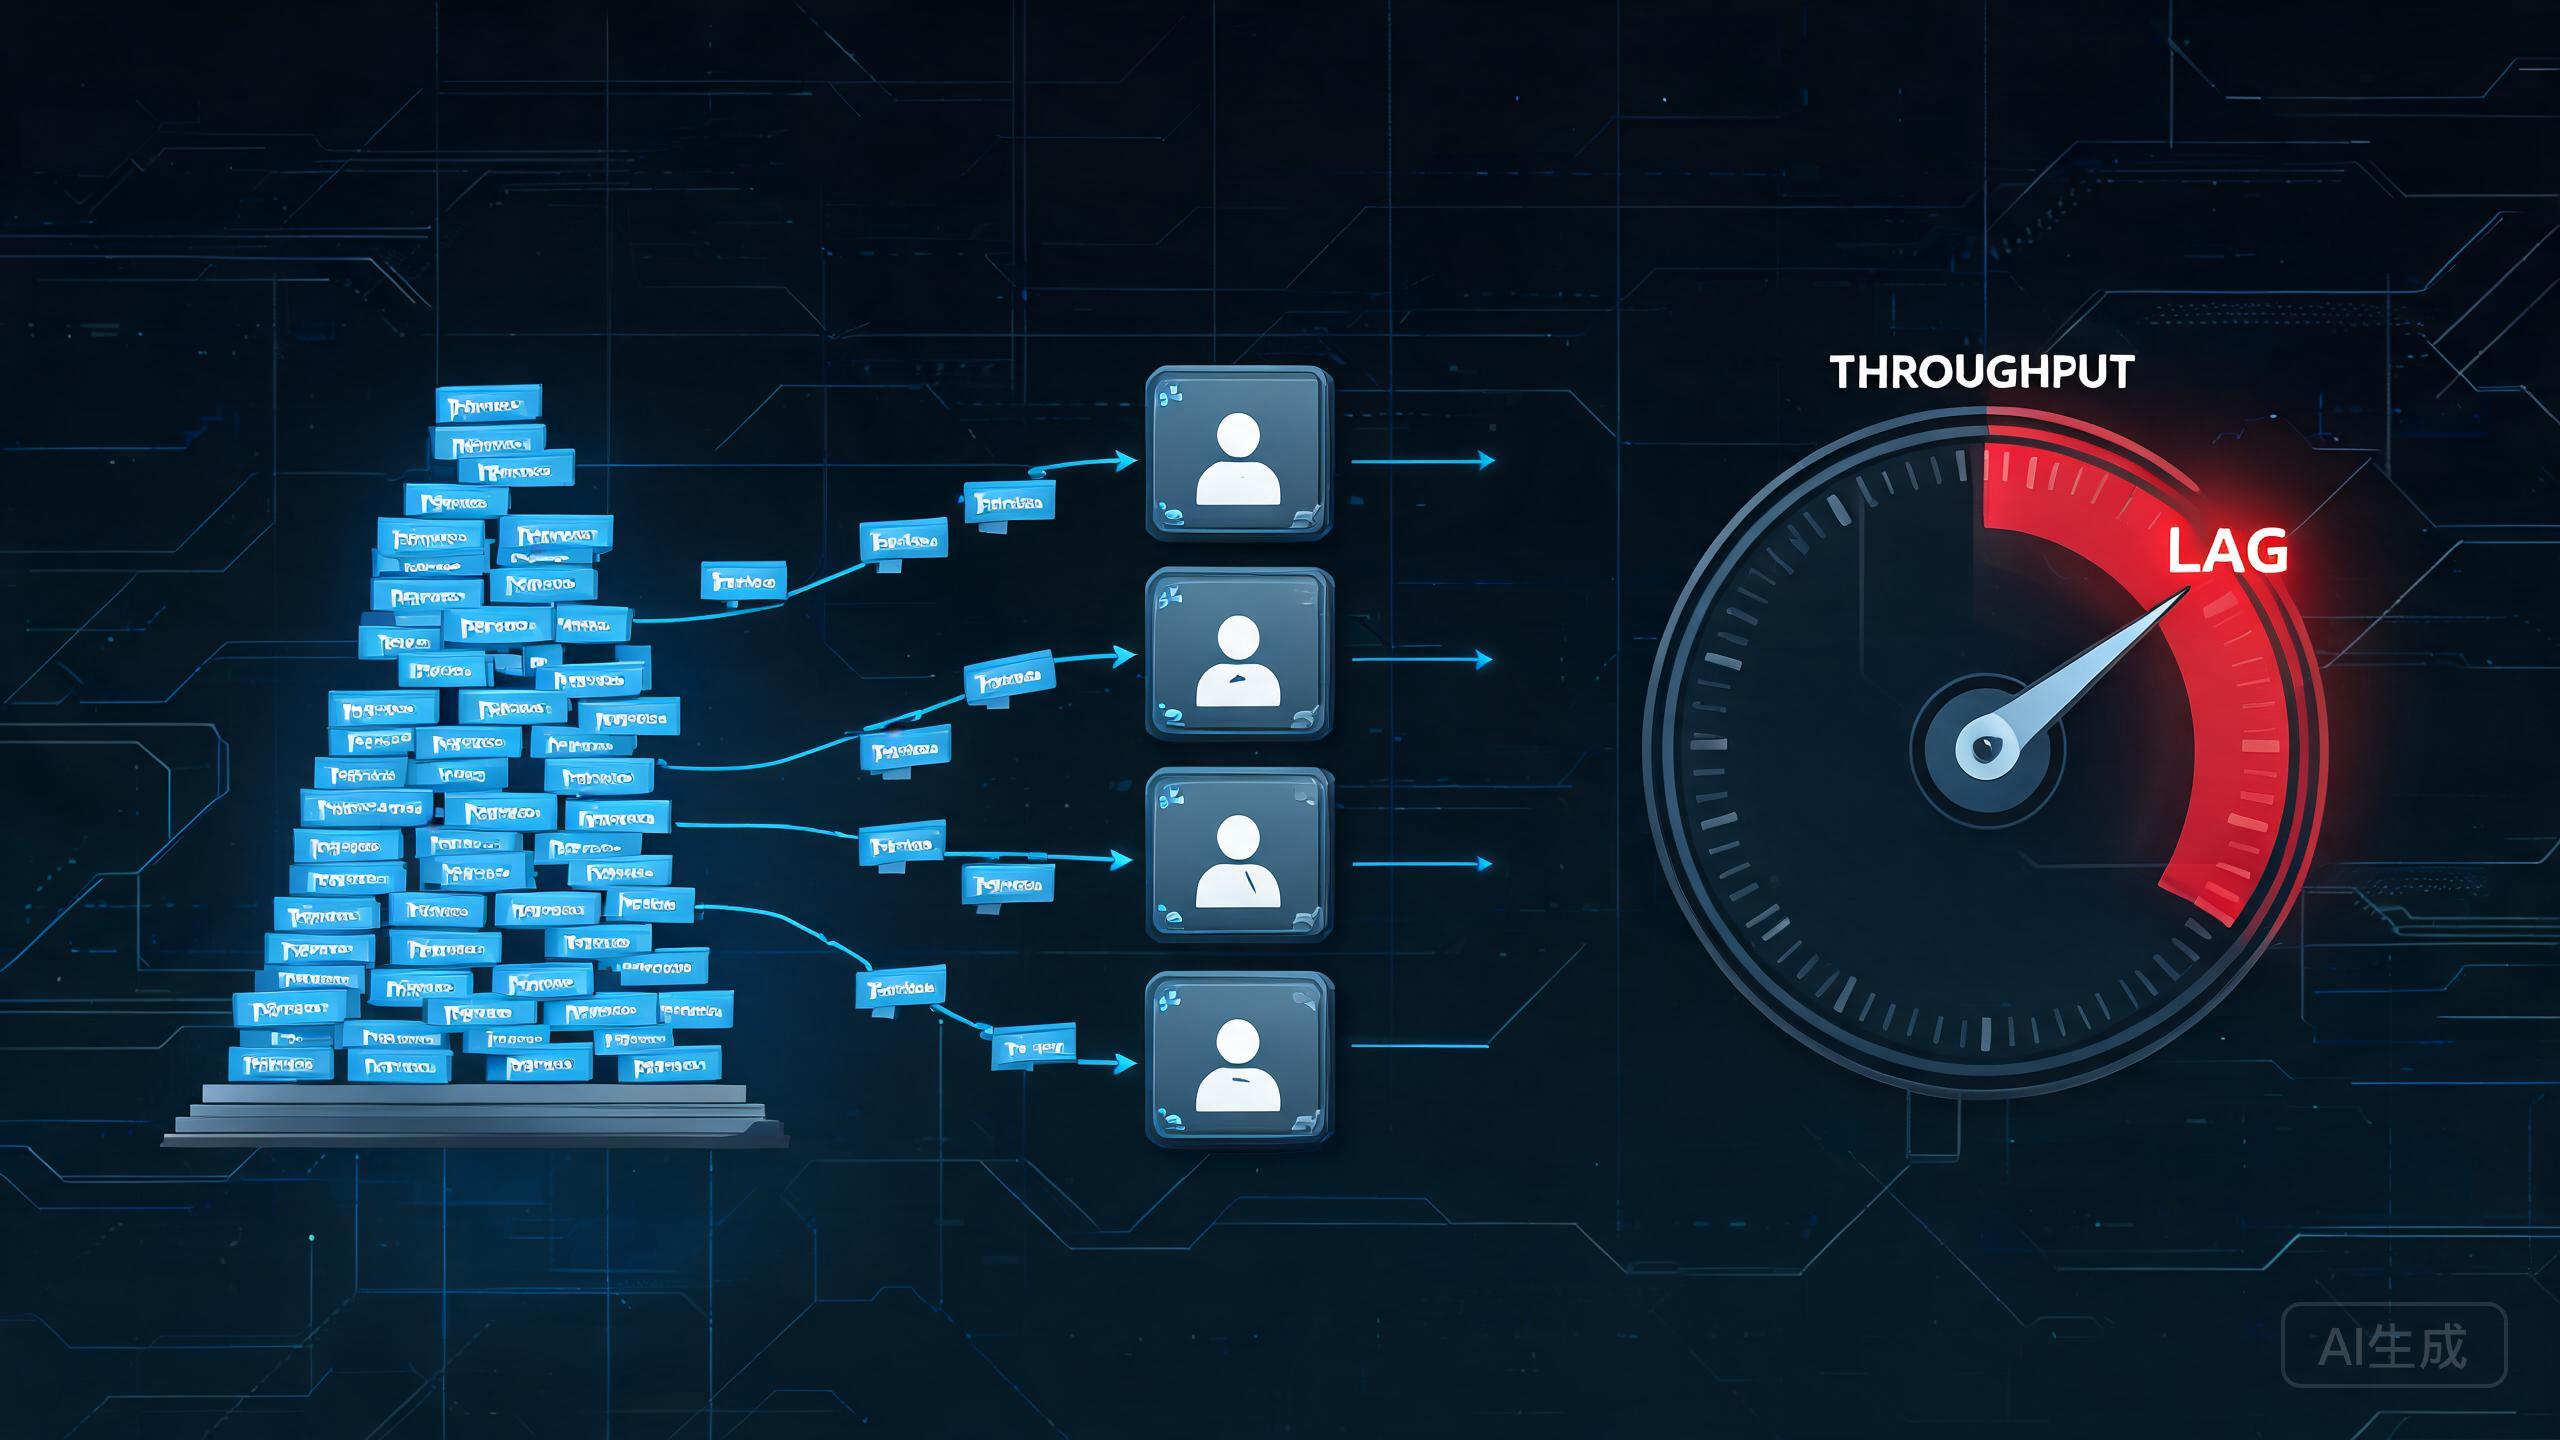
自托管服务上了规模,会出现一种"牵一发动全身"的别扭:A 服务要通知 B 更新、C 要同步数据、D 要做异步处理,直接用同步接口互相调,一次依赖崩塌、高峰时全体排队,稍有大流就把某个环节打爆。消息队列(Message Queue)是化解这类"直连耦合 + 瞬峰压力"的成熟手段:生产端把"事"丢进队列就走,消费端按自己的节奏处理,两边解耦、中间还能削峰与缓冲。这篇讲清消息队列解决什么、RabbitMQ 怎么起、直连换成队列的建模,以及确认/死信、监控与常见坑。
一、消息队列解决什么:把"一个动作触发一连串同步等待"变成异步解耦
直连同步的痛有两个:一是"耦合"——A 调用 B 时,B 慢/挂/升级,A 就跟着卡住或失败,服务间被迫绑在一起;二是"峰值"——瞬时请求高时,所有下游被一次性压到,扛不住就都崩。消息队列在中间加了一个"缓冲的异步层":生产者把任务(消息)写到队列即返回,消费者按自己的速度把消息取出处理。于是"A 产生一个动作 → 队列里塞一条消息 → B/C/D 各按节奏消费",A 不再等 B 的实时结果,峰值也被队列缓冲成下游能消化的匀速流。这对"通知、异步任务、日志搬运、解耦后的数据同步"是极佳的解。
和服务器内其他层的定位对比:数据库管"状态",缓存加速"读",而消息队列管"事件/任务的解耦与流动"——它不是存"最终状态",而是协调"哪件事该在什么时候、由谁处理"。它不仅帮你把高峰削平(削峰填谷),也让多个服务不再互相阻塞(解耦)。在自托管里,凡是"一个动作要引起多件事、且可以异步慢慢做"的场景,都可考虑引入队列。
二、RabbitMQ 怎么起:交换机、队列、绑定 三层模型一次搞清
RabbitMQ 的核心不是"一个队列表",而是一套 Exchange(交换机)→ Binding(绑定)→ Queue(队列)的模型:生产者发消息到 Exchange,Exchange 按绑定规则(路由键/类型)把消息分发到一个或多个 Queue,消费者再从 Queue 取。三种常用 Exchange 类型:direct(按路由键精确匹配)、fanout(广播给所有绑定队列)、topic(按通配符匹配路由键,如 `log.*`)。理解这三层,写对路由就不难;用 Docker 起 RabbitMQ + Management 面板所见即所得。
# 用 Docker 起单节点 RabbitMQ,带管理面板
docker run -d --name rabbitmq --restart unless-stopped \
  -p 127.0.0.1:5672:5672 -p 127.0.0.1:15672:15672 \
  -e RABBITMQ_DEFAULT_USER=admin -e RABBITMQ_DEFAULT_PASS="强密码" \
  -v /srv/rabbitmq:/var/lib/rabbitmq \
  rabbitmq:3-management

# 生产(发到交换机,路由键决定进哪个队列)
# feature_exchange / q_log / q_alert  三个概念:交换机、队列、路由绑定
把"交换机/绑定/队列"想成"信使分发中心":消息投递时带一个路由键,Exchange 按类型与路由键决定发到哪个队列。多数自托管最简单的用法是 direct + 明确队列名 + 绑定关系清晰。理清这套模型,比你直接往"一个队列名"里塞消息可靠得多——否则消息发错队列、收不到还不知去哪查。
三、从直连改成队列:可靠投递、ack 确认与死信
把一段"同步调用"改造成队列,关键是保证"消息不丢、不重复处理、失败有去处"。可靠投递三件套:发布者用 Publisher Confirms 确认 Broker 收到;消费者用 manual ack(处理成功才 ack,失败 requeue/进死信);对处理多次都失败的消息,投到死信队列(DLX)留待人工,别让它在主队列里无限重试阻塞其他人。加了这三步,消息才从"发出去完事"变成"要么被成功处理、要么去向明确"。
# 死信交换机(DLX)示意:把多次失败的消费投到死信队列
# 声明队列时加参数:
#   x-dead-letter-exchange: dlx_exchange
#   x-dead-letter-routing-key: dead
# 消费者处理失败且被 requeue 多次后 → 消息进入 dlx_exchange → 死信队列
# 死信队列专门留给人/脚本去重试、告警或补偿。
改造的坑主要是"一致性"与"重复"。一致性:业务数据落库和发消息要尽量原子(先落库再发,或用 outbox/事务发消息),别造成"数据写了但消息丢了"。重复:消费者要有幂等(同一消息处理两次结果相同),因为生产者重试/网络重投都可能导致重复消费——消费端做好幂等,比只靠"保证只投一次"现实得多。把"发布确认 + 手动 ack + 死信 + 消费者幂等"这套闭环做成门槛,队列才真正可靠。
四、常见坑:消息积压、连接数、单点与磁盘、监控
RabbitMQ 用起来,四个坑必须防。一是"消息积压":消费者处理不过来或挂了,队列堆积、内存/磁盘暴涨甚至触发 flow control 卡死所有人——盯紧"队列里待处理的消息数",堆积超阈值就告警并提速消费。二是"连接/频道数":每个连接开销不小,客户端该用连接池并共用 Channel,别每个请求建连接把 Broker 拖垮。三是"单点与磁盘":RabbitMQ 默认把持久化消息落磁盘,要规划磁盘与内存、配好镜像队列/集群增加可用,并纳入备份;别把单节点当高可用。四是"监控":活动队列、消息出入速率、unacked、积压量这些指标要看板盯住,否则队列故障往往是"静默地越积越多"。
# 排查积压的快速办法:从管理面板或 CLI 看队列状态
#   rabbitmqctl list_queues name messages messages_unacknowledged
#   # 若 messages 持续上涨、消费端 down,多半是消费者没起来或处理太慢
把这当排障 SOP:消息"不见了"先看发布确认与死信、消息"重复了"看消费者幂等、队列"堆起来了"看消费端与积压监控。消息队列的价值建立在"可观测 + 可靠投递 + 幂等消费"上,这三样缺一它就会从"解耦神器"退化成"隐蔽的坑"。
五、边界:队列管"事件流动",不替代数据库也不包治所有设计
消息队列的边界要认清:它协调的是"事件/任务"的解耦与异步,不存"最终业务状态"(那仍是数据库的责任),也不能把"必须实时同步返回结果"的调用无脑改成异步(丢了实时性)。其次,引入队列等于多一套要运维、监控、保证可靠投递与幂等的基础设施,对"就两个服务、没有峰值"的小场景,直连反而更简单——判断"值不值得"要看有没有解耦/削峰的痛。最后,队列不能替代容灾:RabbitMQ 的集群/镜像要配置、数据要有备份,别把"队列"当成免死金牌。
把消息队列放回自托管整体:它是"消解直连耦合、削平瞬时峰值"的异步粘合层。落地要点:用 Docker 起 RabbitMQ 并理清"交换机→绑定→队列"三层模型;把高频同步调用改造成"发布确认 + 手动 ack + 死信 + 消费者幂等"式的可靠异步;防住积压、连接/频道、单点磁盘、缺监控四坑;并认清它管事件流动不替代数据库、小场景不必硬上、也不能替代容灾。当队列把一次动作的"多件异步事"从同步阻塞中解放出来,自托管的服务间协作才会既解耦、又能扛住瞬峰。
结语
RabbitMQ 消息队列的价值,是把服务间"牵一发动全身的同步直连"改造成"解耦、削峰、可缓冲的异步流动"。落地要点:先理清 Exchange→Binding→Queue 三层模型与 direct/fanout/topic 三类交换机;把直连改成队列时,用"发布确认 + 手动 ack + 死信队列"保证可靠投递,用消费者幂等应对重复,用"先落库再发消息"避免数据写了消息丢;防住消息积压、连接/Channel 滥用、单点磁盘、缺监控四坑;并认清它管事件流动、不替代数据库、小场景不必硬上、更替代不了容灾。当"一个动作触发的一串异步事"被队列安稳地调度起来,自托管的服务间才算真正解耦,也才敢接下更高的瞬时流量。