自托管服务升级,最怕的是"一条命令上去,全站白屏"。直接在生产机上"停服务→换新版本→重启"这类粗暴升级,一旦新版本有问题,轻则服务起不来、数据要回滚,重则用户大面积受影响。运维越正规,越会引入"发布策略":让新版本先在小范围试,确认没问题再全量;或新旧并存、出问题几秒切回。这篇讲清发布策略的两种主流——蓝绿部署(Blue-Green)与灰度发布(Canary/金丝雀)解决什么、各适合什么场景、怎么在 Compose/K8s 上落地,以及常见坑与边界。
一、蓝绿与灰度解决什么:让"升级从风险动作"变成"可回退动作"
传统的原地替换升级,把"发布"做成了一次不可回退的高风险操作:新版本起不来你就得现场改、现场救,用户在这个过程中一直受罪。发布策略的核心思想是"别在同一个运行着流量的地方直接换":要么先准备好一套全新的(蓝绿),要么让新版本先只接一小部分流量试试(灰度)。它们共同的价值是把"上线"从"一把梭的赌博"变成"可观测、可回退、对用户无感的流程"——有问题时几秒钟切回旧版,而不是手忙脚乱地抢救。
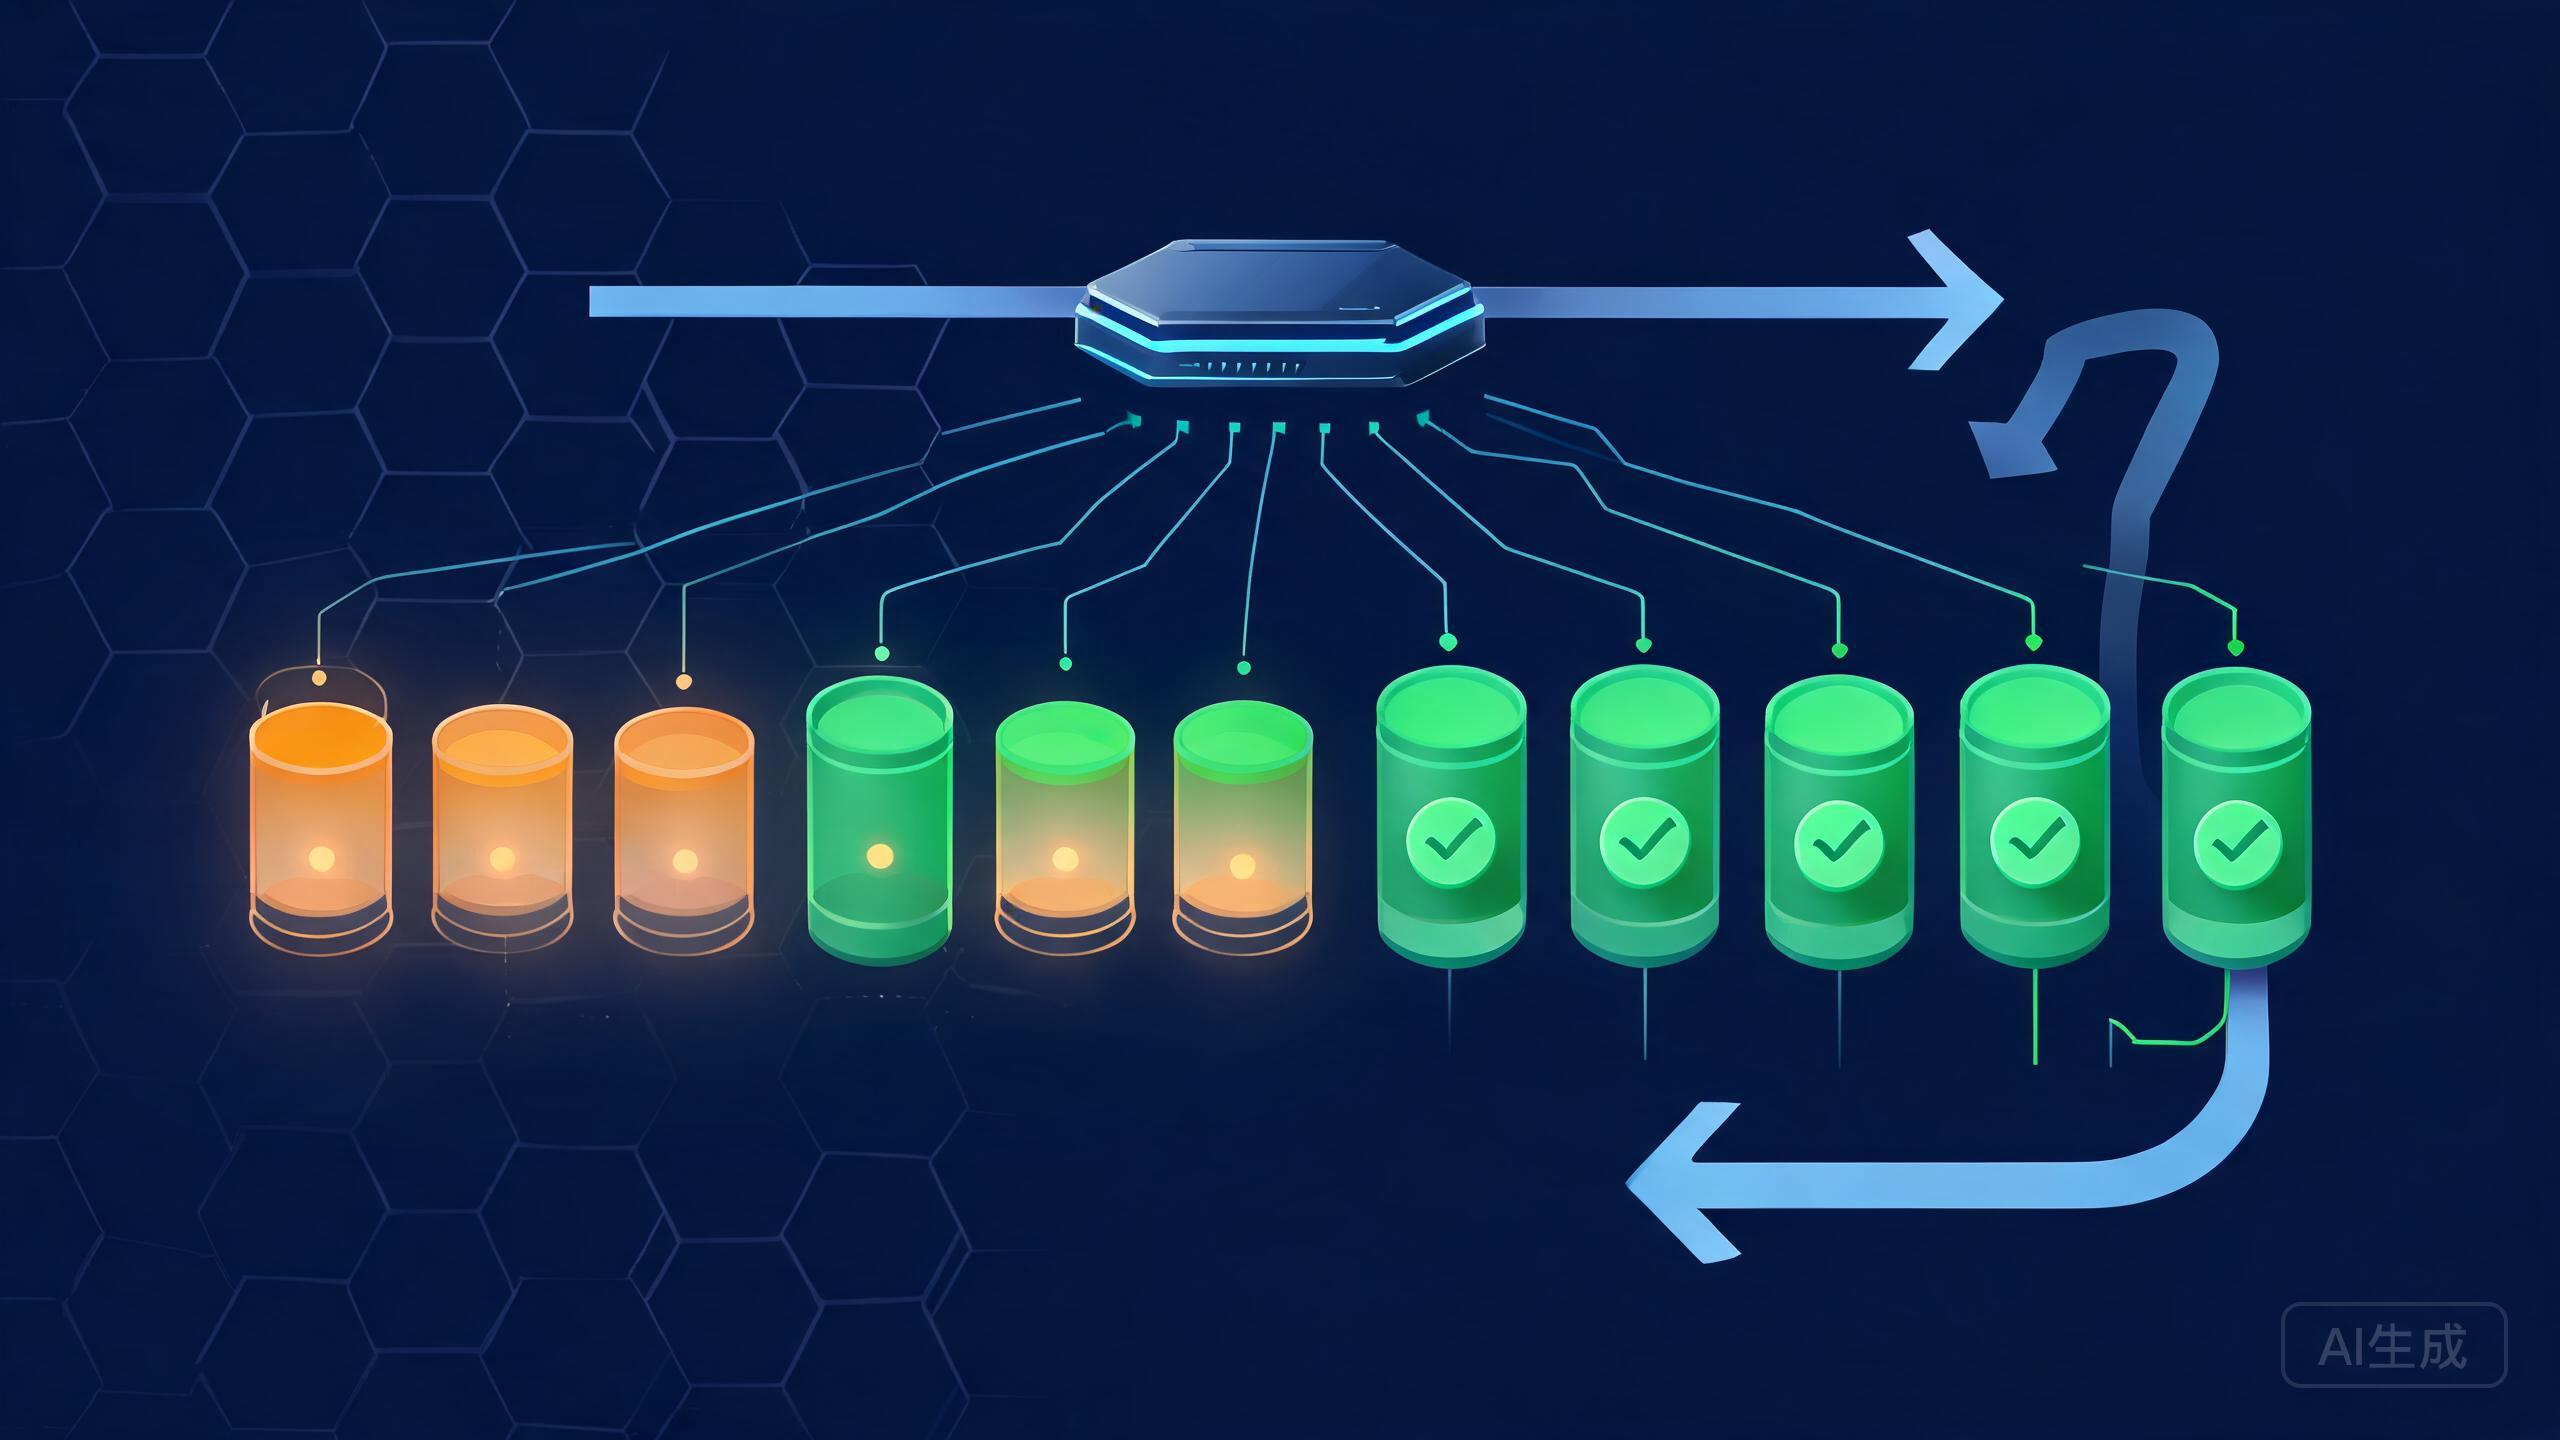
两者定位略有不同:蓝绿更简单粗暴——同时维护"蓝(旧)绿(新)"两套环境,切流量靠一步"切换路由",回退也只是一步切回去;灰度更细腻——新旧并存,先放 1%~5% 用户到新版本观察,再逐步放量到全量,期间可以把出问题的节点剔除。选型的判断:小服务、想最简单、能接受"两倍资源"→ 蓝绿;要精细、想先小范围验证、不想要双倍环境 → 灰度。
二、蓝绿部署落地:两套环境 + 一步切换路由
蓝绿的最小实现是:目的里同时跑"旧版"与"新版"两套,用一个入口路由(VIP/反代/网关)把流量切到当前活跃的那套。升级流程:先部署并把新版本(绿)拉起来、跑通健康检查,确认它没问题;然后把入口流量从蓝切到绿;同时保留蓝套以备回退——一旦绿出问题,一步切回蓝。对自托管,最朴素的落地就是"nginx 反代指向两个上游、切换只需改 upstream 或利用变量",配合 systemd/Compose 各自维护服务实例。
# nginx 做蓝绿切换的朴素示意:upstream 指到活跃的那套
upstream app {
  server 127.0.0.1:8081;   # 蓝(旧)
  # server 127.0.0.1:8082;  # 绿(新)   // 切换时改这里再 reload
}
# 切到新版时:把 8082 打开、8081 注释,然后 nginx -s reload
# 出问题时:把它切回去(把 8081 打开、8082 注释),秒级回退
蓝绿的关键约束是"两套环境要真是并行的、打包一致":蓝绿不适用于"数据库共用一份且架构不兼容"的迁移,也怕"两套环境资源不够"导致并行跑不动。但它的优点也很直接——切换/回退都是"改一个上游再 reload"这种极低风险的原子动作,对用户几乎无感。适合多数自托管"一台机上跑服务、升级想稳妥"的场景。
三、灰度发布落地:新旧并存 + 小步放量 + 自动剔除
灰度(Canary)更精细:不让新版本一下接管全部流量,而是先放一小部分(按权重、按特定用户/网络/IP)到新版本上观察效果,然后逐步扩大。它的好处是"风险被控制在可忽略的范围":就算新版本有隐藏 bug,也只会影响被灰度到的 1% 用户,且可随时剔除。落地方式:在反代/网关里按权重分配(如 5% 到新版本),或用 Kubernetes 的 deployment strategy 的滚动/金丝雀更新;配合监控对照新旧版本的错误率、延迟、成功率,决定"继续放量、还是回滚"。
# nginx 按权重灰度示意:先放 5% 流量到新版
upstream app {
  server 127.0.0.1:8081 weight=95;   # 旧版 95%
  server 127.0.0.1:8082 weight=5;    # 新版 5%(金丝雀)
}
# 观察稳定后调到 50/50,最后 0/100 全量;出问题则调回 100/0 下线新版

# Kubernetes 金丝雀:Deployment 配滚动更新,控制 maxSurge/maxUnavailable
#   strategy: { rollingUpdate: { maxUnavailable: 0, maxSurge: 1 } }
#   实现"新旧并存、逐个滚动",配合探针自动停掉失败的新 Pod
灰度做得好不好,取决于"你拿什么标准判断该不该放量"。这就要有数据:把新旧版本的错误率、P95 延迟、成功率分别打点,灰度期间对比,错误率异常就自动剔除新版本、退回旧版本。没有这套观测,灰度就只剩"听天由命地放量"。所以灰度与可观测性是绑定的——先有指标与告警,再谈小步放量;没有观测就乖乖用蓝绿这种更保守的。
四、常见坑:数据库兼容、回退不彻底、灰度误伤与资源
发布策略做起来,四个坑必然要防。一是"数据库/数据兼容":新旧版本共用同一份数据库时,新版本改了表结构/数据格式,旧版本可能读不了——发布与回退都要考虑数据层面的向前向后兼容,别只顾代码层切流量。二是"回退不彻底":切回旧版前,确保新版产生的副作用(写坏了的数据、改了的配置)也被处理,真回退不等于"切流量就完事",要演练过回退路径。三是"灰度误伤小部分用户也要负责":被灰度的如果正好是核心路径被踩中,要能尽快剔除与告警,别让 1% 的出问题拖成所有用户都感知。四是"资源与复杂度":蓝绿要两倍资源、灰度要监控与编排,小服务硬上会得不偿失——先判断"这个升级到底风险多大、值不值得上策略"。
# 回退演练的思想:切换/回退都应是"改一个配置 + reload"的极低风险动作
# 平时就把这两个动作在测试环境练熟,别在出问题当天才第一次做
#   systemctl reload nginx    # 蓝绿/灰度切流
#   配合把"当前活跃版本 + 可回退版本"记录下来,回退才有据
把这当排障 SOP:切流前先确认"新旧都健康、数据兼容",切流后看"新版本错误率/延迟是否正常",出问题先"原子切回"再"深入定位"——别在线上一边救火一边做诊断。发布策略的价值是降低风险,而它的前提是你把"切换/回退"本身演练到无脑可靠。
五、边界:发布策略降低上线风险,不替代测试与备份
发布策略的边界要认清:蓝绿/灰度降低的是"上线过程对用户的影响",但它不替代测试(代码没测过、数据没核对照样会带病发布)、也不替代备份(数据被别人写坏、策略也救不回来)。其次是它适配"无状态/可并行的服务"最好,对有状态、资源紧张、单实例小服务要掂量复杂度与成本。最后,策略本身要简单可执行——复杂到没人会用、没人想维护的发布流程,最终会退化回"直接一把梭"。
把发布策略放回自托管整体看:它把"升级"从高风险的赌博动作,升级为"小步试、可回退、有观测"的工程流程。落地要点:蓝绿适合"想最简单、能接受两倍资源",用"两套环境 + 一步切路由"实现秒级切换回退;灰度适合"想先小范围验证、有监控数据",按权重小步放量并靠错误率/延迟自动决定进退;无论哪种都要处理好"数据兼容、回退演练、被灰度用户的负责、资源成本"四坑,并认清它不替代测试与备份。当你把发布变成"可观测、可回退、对用户无感"的流程,自托管升级才会从"心惊胆战"走向"从容切换"。
结语
蓝绿部署与灰度发布的价值,是把"上线升级"从高风险、不可回退的一把梭,变成"小步试、可回退、有观测、对用户无感"的工程化流程。落地要点:蓝绿用"两套环境 + 一步切路由 + nginx/Compose 实现"换秒级可靠回退,适合想最简单、能接受两倍资源的场景;灰度用"新旧并存 + 权重小步放量 + 错误率/延迟观测决定进退 + K8s 上滚动更新"实现精细控制,适合想先小范围验证的场景。始终把数据库兼容、回退演练、被灰度用户负责、资源成本四件事处理好,并认清发布策略降低的是上线风险而非替代测试与备份——当发布变得可观测可回退,自托管的迭代才谈得上稳妥与从容。