数据库是自托管栈里最不能"停了就重启一下"的东西。前面聊过 Redis 可以靠主从 + Sentinel 自动恢复,PostgreSQL 也一样有主从复制与高可用方案,只不过它的机制和 Redis 不同、配置也更讲究。这篇把它讲清楚:PostgreSQL 的主从复制到底复制什么、同步与异步各有什么取舍、怎么手工配出一主一从、以及要真正自动化故障切换时,该往 repmgr/Patroni 那套方向走。目标是让你分清"有从库"和"高可用"差在哪一手。
一、先懂 PostgreSQL 的复制机制:WAL 是一切的基础
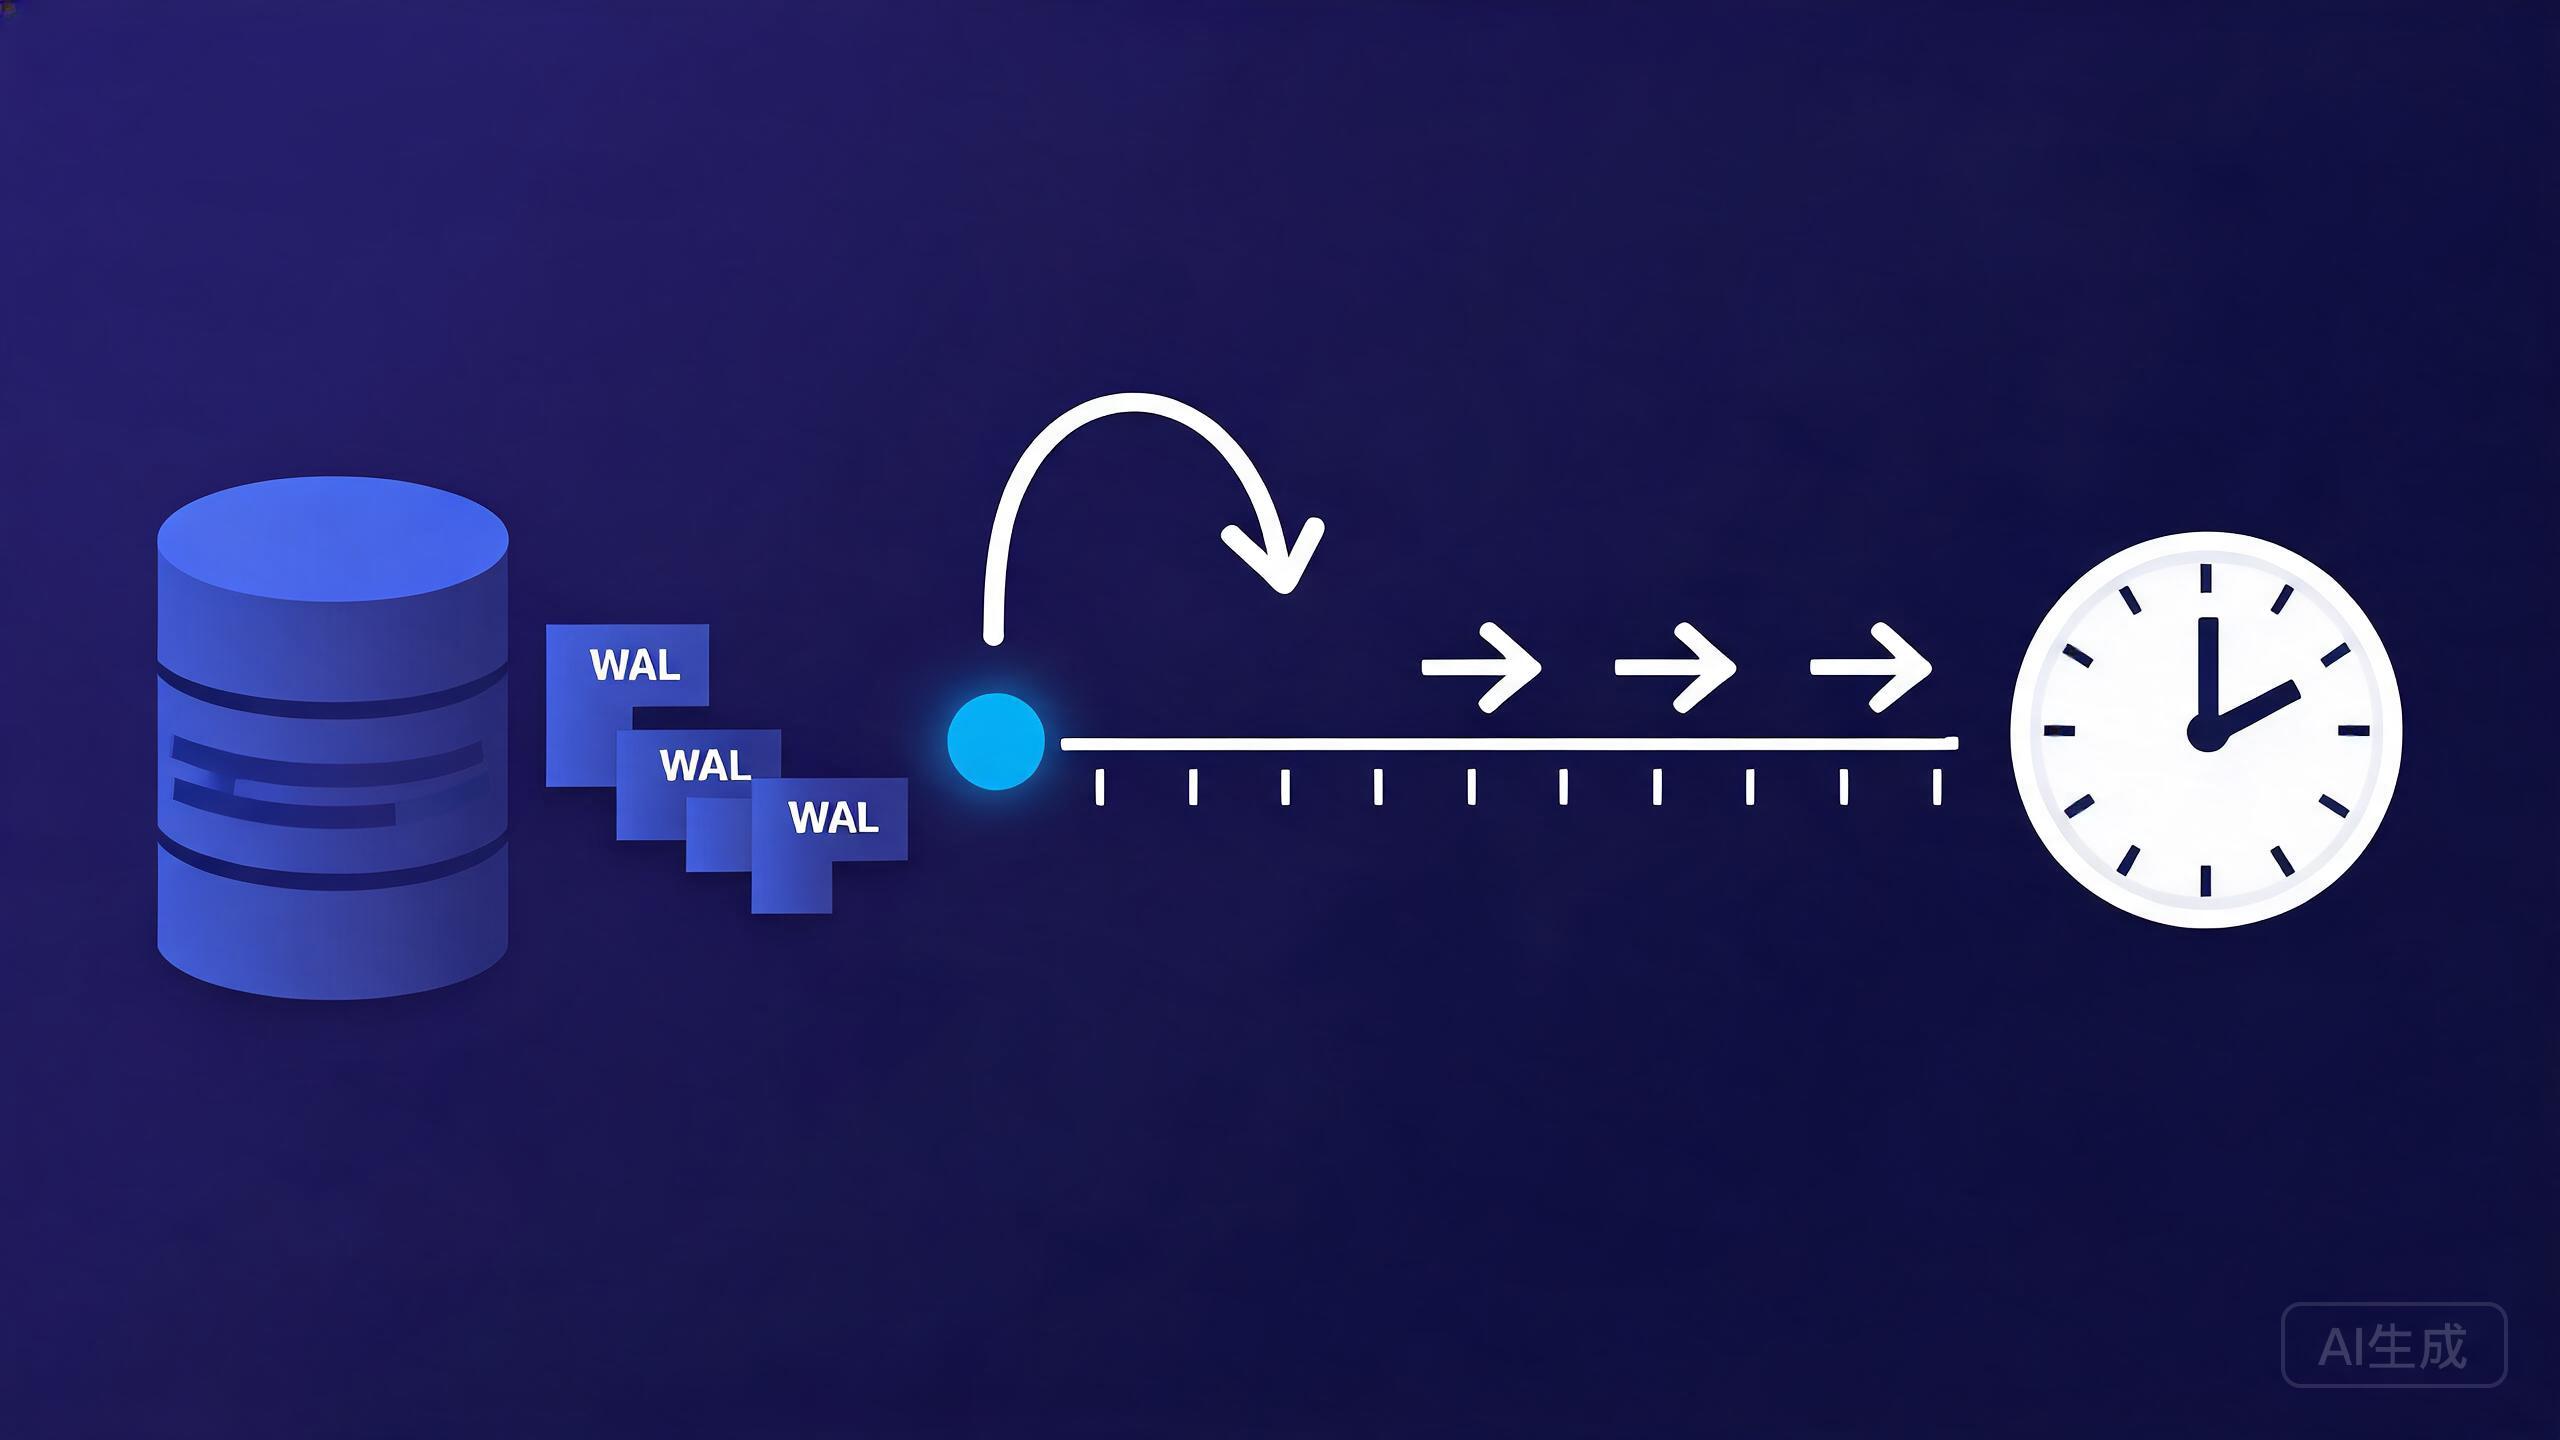
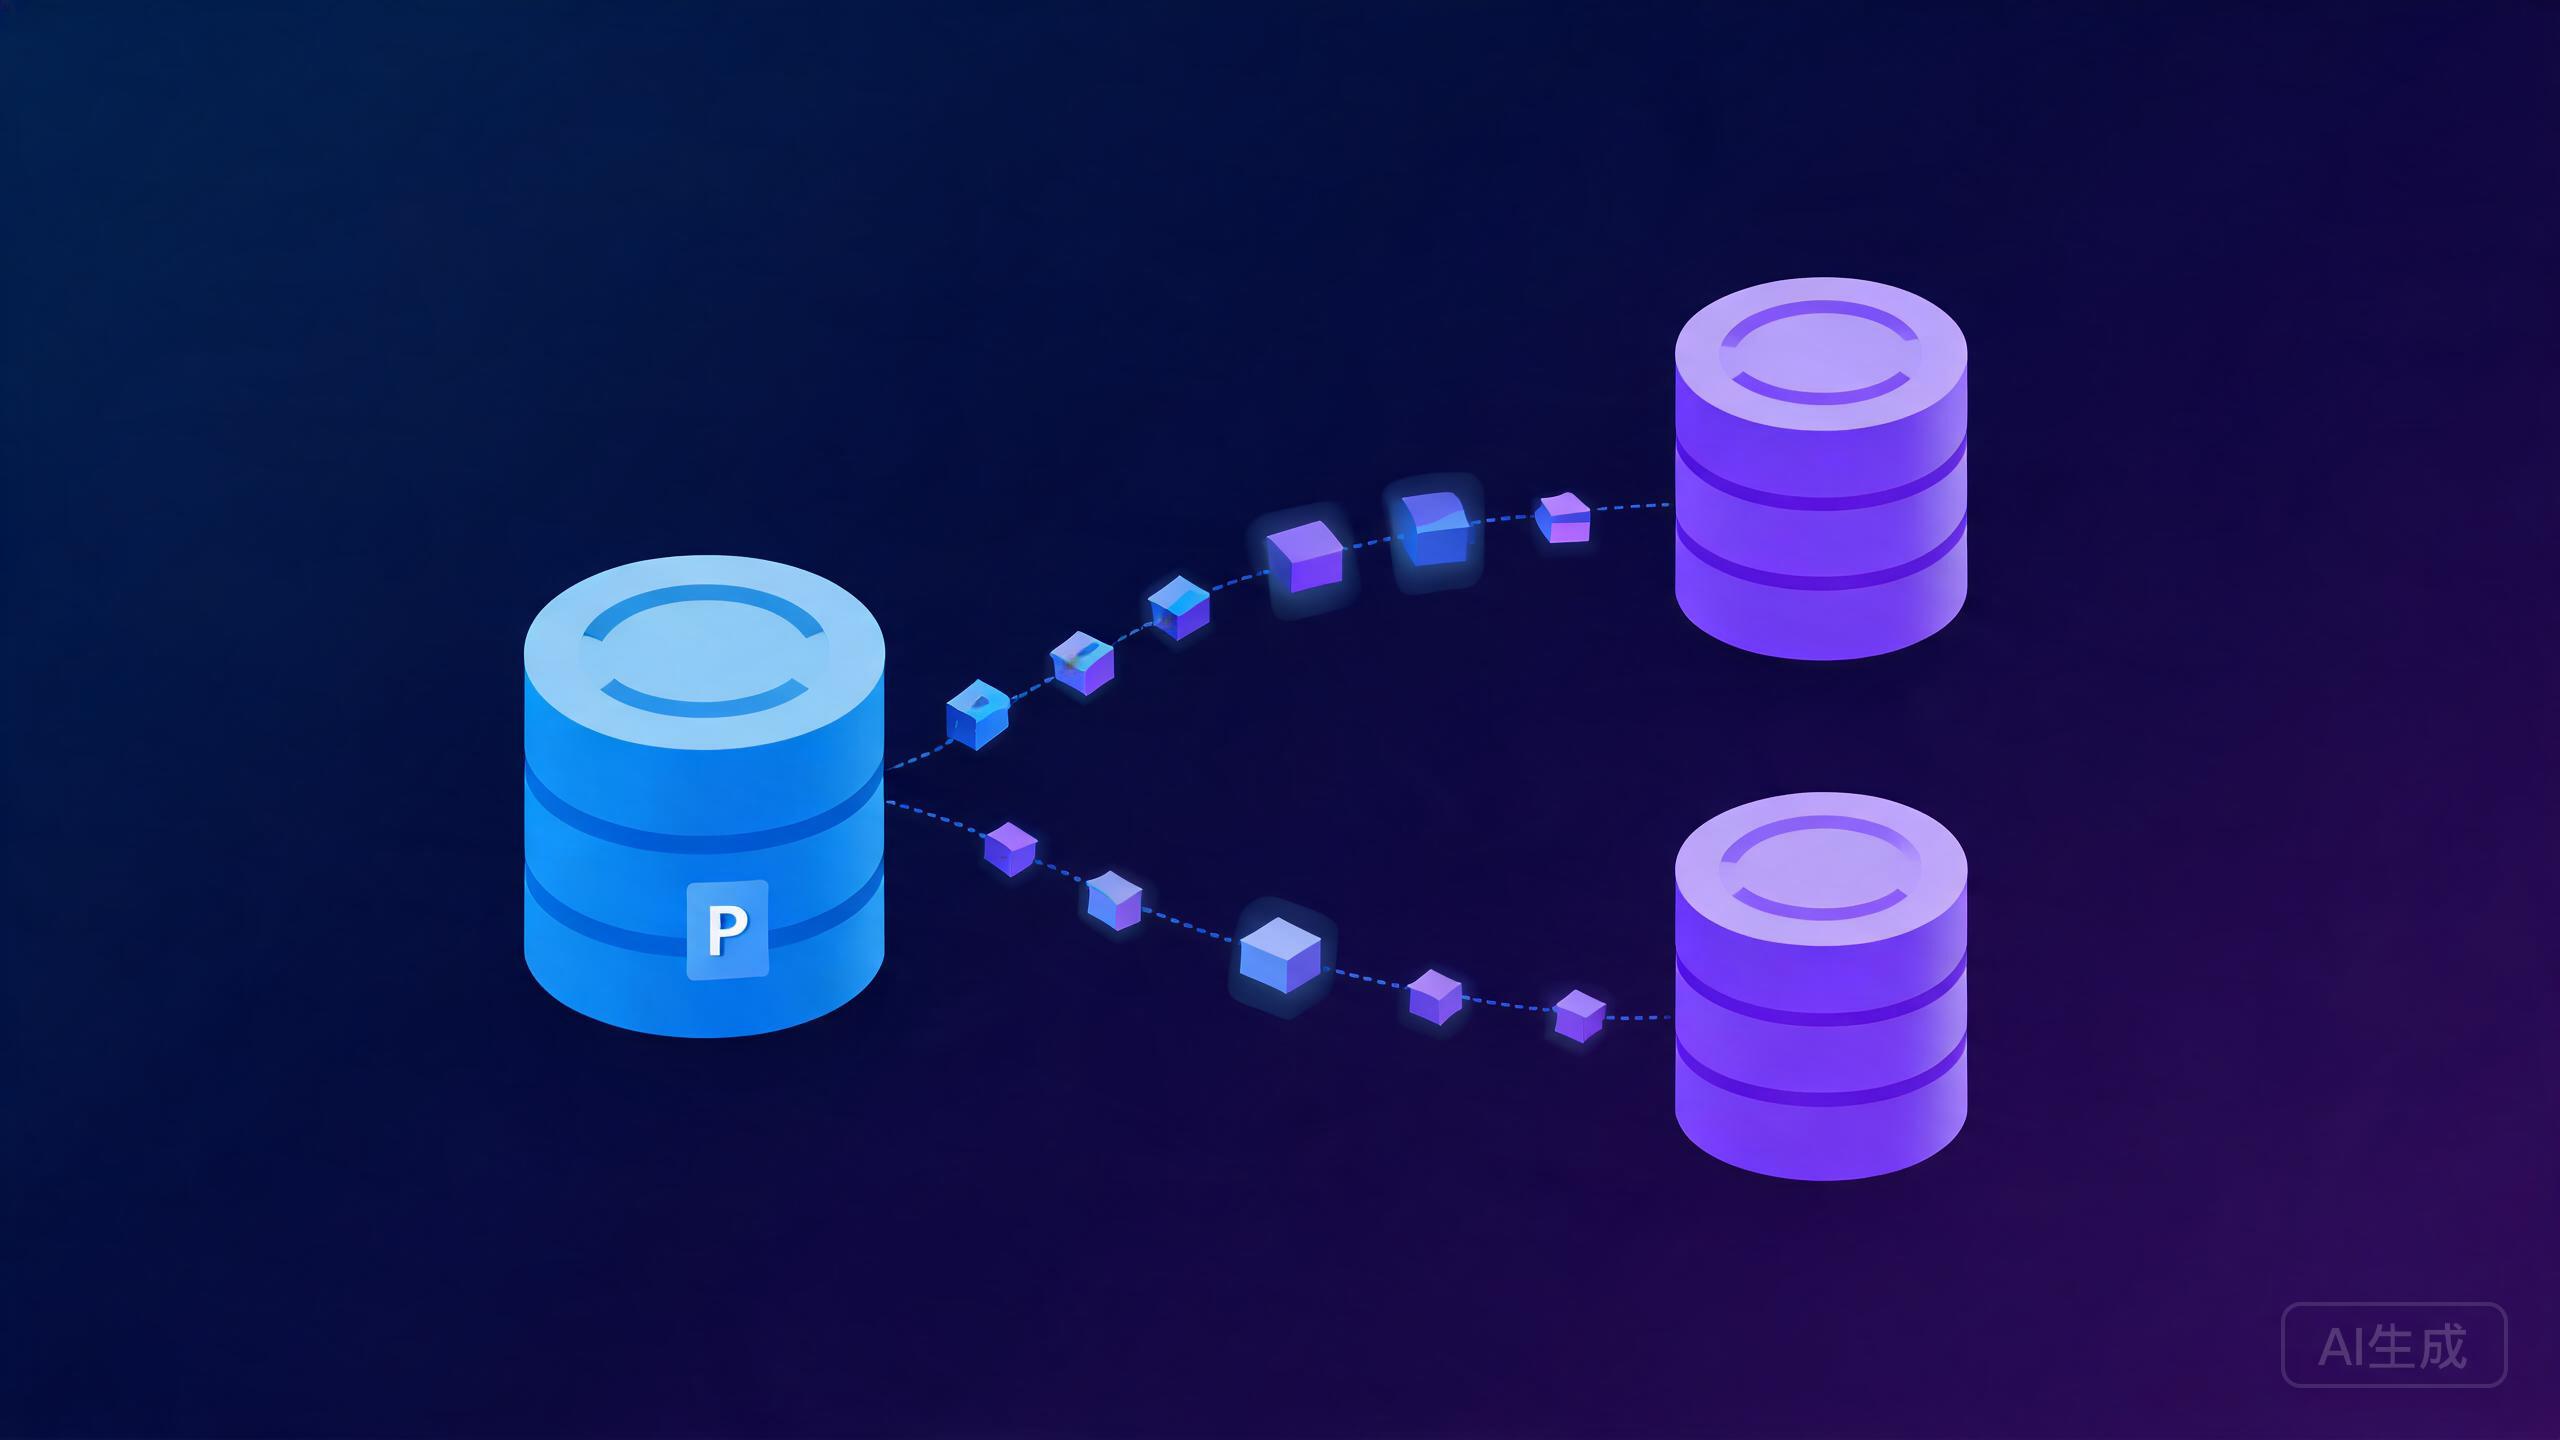
PostgreSQL 的主从复制,本质是"把主库的 WAL 日志(预写日志)同步给从库去重放"。每当数据库要写数据,它先把变更记录进 WAL,再从 WAL 落盘到数据文件。主库把这些 WAL 片段流式发送给从库,从库据此重建出一份几乎相同的数据副本。这套"基于 WAL 的流复制"(streaming replication)是理解一切后续配置的前提。
由此得到两个直接推论。其一,从库读到的数据"几乎同步"但并非逐字节一致——它会落后主库一小段 WAL,这个差异叫"复制延迟";其二,流复制是单向的(主入库数据 → 从库),所有写请求都必须在主库上完成,从库通常以只读(hot standby)方式对外提供读。理解了这两点,才能明白为什么"加了从库"不等于"数据库高可用":它解决了"读的可用性/单点读负载",但没解决"主挂了谁接手写"。
二、主库开启复制:WAL 级别与复制角色
在主库上做复制,要先在 postgresql.conf 打开相关项并准备一个专用复制账号。两个最关键的参数是 wal_level 和用于流复制的槽位:
# 主库 postgresql.conf
wal_level = replica          # 允许多个从库流复制
max_wal_senders = 10
max_replication_slots = 5    # 预先建好槽位,防止 WAL 被提前回收
hot_standby = on             # 让从库可以只读访问

# 建一个只用于复制的账号(用 psql 执行)
CREATE ROLE repuser WITH REPLICATION LOGIN PASSWORD '强的复制口令';
这里有个少有人提但很关键的细节是 max_replication_slots 与复制槽(replication slot):如果不建槽位,主库可能在"从库暂时落后"时提前回收 WAL,导致从库追不上来只能重建;建了槽位则保证 WAL 保留到从库取走。槽位因此是"保障复制不中断"的保险丝——代价是如果从库长期断连,主库的 WAL 会一直积累占满磁盘,所以要用监控盯住它。
三、从库:先用基础备份起一个副本
起一个从库,关键是"用主库的一个一致快照作为起点",而不是建一个空库。标准做法是用 pg_basebackup 从主库拉一份基础备份,再把它设成单机恢复以跟随主库:
# 在从库机器上,从主库拉取基础备份
pg_basebackup -h 192.168.1.10 -U repuser \
  -D /var/lib/postgresql/data -P -R \
  -X stream
# -R 会自动生成 standby.signal,让实例以"待机"身份启动并从主库流复制
-D 指定数据目录,-X stream 表示在备份过程中持续拉取 WAL,避免起点之后的数据缺口。备份完成后启动 PostgreSQL,它会自动连接主库、持续接收 WAL 并进入只读待机状态。一个容易踩的坑是数据目录权限与路径要和配置一致,否则实例起不来;另一个常识是主从之间要做好网络与端口连通,流复制占用 5432 同一条通道。
四、同步复制 vs 异步复制:丢数据的窗口由你选
PostgreSQL 的复制分为同步与异步,区别直接决定了"主库宕机时最多丢多少数据"。异步复制:主库写成功即返回,复制在后台进行,主库突然宕机时可能丢最近的几条提交。同步复制:主库等确认从库已写入才向客户端返回成功,数据不丢,但代价是主库的写入延迟变成"至少一个网络往返",以及当从库不可达时主库写入会被卡住。
# 主库把某个从库提升为"同步优先"
synchronous_standby_names = 'replica1'
synchronous_commit = on
实践里通常的取舍是:读多写少的自托管场景用异步复制已足够,把"可能丢最近几条"当成可接受的窗口,换来主库写入不受从库牵制;对必须不丢数据的关键业务,才启用同步复制并接受延迟。理解"复制方式选的是丢数据窗口而不是别的",比死记某个配置更关键——所有高可用讨论到根上都在回答这个取舍。
五、从"有从库"到"高可用":自动故障切换接手"主挂了怎么办"
加了从库、配好复制之后,你的状态是"主挂了,仍有副本,但要手动把从库提升为新主(promote)再改应用连接地址"。这离"高可用"还差最关键的一手:谁来发现主挂了、谁来自动提升从库、谁来告诉客户端新的主是谁。这正是 repmgr、Patroni 这类工具存在的意义。
repmgr 偏轻:它管理节点注册、监控复制健康、提供 repmgr standby promote 手动或配合外部触发器做自动提升。Patroni 更完整:它用分布式一致性存储(etcd/Consul/ZooKeeper)在多个节点间选主、自动故障转移、并管理复制槽,是生产级 PostgreSQL 高可用的主流。无论选哪个,目标都是把那个"主挂了没人接手写"的单点接管掉,把可用性从"等运维来救"提升到"几十秒自动切换"。代价是这套控制面本身要部署和运维,复杂度比"单主单从"高一个量级——自托管规模要权衡是不是每次都需要。
六、别以为有了从库就万事大吉:延迟、槽位与备份
最后提醒三个容易被低估的点。一是复制延迟要监控:从库追赶不上(比如主库写量大而网络差)时,读到的是旧数据,业务要接受这种延迟一致性。二是复制槽要盯住:从库长期断连会导致主库 WAL 堆积撑爆磁盘,这是生产事故的常见来源。三是从库不是备份的替代品:它提供的是"操作上的冗余",不是"防误删、防挖矿"的灾备——被误删的数据会同样复制到从库。真正能恢复误删的,仍然是定期的物理备份(pg_dump 逻辑备份或基于 WAL 的 PITR),所以"主从 + 备份"要一起上,缺一不可。
结语
PostgreSQL 主从的实质,是"用 WAL 流复制造出一个几乎同步的只读副本",先解决"读的冗余",再用同步/异步的选择来决定丢数据的窗口。而把"有从库"升级成"高可用",靠的是 repmgr/Patroni 这套自动故障转移控制面,去接管"主挂了谁来写"这个单点。落地顺序大体是:主库开 WAL 复制并建槽位 → pg_basebackup 起从库 → 决定同步/异步与延迟预期 → 按需引入自动故障切换。牢记"从库不是备份"和"槽位要监控"这两条,你的数据库层才算既高可用又可恢复,而不是只是多了一台看着热闹的副本。