上一轮我们给 Typecho 提过"用 Redis 做对象缓存",但 Redis 远不止是"一个能放内存的字典"。它既是缓存、是消息队列的零件,也能靠持久化与主从复制撑起高可用。很多自托管的人把 Redis 当便利贴用,文件一崩就重启清空,把缓存的"内存性质"误当成"它的全部"。这篇把 Redis 拆开讲清楚:它的数据结构能解决哪些问题、两种持久化各有什么代价、主从复制与 Sentinel 怎么撑起高可用,以及部署在 Docker 里要注意的坑。
一、先分清一件事:Redis 不是"只能当缓存"的字典
Redis 之所以常被用成缓存,是因为它把所有数据放在内存里读写极快。但它真正的价值在于原生的数据结构:String(字符串)、Hash(哈希)、List(列表)、Set(集合)、Sorted Set(有序集合)。同样一个需求,用对结构能省几十倍代码。举几个直白的例子:计数器用 INCR(点赞数、点击量)、存储用户对象用 HGETALL、做"最近浏览"或消息队列用 LPUSH/BRPOP、去重和取交集用 SADD/SINTER(比如"哪些用户同时关注了两个话题")、排行榜和 TopN 用 ZADD/ZREVRANGE。用对结构,Redis 不再是"能启动的缓存",而是一个能承载具体业务语义的内存数据库。
在自托管场景里最常见的组合是:数据库(PostgreSQL/MySQL)负责可靠落盘,Redis 负责高频读的"热数据"。热点数据从 Redis 命中,冷数据才回数据库,这就是缓存最常见的命中路径。理解"Redis 是内存的"这句话的另一面是——内存贵且有限,不能把整库塞进去,要考虑淘汰策略(见第四节)和穿透/击穿/雪崩这些缓存经典问题。
二、两种持久化:RDB 与 AOF,谁快谁稳
把 Redis 当纯缓存用完了就清无所谓,但一旦承载计数器、登录态、排行榜这种"丢了要出问题"的数据,就必须开持久化。Redis 提供两套机制,理解它们的取舍才能选对。
RDB(快照)是把内存全量导出成二进制文件,按时间点定时(如每 5 分钟或每多少条写操作触发)保存。优点:文件小、载入快、适合做备份;缺点:两次快照之间的数据可能丢(崩溃后丢最近几分钟的写)。AOF(追加文件)是记录每条写命令并追加到日志,恢复时按日志重放。优点:数据丢失窗口小(可配每写一条就 fsync);缺点:文件更大、恢复更慢、写盘更频繁。
# redis.conf 相关配置
save 900 1        # RDB:900 秒内至少 1 次写就触发快照
save 300 10
save 60 10000

appendonly yes    # 开启 AOF
appendfsync everysec  # 每秒 fsync,性能与安全折中
业界常见的务实做法是 RDB + AOF 双开:Redis 载入时优先用修复过的 AOF 保证少丢数据,RDB 则承担"定期快照"的备份角色。真正的教训是——单独开 RDB、又把 save 时间拉得很长,等于把"崩溃最多丢多少数据"的按钮推给你自己。持久化的价值不是"开了就行",而是"你能接受崩溃后丢多少",并据此设置触发频率。
三、缓存怎么用才不坑:旁路缓存与过期策略
把 Redis 接进业务最常见的坑,不是不会连,而是"缓存与数据库的一致性"没想清楚。标准做法叫 Cache Aside(旁路缓存):读时先查 Redis,命中直接返回;未命中则查数据库、把结果写回 Redis 并设 TTL。写数据时先写数据库,再主动删除或更新对应缓存。这样读路径和写路径都不阻塞,数据库仍是唯一真相(source of truth),Redis 只是一个查得快的影子。
围绕这套模式要有意识地处理三个被反复提及的问题:穿透(查一个根本不存在的 key,每次都落到数据库)——解决方法是缓存空值或加布隆过滤器;击穿(热点 key 恰好过期,大量请求同时涌向数据库)——可以给热点 key 用"永不过期 + 后台主动更新"或加互斥锁重建;雪崩(大量 key 在同一时间集体过期)——把 TTL 错开加随机偏移,不设同一固定值。这三个问题处理与否,决定了"缓存从 90 分到 99 分"的距离——前者业务已经能用,后者才是生产环境该有的稳健。
四、内存不够怎么办:maxmemory 与淘汰策略
Redis 的数据全在内存,写满内存会写不进新 key。别让它"默默到死",要主动设上限和淘汰策略:
# redis.conf
maxmemory 256mb
maxmemory-policy allkeys-lru常见的淘汰策略有几种:allkeys-lru(整个 key 空间淘汰最久未使用)、volatile-lru(只淘汰设了 TTL 的 key)、allkeys-lfu(看重使用频率)、noeviction(写满直接报错,适合不能丢的平台数据)。选择逻辑很简单:如果你存的主要是"过期了没关系的缓存",用 allkeys;如果有些 key 是不能丢的业务状态,那就得留足内存并用不上淘汰,或交给 RDB/AOF 保底。真正的关键在于给 Redis 分配足够内存以防活活写挂,而不是等 OOM 了再救。
五、高可用起步:主从复制在 Docker 里的正确姿势
单机 Redis 一挂,依赖它的服务全部随之雪崩。高可用的第一层是主从复制:一台主(master)处理写请求并把数据异步复制给若干从(slave)做只读备份。配置从库就是在从节点的配置里指向主库的 IP 与端口:replicaof 192.168.1.10 6379。配成 Docker Compose 两个服务时,从库要把网络、持久化、以及"本机地址"处理对——从库若和主库挂在同一个 --network,announce-ip 要设成容器网络里的 IP 而不是宿主机 IP,否则复制握手会去连错地址。
services:
  redis-master:
    image: redis:7-alpine
    command: [ "redis-server", "--appendonly", "yes" ]
    volumes:
      - master_data:/data
  redis-slave:
    image: redis:7-alpine
    command: [ "redis-server", "--replicaof", "redis-master", "6379" ]
    depends_on:
      - redis-master
    volumes:
      - slave_data:/data
volumes:
  master_data: {}
  slave_data: {}
主从复制解决了"读的容量与冗余",但注意它默认是异步的:主节点写成功就先返回,复制没到位时主节点若挂了,会有少量数据丢失窗口。这就是为何高可用通常还要排在 Sentinel 之后——它负责在主节点挂掉时把从节点提升为主。
六、让"主挂了"自动恢复:Sentinel 哨兵架构
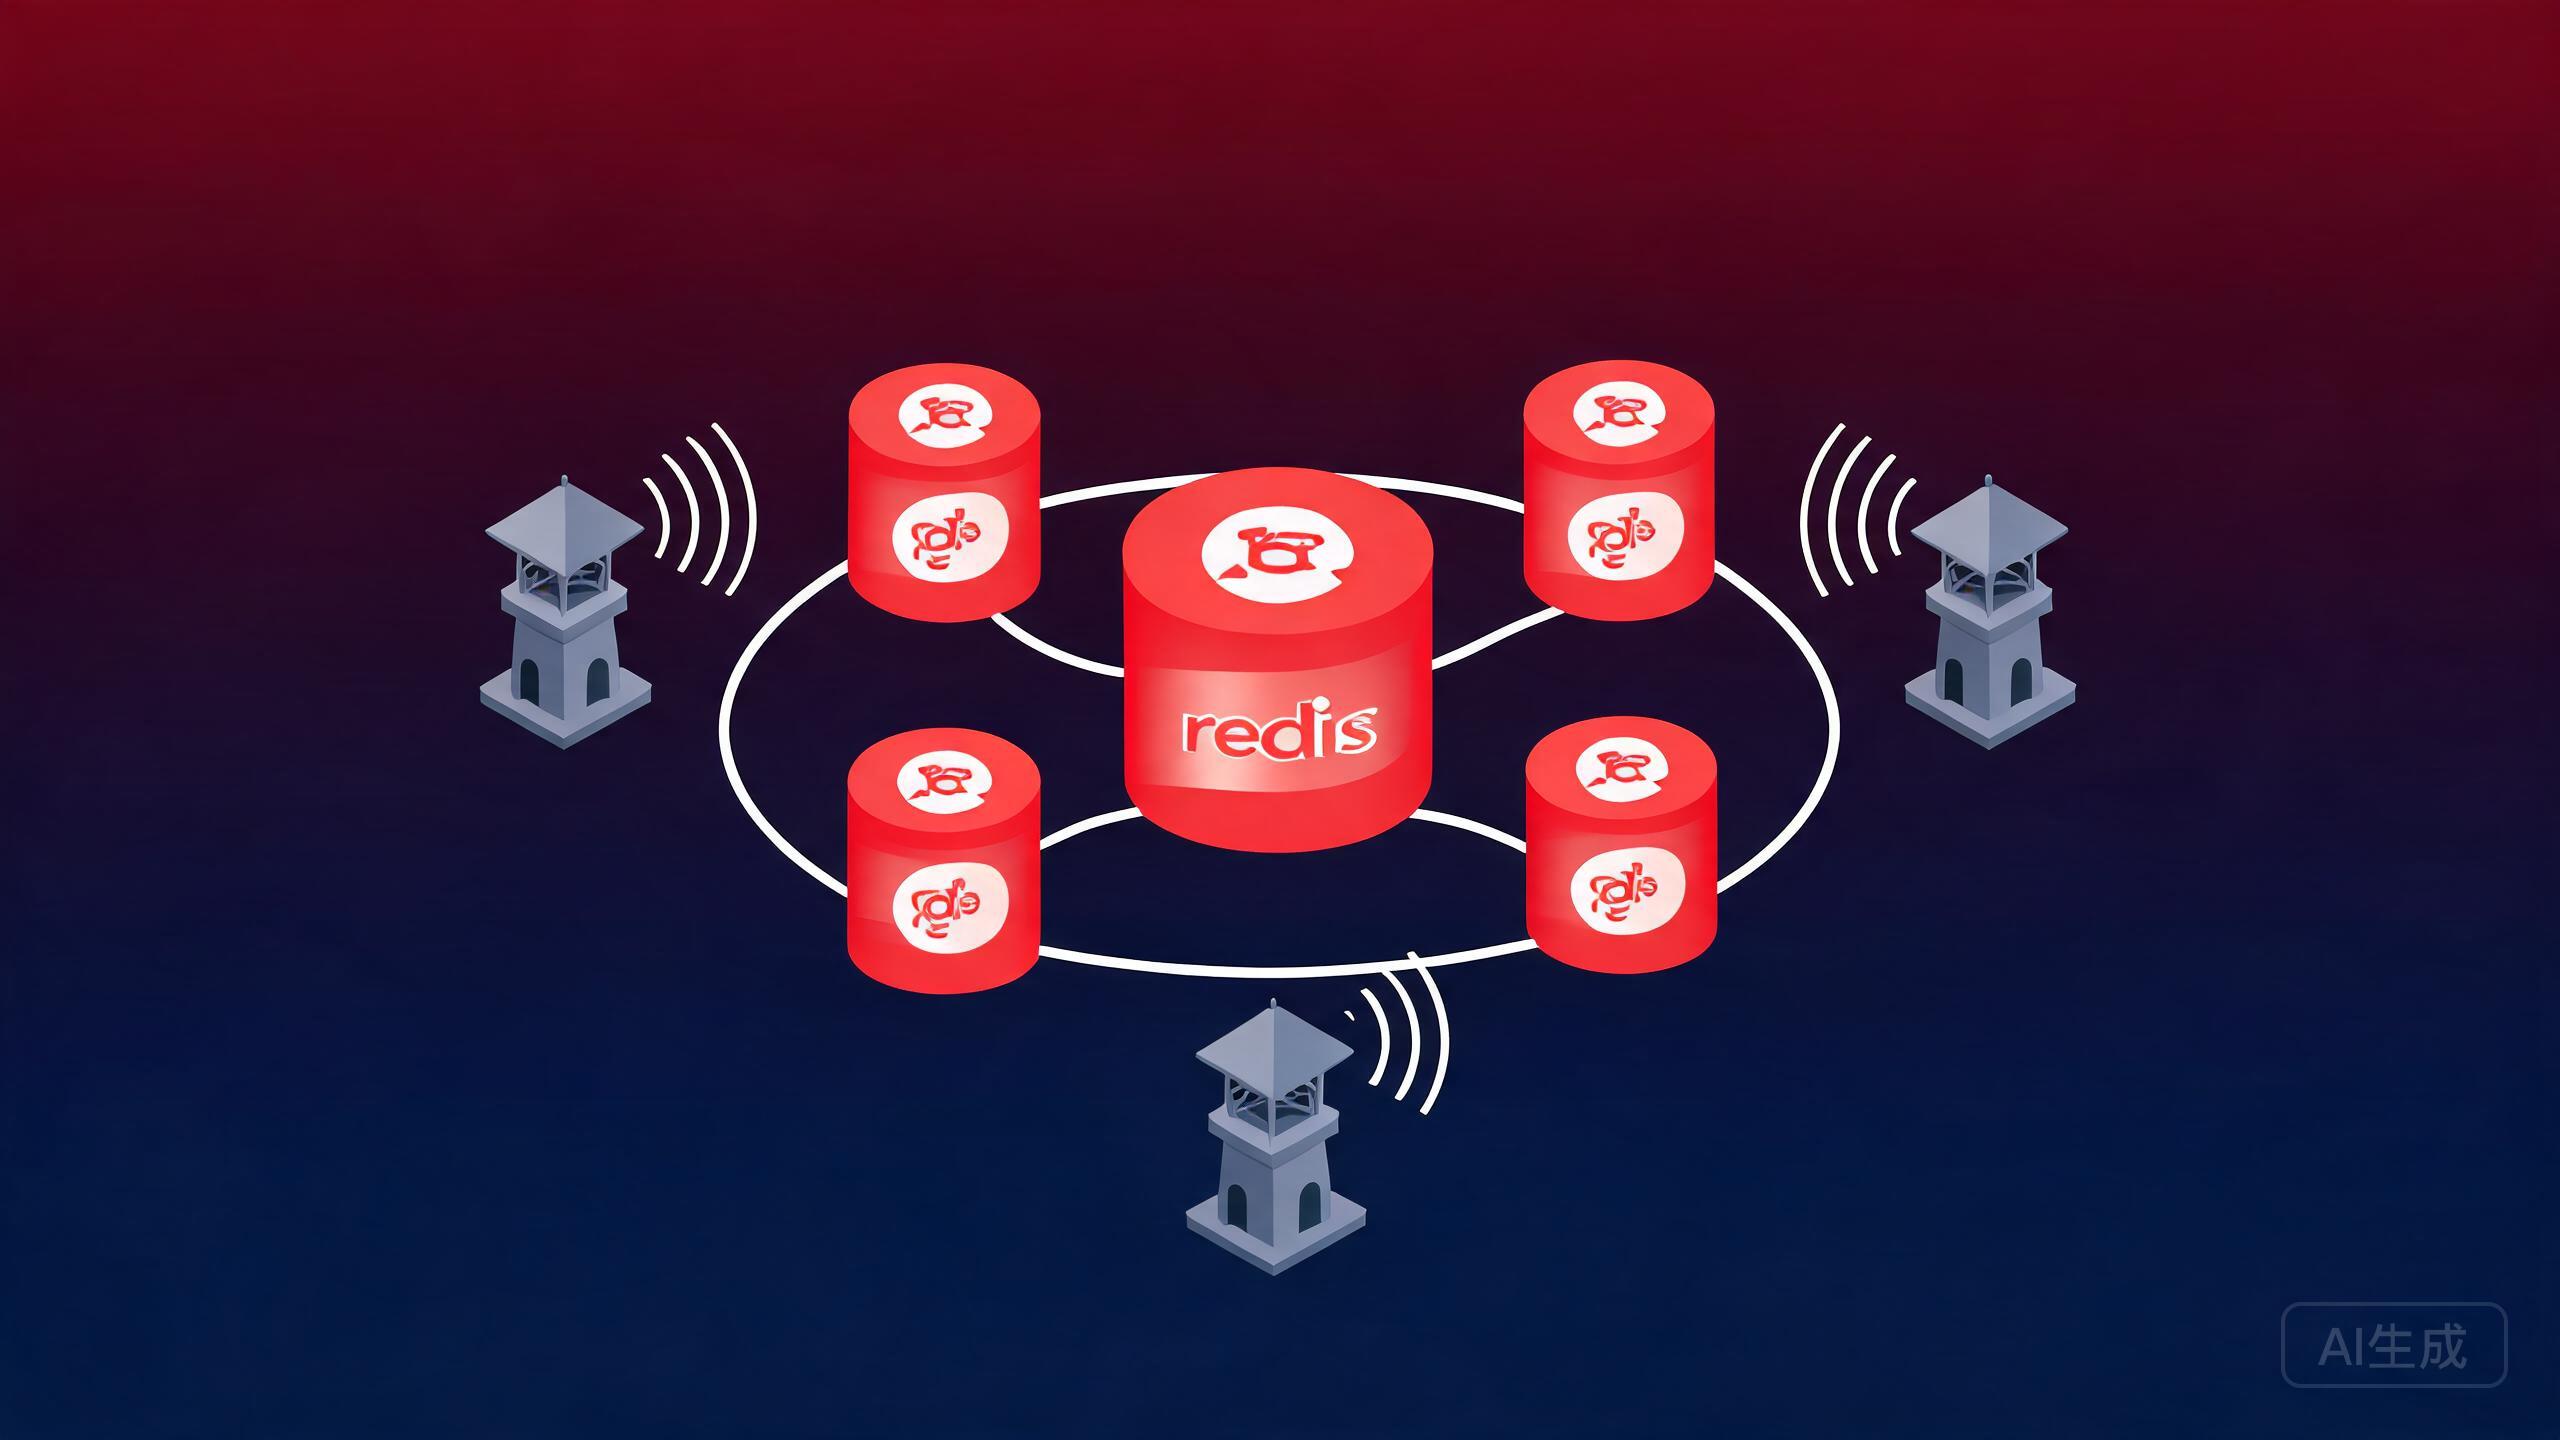
Sentinel 是一组独立进程(通常部署 3 个奇数个),它持续监控主从节点的健康,在主节点不可达时执行故障转移(failover):选一个从提升为新主,并把其他从指向新的主,客户端则通过 Sentinel 动态获取"当前主是谁"。这套"3 个哨兵 + 一主多从"的架构,避免了一个关键单点——客户端不再死记主节点的地址,而是问哨兵。奇数个哨兵参与投票是为了在脑裂时用多数达成一致。
# sentinel.conf
sentinel monitor mymaster 192.168.1.10 6379 2
sentinel down-after-milliseconds mymaster 5000
sentinel failover-timeout mymaster 60000
实践里要留意的边界是两个"窗口":一是故障转移期间(几十秒)服务不可写,业务要能容忍这个间歇;二是主从复制是异步的,极端情况下可能丢几条写。没有完美的高可用,Sentinel 给的是"几分钟按键重启"变成"几十秒自动切换"的可用性跃迁。若希望不丢任何写,那要进入哨兵 + 客户端写 Redis Cluster 的领域,复杂度又上一个台阶,自托管规模通常用不到。
结语
Redis 在自托管栈里的正确位置,是"把高频读的热数据从数据库里替出来"的加速器,身份可以从"便利贴缓存"一路升级到"带语义的内存数据库 + 高可用服务"。用对数据结构解决具体问题,用 RDB + AOF 守住持久化的底线,用 Cache Aside 管住一致性,用 maxmemory 把内存边界画清楚,最后用一主多从 + Sentinel 把它从"单点"变成"自动恢复"。每一层都在回答"某一台 Redis 挂了会发生什么"——回答得越透,你的服务就越不至于被一次缓存崩溃拖下水。