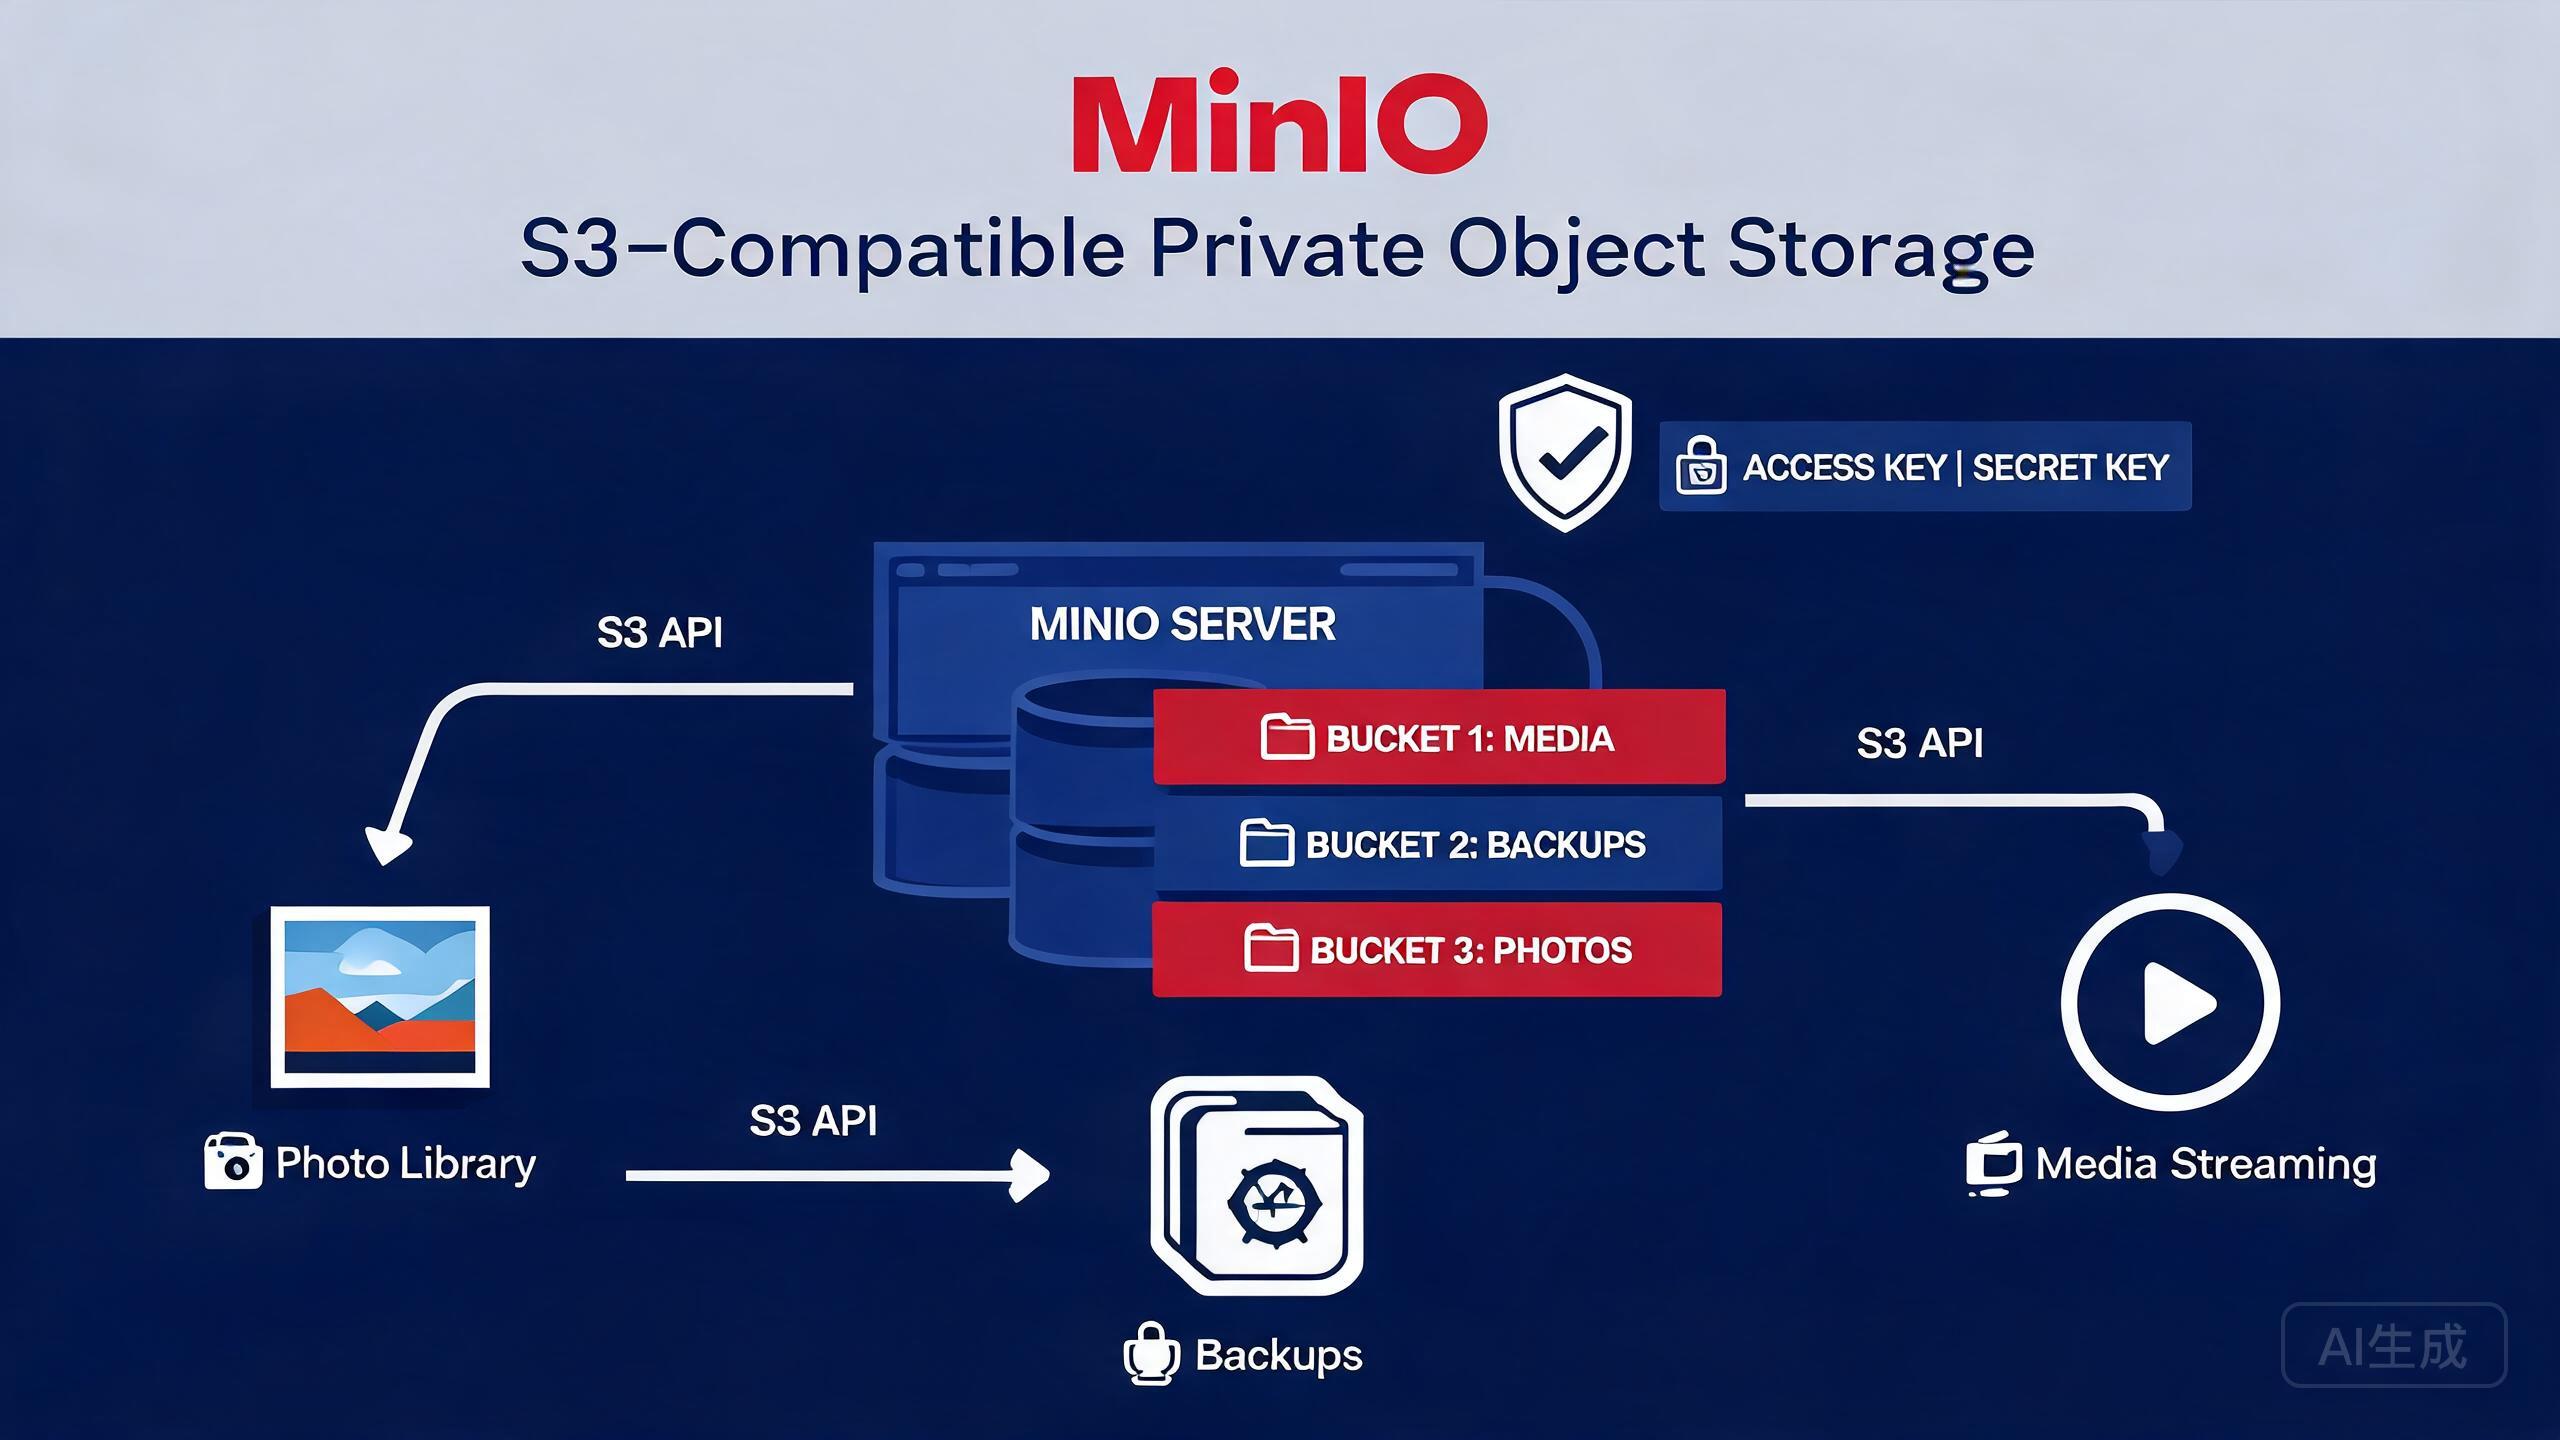
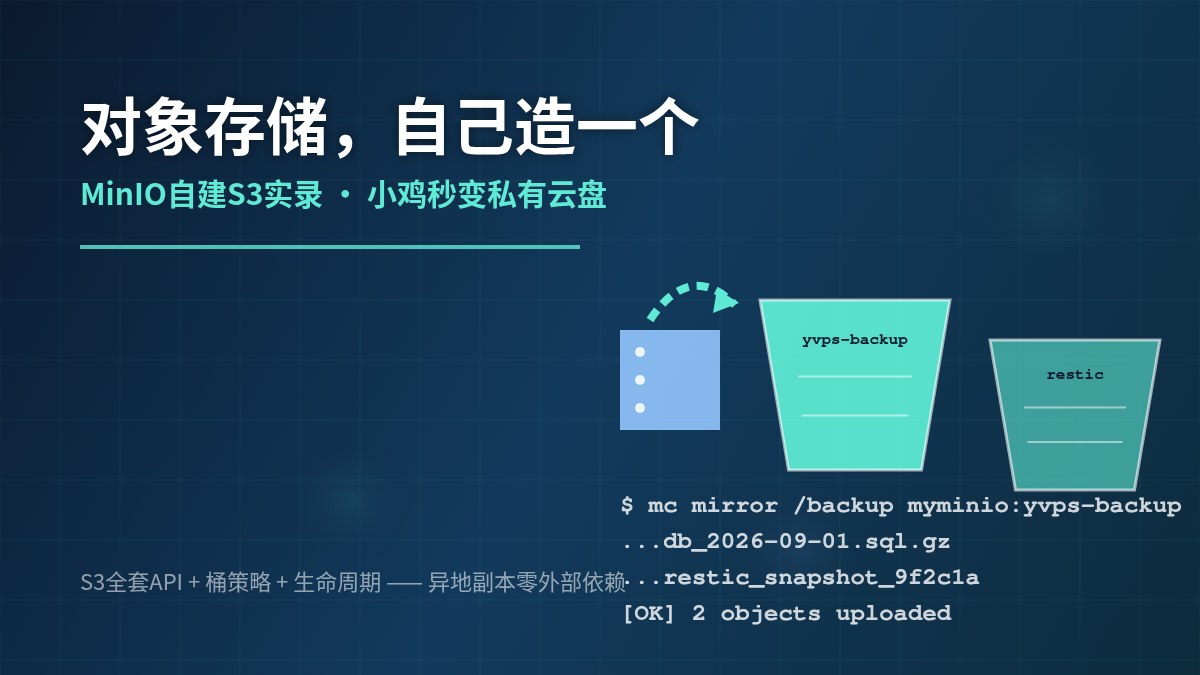
自托管的照片、备份、文件、媒体,散落在不同的目录和进程里,没有一个统一的地方安置。传统的"挂一块盘、建一堆目录"在小规模够用,一旦要跨机器、要自动化备份、要对外提供一致的访问接口,就暴露了短板。对象存储用"桶(bucket)+ 对象(object)"的扁平模型管理海量数据,MinIO 是把它跑在自托管环境里最常用的实现——它兼容 AWS S3 API,几乎所有生态工具(rclone、NextCloud、各类应用的内置存储)都能直接接进来。这篇讲清对象存储是什么、MinIO 怎么落地、桶与策略怎么管,以及和之前那套备份/同步体系的衔接。
一、对象存储和"挂个盘"到底有什么不同
传统文件系统(ext4、NTFS)是"目录树 + 文件名"的层级结构,改文件就是原地改、删目录就递归删,极小一部分元数据(文件名、权限)存在节点里。对象存储把每一个数据单元叫"对象",对象 == 数据本体 + 描述它的元数据(键、大小、类型、标签)+ 一个全局唯一的 ID,存储端不按目录层级组织,而是按扁平命名空间。你看到的 bucket/key 这种结构,其实是逻辑上的斜杠命名,对存储端只是字符串前缀。
这个区别带来几个实际好处。第一是"写后即读"的一致性很简单,适合图片、备份、大文件这类不常原地修改的数据。第二是容量扩展线性——加节点就能加容量,不用重新分卷。第三是接口统一——S3 API 成了事实标准,一个客户端能同时对接多个服务商。对应地,它不适合的场景也有:需要频繁随机改写大文件、依赖文件系统 inode 做索引、要 POSIX 权限模型的场景,别硬把对象存储当普通磁盘用。
二、用 Docker Compose 把 MinIO 跑起来
MinIO 的部署非常轻,一个镜像加两个环境变量就能起服务。核心是 MINIO_ROOT_USER 和 MINIO_ROOT_PASSWORD(Ak/Sk 的"主账号"),数据要挂到持久卷,否则容器重建数据就没了——这条和之前聊 Docker 数据持久化的原则完全一致。
services:
  minio:
    image: minio/minio:latest
    command: server /data --console-address ":9001"
    environment:
      MINIO_ROOT_USER: minioadmin
      MINIO_ROOT_PASSWORD: 一个足够强的密码
    ports:
      - "9000:9000"   # S3 API 端口
      - "9001:9001"   # 管理控制台
    volumes:
      - minio_data:/data
    restart: unless-stopped
volumes:
  minio_data: {}
这里有几个直白的提醒。一是别用 latest,固定版本号让升级可预期、可回滚。二是 S3 端口 9000 是给应用调用的 API 口,控制台 9001 建议只绑定 localhost 或交给反代加认证,别裸暴露到公网——控制台本身就是管理入口,暴露它等于把管理权限摆在门口。三是数据卷要纳入 restic 那套备份:MinIO 本身就是备份的落点,却同样需要被元数据级别的异地快照保护,别让"备份存储"自己变成新的单点。
三、桶与策略:谁是"读写",谁是"只读"边界
MinIO 里的访问控制,主要通过"桶策略 + 访问密钥(Access Key)"组合实现。最常见的安全错误是"图省事给所有人开了匿名读写",等于把桶当公共网盘。规范做法是:桶默认私有,只对确实需要公开的资源(如博客图片、静态文件)单独桶配"只读匿名策略",其余一律只授给带密钥的客户端。
# 用官方客户端 mc 创建桶并设置策略
./mc admin user add local myapp myapp-secret
./mc mb local/backups
./mc anonymous set download local/blog-images   # 只对 blog-images 桶开公开读
# 其余桶保持私有,只有持密钥的 client 能访问
把"公开可读"和"私有"分开放在不同桶,是从根上避免"图方便一次放行"的关键。除此之外,给不同应用分配独立的 Access Key(而不是所有应用共用一个 admin 根密钥),当某个应用泄密或下线时,可以单独吊销而不影响其他服务,把密钥泄露的爆炸半径缩小到一个桶。
四、版本化与生命周期:误删、误改有后悔药
对象存储最大的便利之一,是能开版本管理(versioning)。开启后,每次覆盖同一 key 的对象,都会生成新版本而非覆盖旧的;删除也只是标记删除并保留历史版本。这个机制直接给"误删/误改"上了保险——用户手滑删了备份桶里的对象,管理员可以从历史版本找回来。配合生命周期策略(lifecycle),还能自动化数据治理:比如"当前版本保留 30 天,非当前版本保留 90 天后自动删除",让历史版本不至于无限膨胀。
# mc 生命周期规则示例:非当前版本 180 天后删除
./mc ilm add local/backups --expiry-days 180
需要留意的是,版本管理与生命周期并不是免费午餐:每个历史版本都占存储,无限开启会迅速吃掉磁盘。所以更稳妥的组合是"关键桶开版本管理 + 生命周期自动收敛",让它既有的放矢、又不会失控堆满。数据的"可回退"应该是有边界、可度量的,而不是开着版本往死里堆。
五、和 rclone / 现有备份体系怎么接
MinIO 的 S3 兼容性,让它在整个自托管栈里变成了一个"统一的数据落点"。最典型的接法是通过 rclone:它把 S3 桶视为一个后端,既能从各类源把数据同步上来,也能把 MinIO 里的对象再同步到别处做异地容灾。一次配置就能让"本机多个服务的备份"统一汇进 MinIO:
# rclone 配置一节指向本地 MinIO
[minio]
type = s3
provider = Minio
endpoint = http://127.0.0.1:9000
access_key_id = myapp
secret_access_key = myapp-secret

# 把某目录备份进桶
rclone copy /srv/navidrome/data minio:backups/navidrome --progress
# 再把桶里的东西异地一份
rclone sync minio:backups s3:remote-backup-bucket:backups --progress
这样 MinIO 既是聚合备份的中央仓库,又能通过 rclone 往异地再推一份,打通"本地备份 → 对象存储 → 异地容灾"的链路。它和 Immich、NextCloud 这类支持 S3 的应用也能直接对接,把应用数据落到统一存储。聪明的用法是不给某一块盘承担全部,而是让"对象存储"成为多个服务共享、又都能独立迁移的那层底座。
结语
MinIO 的价值在于把一个"所有自托管服务共享的数据落点"标准化成 S3 API,让备份、图片、文件、媒体都汇到一个统一的桶体系里,还自带版本管理与生命周期来守住数据和治理的边界。落地时的顺序很清楚:先用 Docker 把服务和数据卷跑稳,再把桶的私有/公开边界和访问密钥理顺,接着开版本管理并配好生命周期,最后用 rclone 把它接到既有备份和异地容灾链路里。对象存储不是把目录结构照搬一遍,而是要用"桶 + 对象 + 策略"的思维去重新组织数据,才能发挥它跨服务、可扩展、可审计的优势。