<!DOCTYPE html>
MySQL 主从复制实战:binlog、GTID 与故障切换排错全指南
单机数据库扛不住读写压力、担心数据丢失,怎么办?MySQL 主从复制是最经典、最成熟的解法:主库负责写入,从库实时同步数据并分担读请求,既能做读写分离,又能作为热备。本文从原理讲起,带你手把手完成 binlog 传统复制 与 GTID 复制 的完整配置,并给出最常见的复制中断排错方法,让主从同步稳定不踩坑。
一、主从复制的核心原理
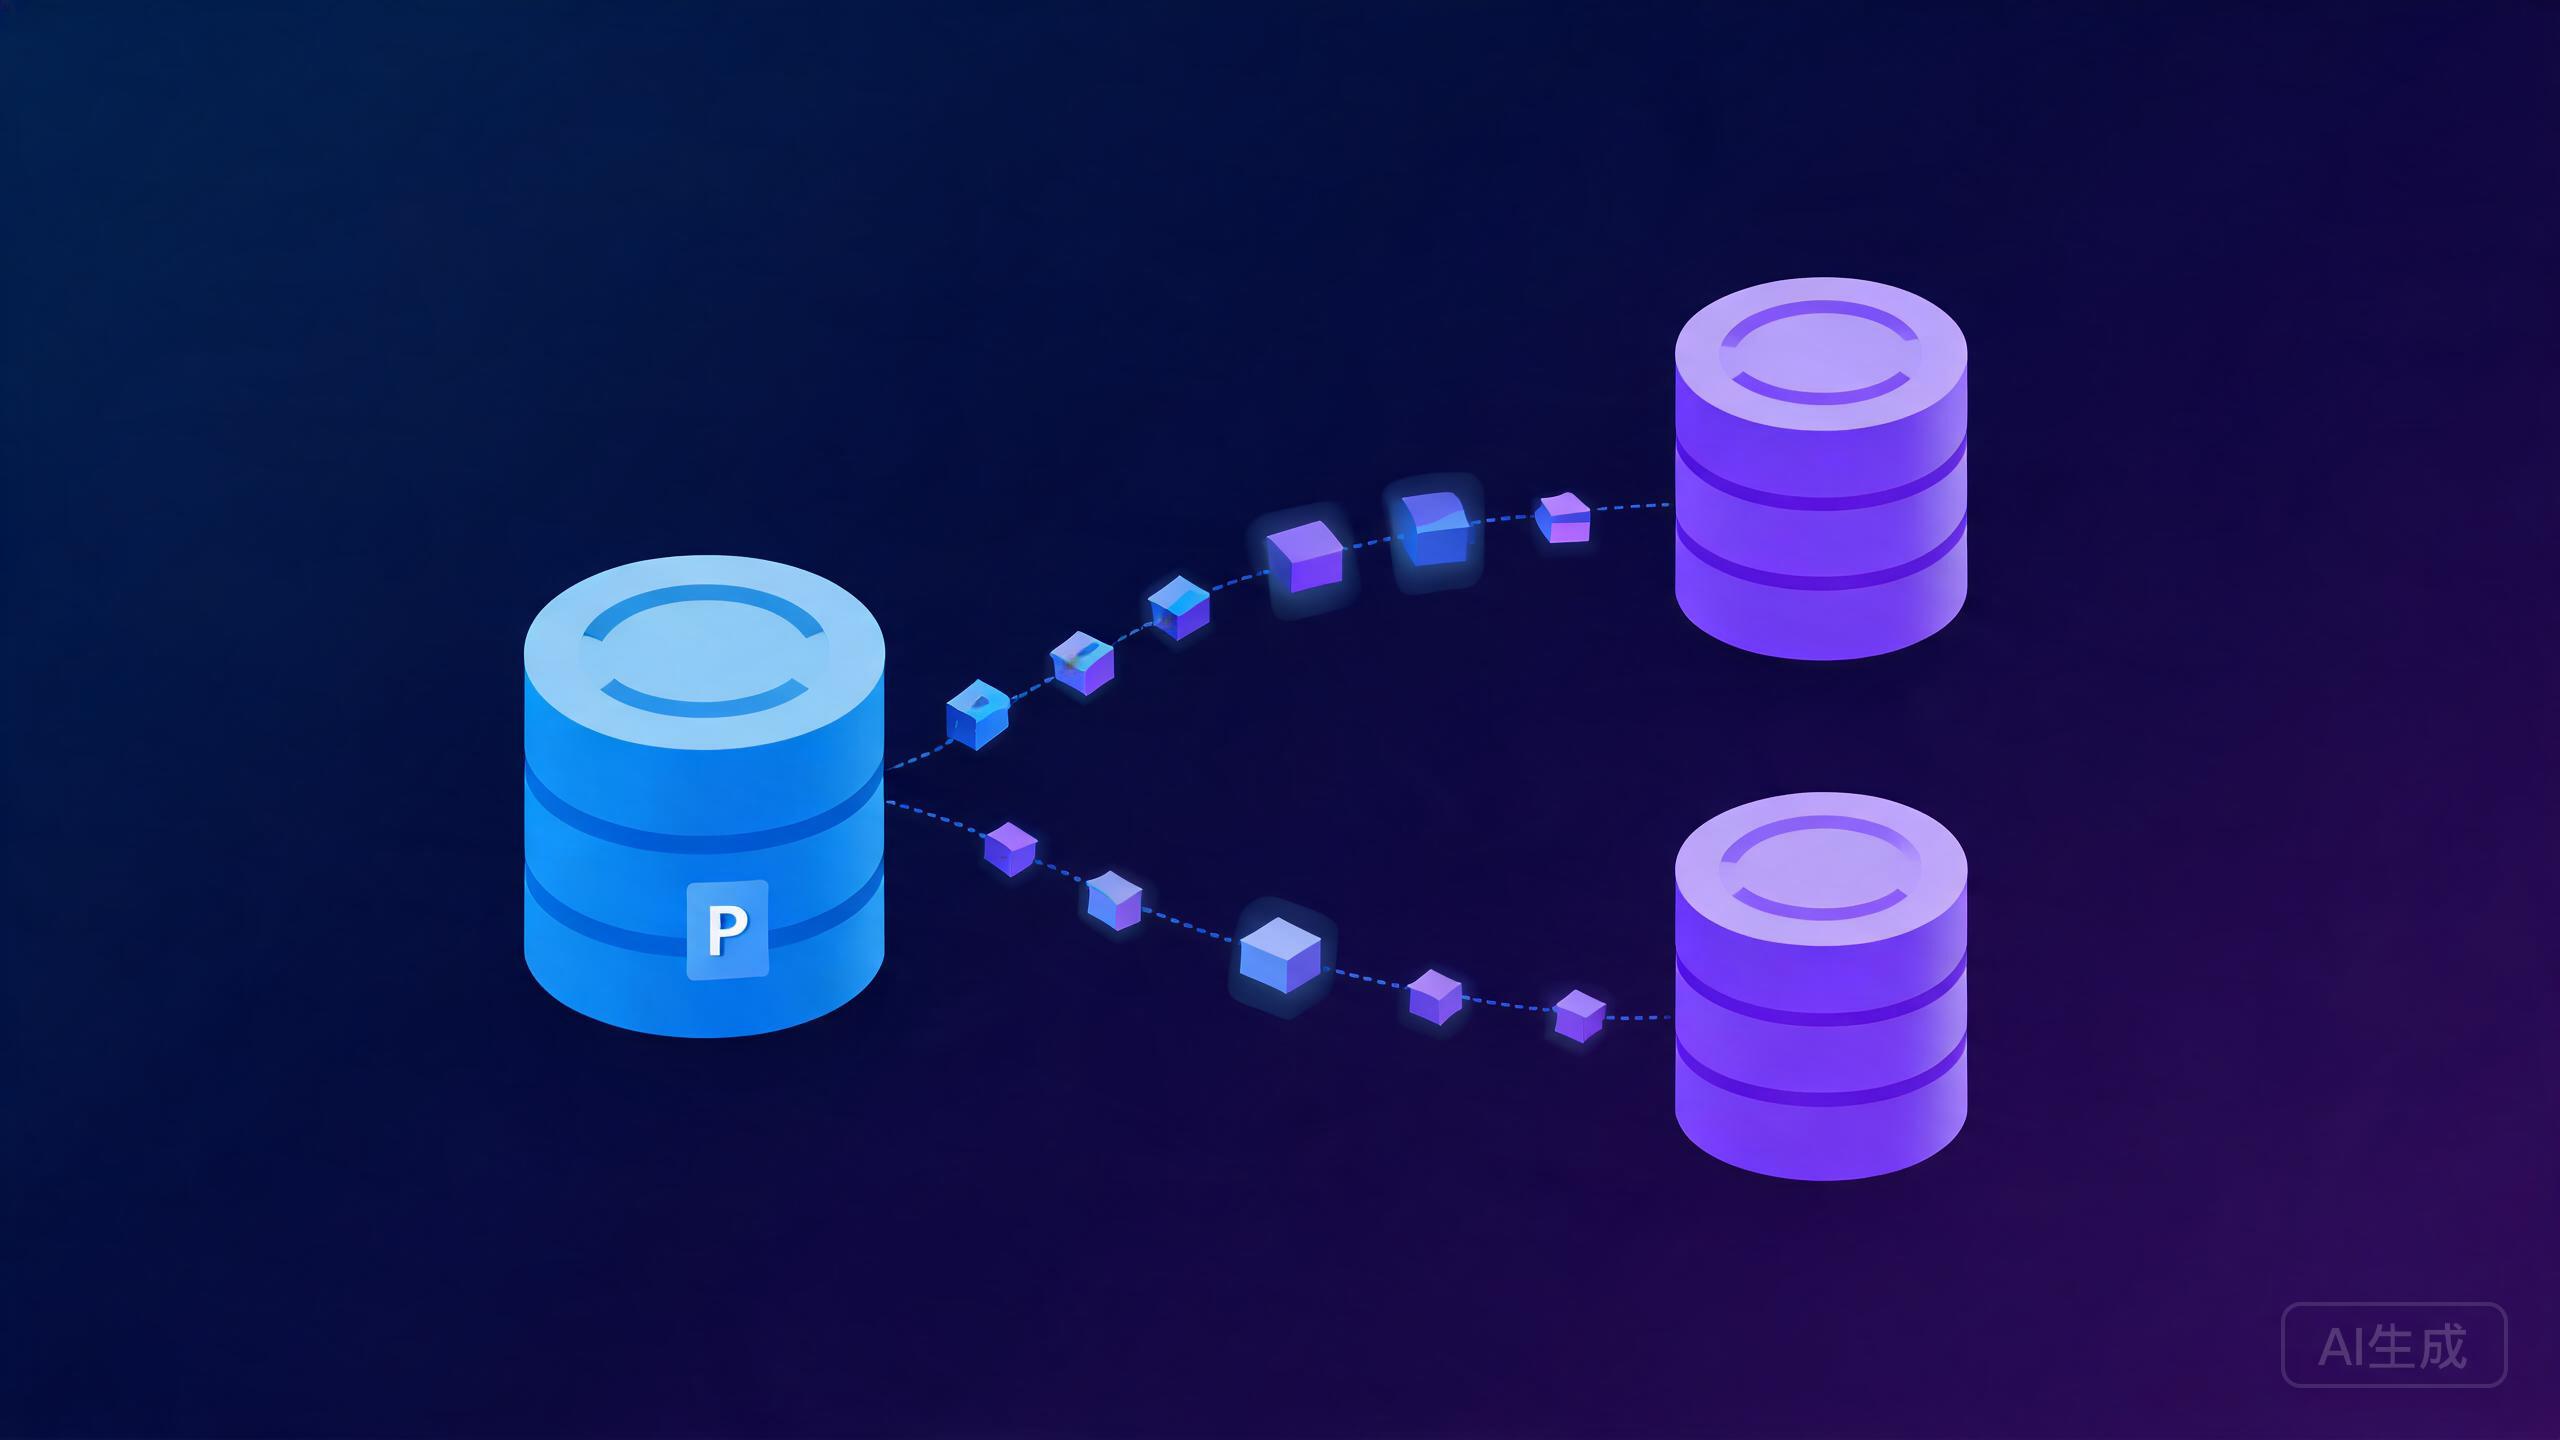
理解原理是排错的基础。MySQL 主从复制的数据流大致如下:
1. 主库上所有会改变数据的 SQL 都会被记录到二进制日志(binlog)
2. 从库启动一个 IO 线程,连接主库,把主库 binlog 拉到本地写入中继日志(relay log)
3. 从库的 SQL 线程按顺序重放 relay log,把变更应用到自己的数据上
4. 从库定期把已消费的 binlog 位点(file + position)汇报给主库
整个过程是异步的:主库提交事务不等待从库确认,所以从库可能存在短暂延迟。理解"IO 线程负责拉取、SQL 线程负责重放"这个模型,后面排错时看 SHOW SLAVE STATUS 的两个线程状态就有谱了。
二、环境准备与主库配置
本文使用两台 Ubuntu 22.04 服务器,MySQL 8.0:
主库 Master:192.168.1.10   (写入)
从库 Slave :192.168.1.20   (只读 + 读请求分流)
先确保主从都能互相访问 3306 端口,并检查 MySQL 版本(建议主从版本一致或从库不低于主库)。
1. 修改主库配置文件
编辑主库的 /etc/mysql/mysql.conf.d/mysqld.cnf(或 /etc/my.cnf):
[mysqld]
# 每台服务器(含从库)的 server-id 必须全局唯一,不能重复
server-id = 10
# 开启二进制日志,并指定日志文件名前缀
log-bin = mysql-bin
# binlog 格式:ROW 最安全,STATEMENT 可能出现主从不一致
binlog_format = ROW
# 行格式下记录前后镜像,便于恢复和排错,建议开启
binlog_row_image = FULL
# 日志保留 7 天,防止日志无限增长撑爆磁盘
expire_logs_days = 7
# 重启后需要同步的库;如果复制全部库可不写
# binlog-do-db = myapp
# 跳过系统库的写入,避免无意义日志
binlog-ignore-db = mysql
binlog-ignore-db = information_schema
binlog-ignore-db = performance_schema
binlog-ignore-db = sys
# 每写 N 次事务强制同步一次 binlog 到磁盘
sync_binlog = 1
修改后重启主库:
systemctl restart mysql
2. 创建复制专用账号
复制账号只需要 REPLICATION SLAVE 权限,不要给它超级权限:
mysql -uroot -p

CREATE USER 'repl'@'192.168.1.%' IDENTIFIED BY 'Str0ng_Pass@2026';
GRANT REPLICATION SLAVE ON *.* TO 'repl'@'192.168.1.%';
FLUSH PRIVILEGES;
3. 记录当前 binlog 位点
如果是从零开始复制,需要锁定主库、记录位点:
-- 会话1:锁定所有表,禁止写入
FLUSH TABLES WITH READ LOCK;
-- 会话2:查看位点
SHOW MASTER STATUS;
-- 结果示例:
-- +------------------+----------+--------------+------------------+
-- | File             | Position | Binlog_Do_DB | Binlog_Ignore_DB |
-- +------------------+----------+--------------+------------------+
-- | mysql-bin.000003 |     1540 |              |                  |
-- +------------------+----------+--------------+------------------+
记下 mysql-bin.000003 和 1540,随后在从库执行导入备份后,用这两个值启动复制。最后在会话1执行 UNLOCK TABLES; 解锁。
三、从库配置与启动复制(传统位点方式)
1. 从库配置文件
编辑从库的配置文件:
[mysqld]
server-id = 20
# 开启中继日志(默认开启,可显式指定)
relay-log = mysql-relay-bin
# 从库只读:普通账号不能写,超级账号可写,防止误操作污染从库
read_only = 1
# 可选:启用 GTID 需要在此处设置(见第四节)
# gtid_mode = ON
# enforce_gtid_consistency = ON
重启从库:
systemctl restart mysql
2. 把主库数据导入从库
生产环境主库已有数据,需要先做一次全量备份再导入,否则从库重放日志时找不到数据会直接报错:
# 主库上执行(在 FLUSH TABLES WITH READ LOCK 生效期间)
mysqldump -uroot -p --single-transaction --master-data=2 --routines --events --triggers --all-databases > /tmp/master_dump.sql

# 将备份文件传到从库
scp /tmp/master_dump.sql root@192.168.1.20:/tmp/

# 从库上导入
mysql -uroot -p < /tmp/master_dump.sql
提示:--master-data=2 会在 dump 文件头部注释里自动写入当时的 binlog 位点(CHANGE MASTER TO MASTER_LOG_FILE=..., MASTER_LOG_POS=...),这样即使你忘了 SHOW MASTER STATUS 的结果,也能从备份文件里找到,非常实用。
3. 配置复制源并启动
mysql -uroot -p

CHANGE MASTER TO
  MASTER_HOST='192.168.1.10',
  MASTER_USER='repl',
  MASTER_PASSWORD='Str0ng_Pass@2026',
  MASTER_LOG_FILE='mysql-bin.000003',
  MASTER_LOG_POS=1540;

START SLAVE;
SHOW SLAVE STATUS\G
关键看两个字段是否都是 Yes:
Slave_IO_Running: Yes
Slave_SQL_Running: Yes
再验证同步是否生效:在从库执行 SHOW SLAVE STATUS\G,看 Seconds_Behind_Master: 0 表示已追平主库。随后在主库建一张测试表插入数据,到从库查询确认能查到,复制链路就通了。
四、GTID 模式:更简单的位点管理
传统位点方式要手动记录 File + Position,一旦位点对不上就抓瞎。MySQL 5.7+ 推荐使用 GTID(全局事务标识),主从通过事务 ID 自动对齐,切换、追平都更简单。
1. 主从都开启 GTID
在主库和从库的配置文件中都加入:
[mysqld]
gtid_mode = ON
enforce_gtid_consistency = ON
重启主从库。注意:GTID 只能在全库无 GTID 事务时开启,建议在搭建初期就配置好。
2. 用 GTID 方式建立复制
mysql -uroot -p

CHANGE MASTER TO
  MASTER_HOST='192.168.1.10',
  MASTER_USER='repl',
  MASTER_PASSWORD='Str0ng_Pass@2026',
  MASTER_AUTO_POSITION=1;

START SLAVE;
SHOW SLAVE STATUS\G
区别只在最后一行:MASTER_AUTO_POSITION=1 替代了手动指定 MASTER_LOG_FILE / MASTER_LOG_POS,从库会自动向主库要自己缺失的事务。这样即使从库落后很多,也不会因为位点对不上而中断。
3. 查看 GTID 执行情况
-- 主库已执行的事务集合
SHOW MASTER STATUS;
-- 输出中 Executed_Gtid_Set: xxx-xxx-xxx:1-N

-- 从库检索到/已执行的 GTID
SHOW SLAVE STATUS\G
-- Retrieved_Gtid_Set 与 Executed_Gtid_Set 追平即同步完成
五、复制中断:常见故障与排错方法
复制 99% 的问题都体现在 SHOW SLAVE STATUS\G 的 Last_IO_Error 和 Last_SQL_Error 上。先看这两个字段,再对号入座。
1. Slave_IO_Running: Connecting / No
IO 线程连不上主库,先排查网络和账号:
# 从库上测试到主库 3306 端口是否通
telnet 192.168.1.10 3306
# 或
nc -zv 192.168.1.10 3306

# 确认主库允许远程连接(检查 bind-address、skip-networking)
mysql -urepl -p -h 192.168.1.10 -e "SELECT 1;"

# 主库上确认复制账号权限
SELECT user, host FROM mysql.user WHERE user='repl';
SHOW GRANTS FOR 'repl'@'192.168.1.%';
常见原因:bind-address=127.0.0.1 导致拒绝远程、云安全组未放行 3306、账号 host 不匹配、密码错误(密码错误会看到 Access denied for user 'repl')。
2. SQL 线程报错:Last_SQL_Error 常见 3 类
错误 1062(主键冲突): 主从数据不一致,从库已有相同主键。先确认这是不是正常业务冲突:
-- 查看具体冲突位置
SHOW SLAVE STATUS\G   -- 找到 Last_SQL_Error 与 Last_Errno
如果是误操作导致的,可用以下方法跳过单条事务(注意 8.0 推荐先设 sql_slave_skip_counter 或直接 GTID 注入空事务,7.x 用 skip 计数):
STOP SLAVE;
SET GLOBAL sql_slave_skip_counter = 1;
START SLAVE;
GTID 模式下可用空事务方式跳过:
STOP SLAVE;
SET GTID_NEXT='主库gtid集合中缺失的那个GTID';
BEGIN; COMMIT;          -- 注入空事务占位
SET GTID_NEXT='AUTOMATIC';
START SLAVE;
注意:跳过只是治标,必须回头把从库数据和主库对齐,否则还会继续报错。
错误 1236(binlog 已被清理): 从库落后太久,需要的 binlog 已被主库 expire_logs_days 清理。解决办法是重新做一次全量同步:
# 主库
mysqldump --single-transaction --master-data=2 --all-databases > /tmp/full.sql
scp /tmp/full.sql root@192.168.1.20:/tmp/
# 从库
STOP SLAVE;
mysql -uroot -p < /tmp/full.sql
RESET SLAVE ALL;          -- 清空旧配置
# 从 dump 文件头部注释读取新位点,重新 CHANGE MASTER TO 后 START SLAVE
长期预防:把 expire_logs_days 调大(如 14),或者用监控盯着 Seconds_Behind_Master。
错误 1032(找不到要更新的行): 同样是从库数据不一致,常见于有人直接在从库上改了数据(虽然设了 read_only,但超级账号或误开写入仍可能发生)。处理方式与 1062 类似,先排查谁写了从库。
3. Seconds_Behind_Master 持续增长(复制延迟)
延迟不等于故障,但长期延迟会让从库失去热备意义。常见原因与对策:
1. 从库磁盘 IO 慢 -> 从库磁盘换成 SSD,加大 innodb_buffer_pool_size
2. 主库大事务(一次性删百万行)-> 拆分事务,分批提交
3. 从库只有单 SQL 线程重放 -> 多线程复制(并行复制)
4. 从库机器配置远低于主库 -> 保证从库配置不低于主库

# 查看 SQL 线程是否是多线程(8.0 默认开启协调器)
SHOW VARIABLES LIKE 'slave_parallel_workers';
SET GLOBAL slave_parallel_workers = 4;   # 需写入配置文件并重启生效
4. 主从数据一致性校验
用官方工具 pt-table-checksum(Percona Toolkit)定期校验,比手动对比靠谱得多:
# 安装 Percona Toolkit(Ubuntu)
wget https://downloads.percona.com/downloads/percona-toolkit/LATEST/binary/debian/$(lsb_release -sc)/x86_64/percona-toolkit_latest_amd64.deb
dpkg -i percona-toolkit_latest_amd64.deb

# 校验 mydb 库
pt-table-checksum h=192.168.1.10,u=root,p=密码 --databases=mydb
发现不一致的 chunk 会打印出来,再用 pt-table-sync 修复,这里不展开。
六、主从切换:从库提升为主库
主库宕机时,需要把从库提升为主库,业务照常跑:
# 从库上执行
STOP SLAVE;
RESET SLAVE ALL;                    -- 断开与旧主的复制关系

# 开启写权限
SET GLOBAL read_only = OFF;

# 如果其他从库要从这个"新主"复制,这里会得到它的新位点
SHOW MASTER STATUS;
切换前务必确认从库已追平主库(Seconds_Behind_Master=0),否则会丢数据。生产环境建议用 MHA 或 Orchestrator 这类工具做自动切换,人工切换容易误操作。
七、安全与运维建议
1. 复制账号用强密码,只授 REPLICATION SLAVE 权限,别用 root
2. 从库开启 read_only + 关闭超级写权限(super_read_only=1)双保险
3. 给 binlog 做保留期管理,别让日志撑爆磁盘
4. 对 Seconds_Behind_Master、Slave_IO/SQL_Running 做监控告警(可结合 Prometheus)
5. 定时用 pt-table-checksum 校验一致性,别等到切换时才发现数据不对
6. 主从服务器时钟用 NTP/chrony 对齐,避免时间偏差导致日志错乱
结语
主从复制的配置本身不难,难在"排错思路":永远先看 SHOW SLAVE STATUS 的两个线程状态和两个 Error 字段,再根据错误码定位。把 IO 线程(网络/账号)、SQL 线程(数据一致性/日志缺失)分开排查,问题基本都能很快收敛。建议先在测试环境完整演练一遍"搭建 - 中断 - 修复 - 切换"全流程,生产环境才不会慌。