<!DOCTYPE html>
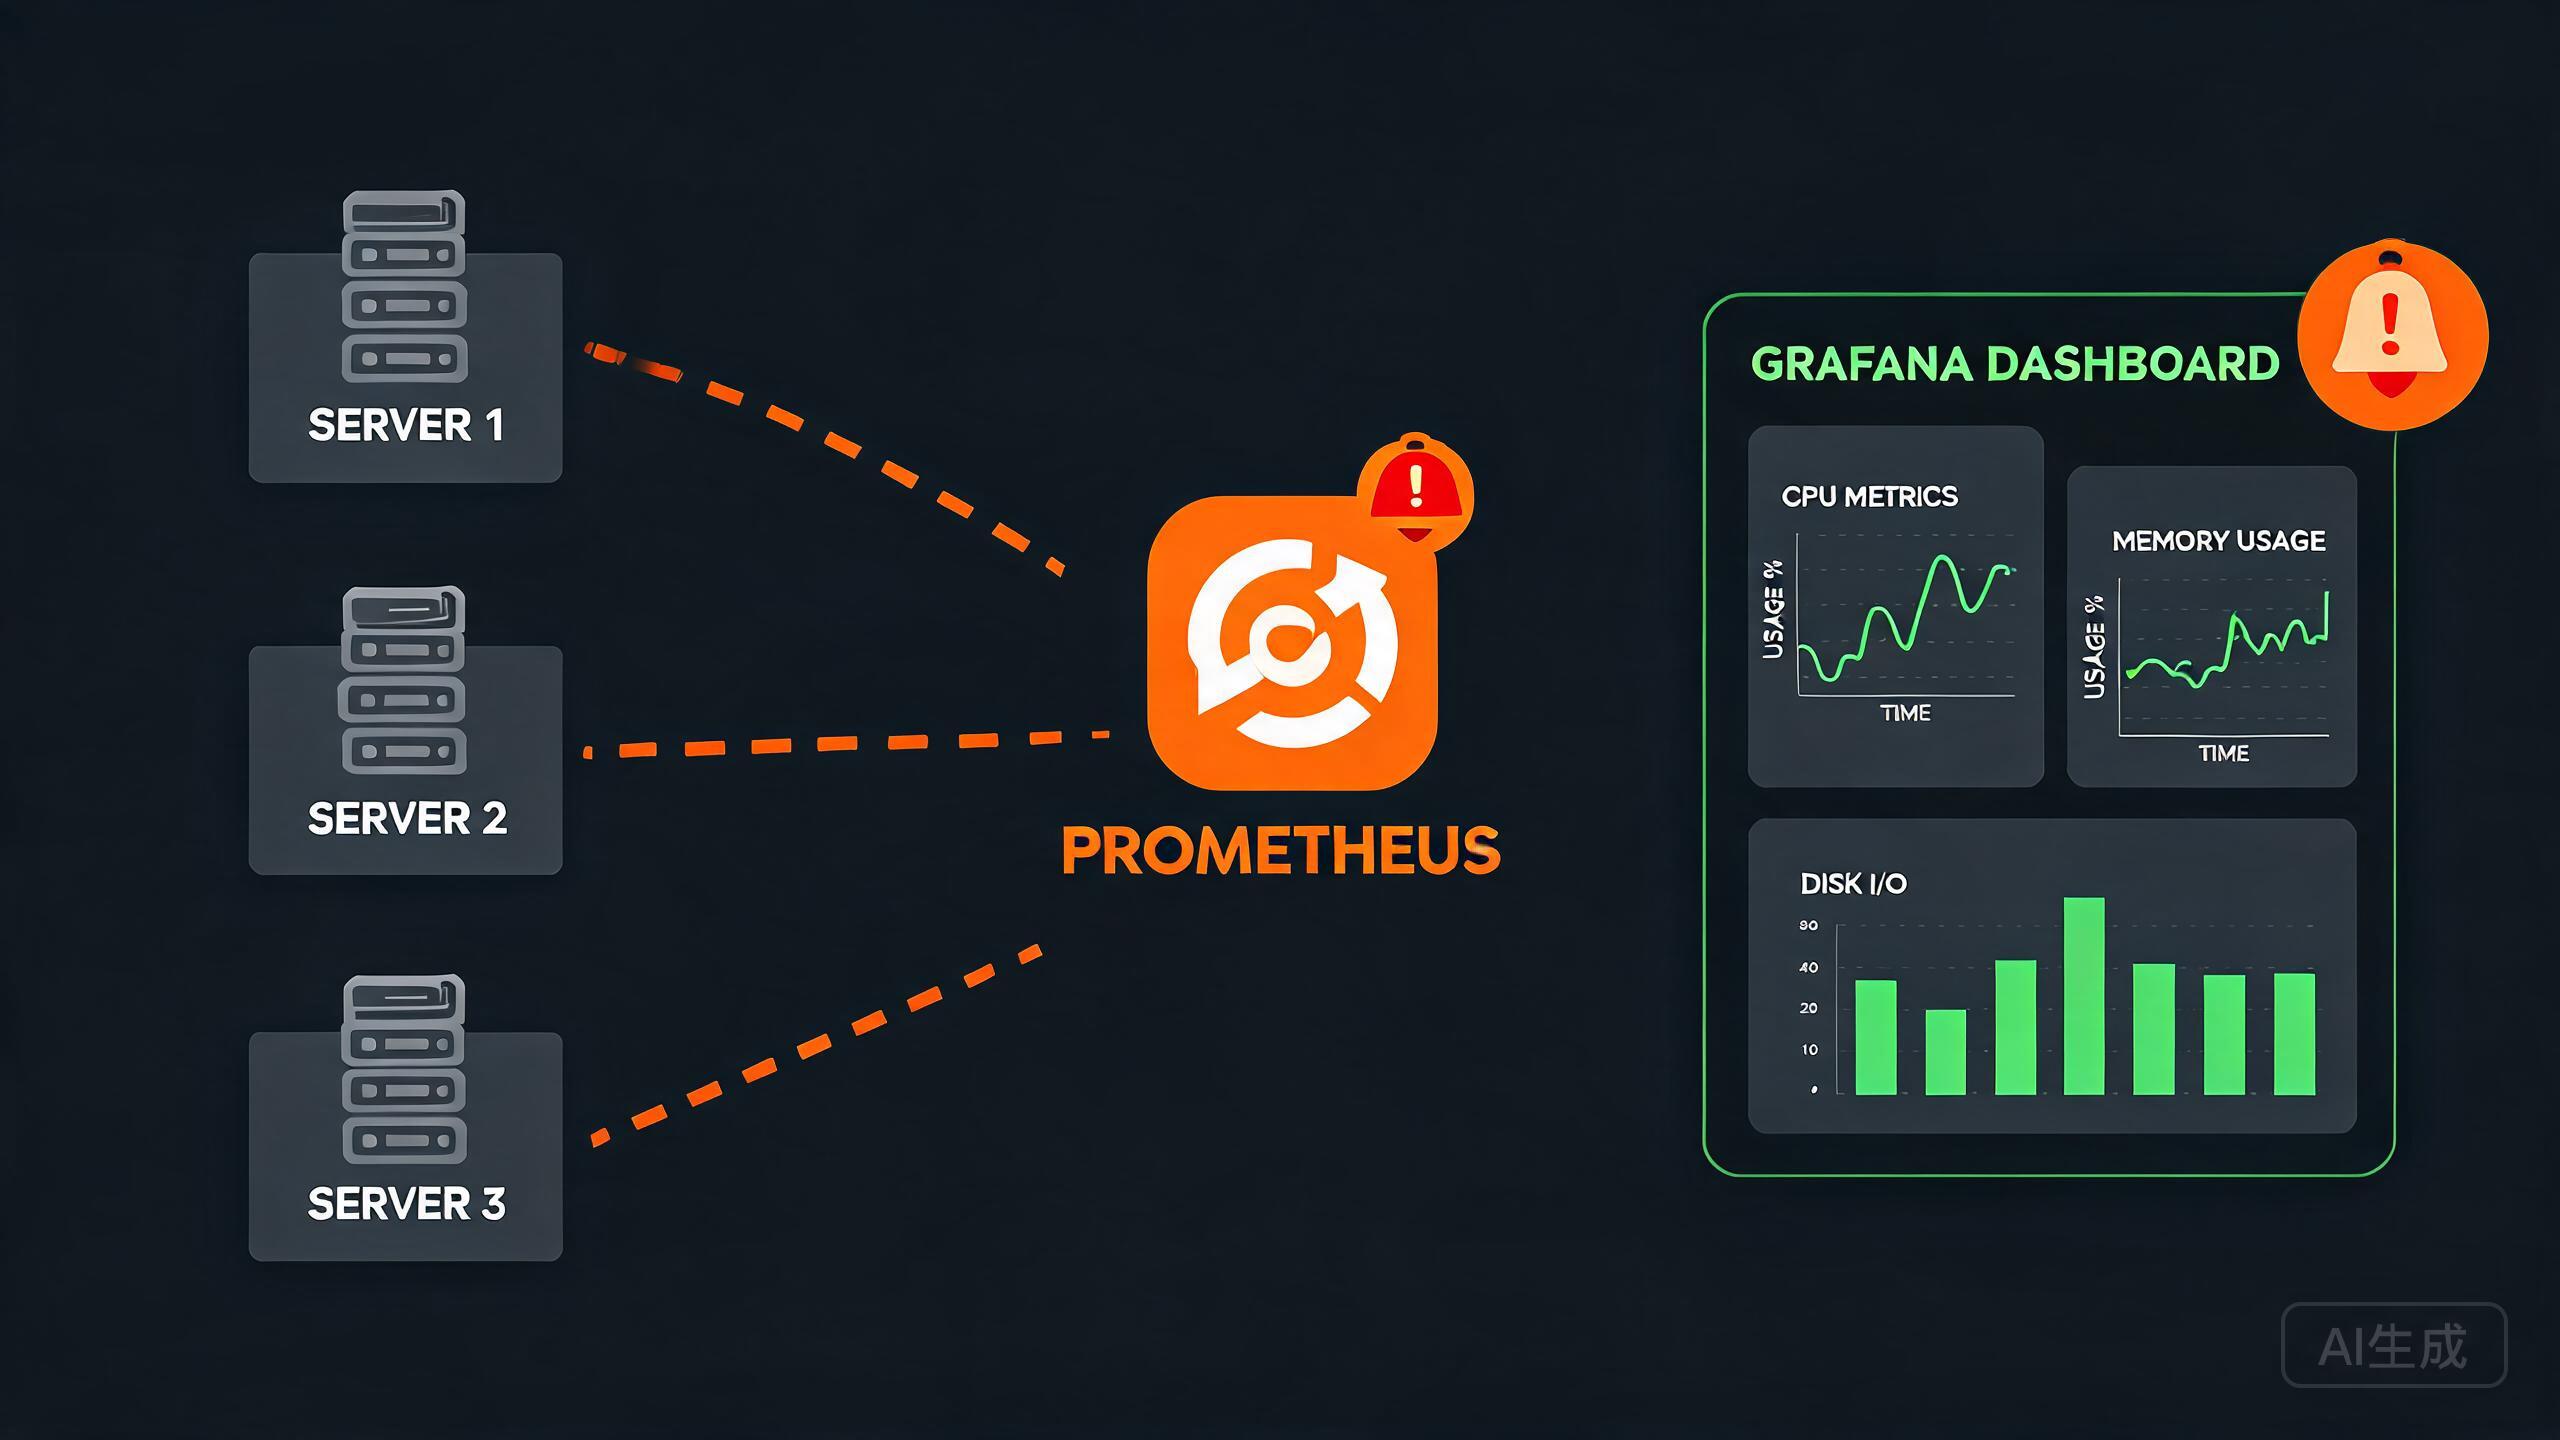
服务器是不是又要被「某一天突然 CPU 100%」「磁盘半夜被日志塞满」这类问题偷袭?与其事后救火,不如搭建一套开源监控体系:Prometheus 负责采集和告警,Node Exporter 负责上报系统指标,Grafana 负责可视化。三者全是免费开源,单机 5 分钟就能跑起来。本文从零开始,带你完成安装、配置、告警和排错全流程。
一、整体架构与端口规划
先看清三个组件的关系:
服务器本身 (Node Exporter 收集 CPU/内存/磁盘/网络指标)
        │ 上报 metrics (HTTP, 端口 9100)
        ▼
Prometheus 主服务 (抓取并存储时序数据, 端口 9090)
        │ 提供查询接口 / PromQL
        ▼
Grafana (可视化面板, 端口 3000)
        │ 触发规则
        ▼
Alertmanager (告警收敛, 端口 9093) → 钉钉/邮件/企业微信通知
端口规划:Prometheus 9090、Node Exporter 9100、Grafana 3000、Alertmanager 9093。云服务器记得在安全组放行,或者干脆不对外暴露(推荐内网访问)。
二、部署 Prometheus 主服务
使用官方二进制 + systemd 托管,最干净可控:
# 1. 创建运行用户与目录
useradd --no-create-home --shell /bin/false prometheus
mkdir -p /opt/prometheus/data
chown -R prometheus:prometheus /opt/prometheus

# 2. 下载(版本号按需替换,可去 github releases 查询最新)
cd /tmp
wget https://github.com/prometheus/prometheus/releases/download/v2.53.0/prometheus-2.53.0.linux-amd64.tar.gz
tar xzf prometheus-2.53.0.linux-amd64.tar.gz
cp prometheus-2.53.0.linux-amd64/{prometheus,promtool} /usr/local/bin/
mkdir -p /etc/prometheus
cp prometheus-2.53.0.linux-amd64/prometheus.yml /etc/prometheus/

# 3. 验证版本
prometheus --version
编辑主配置 /etc/prometheus/prometheus.yml:
global:
  scrape_interval: 15s      # 抓取频率
  evaluation_interval: 15s  # 规则评估频率

alerting:
  alertmanagers:
    - static_configs:
        - targets: ['localhost:9093']

rule_files:
  - "rules/*.yml"           # 告警规则文件

scrape_configs:
  - job_name: 'node'
    static_configs:
      - targets: ['localhost:9100']
        labels:
          env: 'prod'
          host: 'web-01'
创建 systemd 服务 /etc/systemd/system/prometheus.service:
[Unit]
Description=Prometheus
After=network.target

[Service]
User=prometheus
Group=prometheus
Type=simple
ExecStart=/usr/local/bin/prometheus \
  --config.file=/etc/prometheus/prometheus.yml \
  --storage.tsdb.path=/opt/prometheus/data \
  --storage.tsdb.retention.time=30d
Restart=always

[Install]
WantedBy=multi-user.target
systemctl daemon-reload
systemctl enable --now prometheus
systemctl status prometheus三、部署 Node Exporter 采集系统指标
# 1. 下载安装
cd /tmp
wget https://github.com/prometheus/node_exporter/releases/download/v1.8.2/node_exporter-1.8.2.linux-amd64.tar.gz
tar xzf node_exporter-1.8.2.linux-amd64.tar.gz
cp node_exporter-1.8.2.linux-amd64/node_exporter /usr/local/bin/
useradd --no-create-home --shell /bin/false node_exporter
创建 /etc/systemd/system/node_exporter.service:
[Unit]
Description=Node Exporter
After=network.target

[Service]
User=node_exporter
Type=simple
ExecStart=/usr/local/bin/node_exporter \
  --web.listen-address=:9100 \
  --collector.systemd \
  --collector.filesystem.mount-points-exclude=^/(sys|proc|dev|run)($|/)
Restart=always

[Install]
WantedBy=multi-user.target
systemctl daemon-reload
systemctl enable --now node_exporter
# 2. 自测指标接口
curl -s localhost:9100/metrics | head -5
curl -s localhost:9100/metrics | grep node_cpu_seconds_total | head -3看到指标输出即成功。此时回到 Prometheus 页面 http://服务器IP:9090/targets,应看到 node 这个 job 状态为 UP(绿色)。
四、安装 Grafana 并接入数据源
# Debian/Ubuntu 安装
apt-get install -y software-properties-common
wget -q -O - https://packages.grafana.com/gpg.key | gpg --dearmor -o /usr/share/keyrings/grafana.gpg
echo "deb [signed-by=/usr/share/keyrings/grafana.gpg] https://packages.grafana.com/oss/deb stable main" > /etc/apt/sources.list.d/grafana.list
apt-get update && apt-get install -y grafana

systemctl enable --now grafana-server
ss -tlnp | grep 3000   # 确认监听
访问 http://服务器IP:3000,默认账号密码 admin/admin(首次登录强制修改)。
接入数据源:Configuration → Data sources → Add data source → Prometheus,URL 填 http://localhost:9090,点击 Save & Test 看到绿色成功提示即可。
导入现成面板(强烈推荐):Dashboards → Import,输入官方 Node Exporter Full 面板 ID 1860,选择刚才的 Prometheus 数据源加载。一张包含 CPU、内存、磁盘、网络的完整大盘就出来了。
五、告警规则与 Alertmanager 推送钉钉
5.1 编写告警规则
创建目录与规则文件:
mkdir -p /etc/prometheus/rules/etc/prometheus/rules/node.yml:
groups:
  - name: node-alerts
    rules:
      - alert: InstanceDown
        expr: up == 0
        for: 2m
        labels:
          severity: critical
        annotations:
          summary: "实例 {{ $labels.instance }} 已宕机"

      - alert: HighCpuUsage
        expr: 100 - (avg by(instance) (rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100) > 90
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "{{ $labels.instance }} CPU 使用率超过 90%"

      - alert: DiskSpaceLow
        expr: (node_filesystem_avail_bytes{mountpoint="/",fstype!~"tmpfs|overlay"} / node_filesystem_size_bytes{mountpoint="/",fstype!~"tmpfs|overlay"}) * 100 < 10
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "{{ $labels.instance }} 根分区剩余空间不足 10%"
检查语法并重载:
promtool check rules /etc/prometheus/rules/node.yml
systemctl restart prometheus
5.2 部署 Alertmanager 并接入钉钉 Webhook
cd /tmp
wget https://github.com/prometheus/alertmanager/releases/download/v0.27.0/alertmanager-0.27.0.linux-amd64.tar.gz
tar xzf alertmanager-0.27.0.linux-amd64.tar.gz
cp alertmanager-0.27.0.linux-amd64/{alertmanager,amtool} /usr/local/bin/
mkdir -p /etc/alertmanager
最简单的验证方式:先配置一个「webhook 演示」接收器,把告警打到钉钉机器人。钉钉群添加「自定义机器人」后,用脚本转发 Alertmanager 的 webhook JSON:
# /etc/alertmanager/alertmanager.yml
route:
  group_by: ['alertname']
  group_wait: 10s
  group_interval: 30s
  repeat_interval: 1h
  receiver: 'dingtalk'

receivers:
  - name: 'dingtalk'
    webhook_configs:
      - url: 'http://127.0.0.1:5000/dingtalk'
        send_resolved: true
再写一个简单的 Python webhook 转发服务(/opt/alert-bridge/alert_bridge.py),把消息转成钉钉的 markdown 格式:
from flask import Flask, request
import requests, os

app = Flask(__name__)
DING_URL = os.environ.get("DING_URL")  # 钉钉机器人 webhook

@app.route("/dingtalk", methods=["POST"])
def dingtalk():
    data = request.json
    for alert in data.get("alerts", []):
        status = "❌ 告警" if alert["status"] == "firing" else "✅ 恢复"
        title = alert["labels"]["alertname"]
        text = f"### {status}: {title}\n\n" \
               f"> 实例: {alert['labels'].get('instance','')}\n\n" \
               f"> 详情: {alert['annotations'].get('summary','')}"
        requests.post(DING_URL, json={"msgtype": "markdown",
                                      "markdown": {"title": status, "text": text}})
    return "ok"

if __name__ == "__main__":
    app.run(host="127.0.0.1", port=5000)
# 安装依赖并以 systemd 方式常驻
pip3 install flask requests
DING_URL="https://oapi.dingtalk.com/robot/send?access_token=你的token" \
nohup python3 /opt/alert-bridge/alert_bridge.py &生产环境建议直接用官方钉钉/企业微信集成(webhook_configs 自带),或使用 prometheus-webhook-dingtalk 项目,避免自研转发层。
六、常用 PromQL 查询速查表
# CPU 使用率(5 分钟平均)
100 - (avg by(instance) (rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100)

# 内存使用率
100 * (1 - (node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes))

# 根分区使用率
100 * (1 - (node_filesystem_avail_bytes{mountpoint="/"} / node_filesystem_size_bytes{mountpoint="/"}))

# 磁盘读吞吐(MB/s)
rate(node_disk_read_bytes_total[5m]) / 1024 / 1024

# 网络入站流量(Mbps)
rate(node_network_receive_bytes_total{device="eth0"}[5m]) * 8 / 1024 / 1024

# 系统 1 分钟负载与 CPU 核数对比
node_load1 / node_cpu_seconds_total{mode="idle"} + 1 # 示意
# 更常用:直接看 load1 是否长期大于核数
node_load1
七、常见排错
错误 1:Prometheus 页面 Targets 显示 DOWN(Connection refused)
# 排查 Node Exporter 是否监听
ss -tlnp | grep 9100
systemctl status node_exporter
# 确认防火墙放行(本机抓取一般不用开防火墙,跨机抓取需放行)
ufw allow 9100/tcp
firewall-cmd --permanent --add-port=9100/tcp && firewall-cmd --reload
错误 2:Grafana 数据源报 "Bad Gateway"
# 常见原因:Grafana 无法访问 Prometheus(端口没监听 / 防火墙 / 路径错误)
curl -s http://localhost:9090/-/healthy   # 应返回 Prometheus is Healthy
# 若 Grafana 在其他机器,URL 要写服务器的实际 IP,而不是 localhost
错误 3:监控图出现断线(gap)
# 原因 1:抓取超时——指标量大时 15s 不够
# 解决:调大 scrape_timeout 或拆分 job
# 原因 2:Prometheus 服务器时间漂移(TSDB 时间戳错乱)
timedatectl status
ntpdate -u ntp.aliyun.com   # 或启用 chronyd
# 原因 3:磁盘写满导致 TSDB 写失败
df -h /opt/prometheus
错误 4:告警一直 Pending 不触发
# Pending 表示满足条件但未持续 for 指定的时长
# 检查规则里的 for 值、evaluation_interval、以及查询是否恒真
# 在 Prometheus 页面 Graph 页手工执行该 expr 验证
# 注意:up == 0 这类告警,若 exporter 挂了,抓不到该指标时 up 会消失而不是 0
# 可改用 absent(node_cpu_seconds_total) 辅助判断
错误 5:磁盘指标不显示挂载点
# 确认 node_exporter 的挂载点排除规则是否误伤了目标路径
# 查看实际采集到的指标
curl -s localhost:9100/metrics | grep node_filesystem_size_bytes
# 若无输出,检查 --collector.filesystem.mount-points-exclude 参数
八、总结与进阶方向
一套基础的监控体系到此搭建完成:Node Exporter 采数据 → Prometheus 存与算 → Grafana 展示 → Alertmanager 告警。在此基础上可以继续进阶:接入 cAdvisor + kube-state-metrics 监控 Docker/K8s、用 blackbox_exporter 做网站可用性探测、用 mysqld_exporter 监控数据库、配合 VictoriaMetrics 做长期存储、用 Grafana Loki 采集日志。监控是运维的「眼睛」,越早搭越好——下次服务器半夜出问题,是告警叫你起床,而不是用户投诉叫醒你。
如果搭建过程中遇到任何报错,欢迎在评论区带上 systemctl status 和 curl 自测结果留言,一起排查。