自托管里的监控数据分两类性格:一类是"逐点跳变、随时间增长"的时序指标(CPU、请求速率、温度、股票价),另一类是"一张张表、要按名字查"的关系数据。把时序数据塞进普通数据库,既难扩展又查询别扭。时序数据库(Time Series Database, TSDB)就是为"随时间变化的高频指标"而生的存储与查询引擎;而 InfluxDB 是自托管里用得最广的 TSDB。这篇讲清 TSDB/InfluxDB 解决什么、怎么用 Telegraf 采集、怎么查询与清洗(保留策略/降采样),以及常见坑与边界。
一、TSDB / InfluxDB 解决什么:为"随时间增长的天量一点"设计的存储
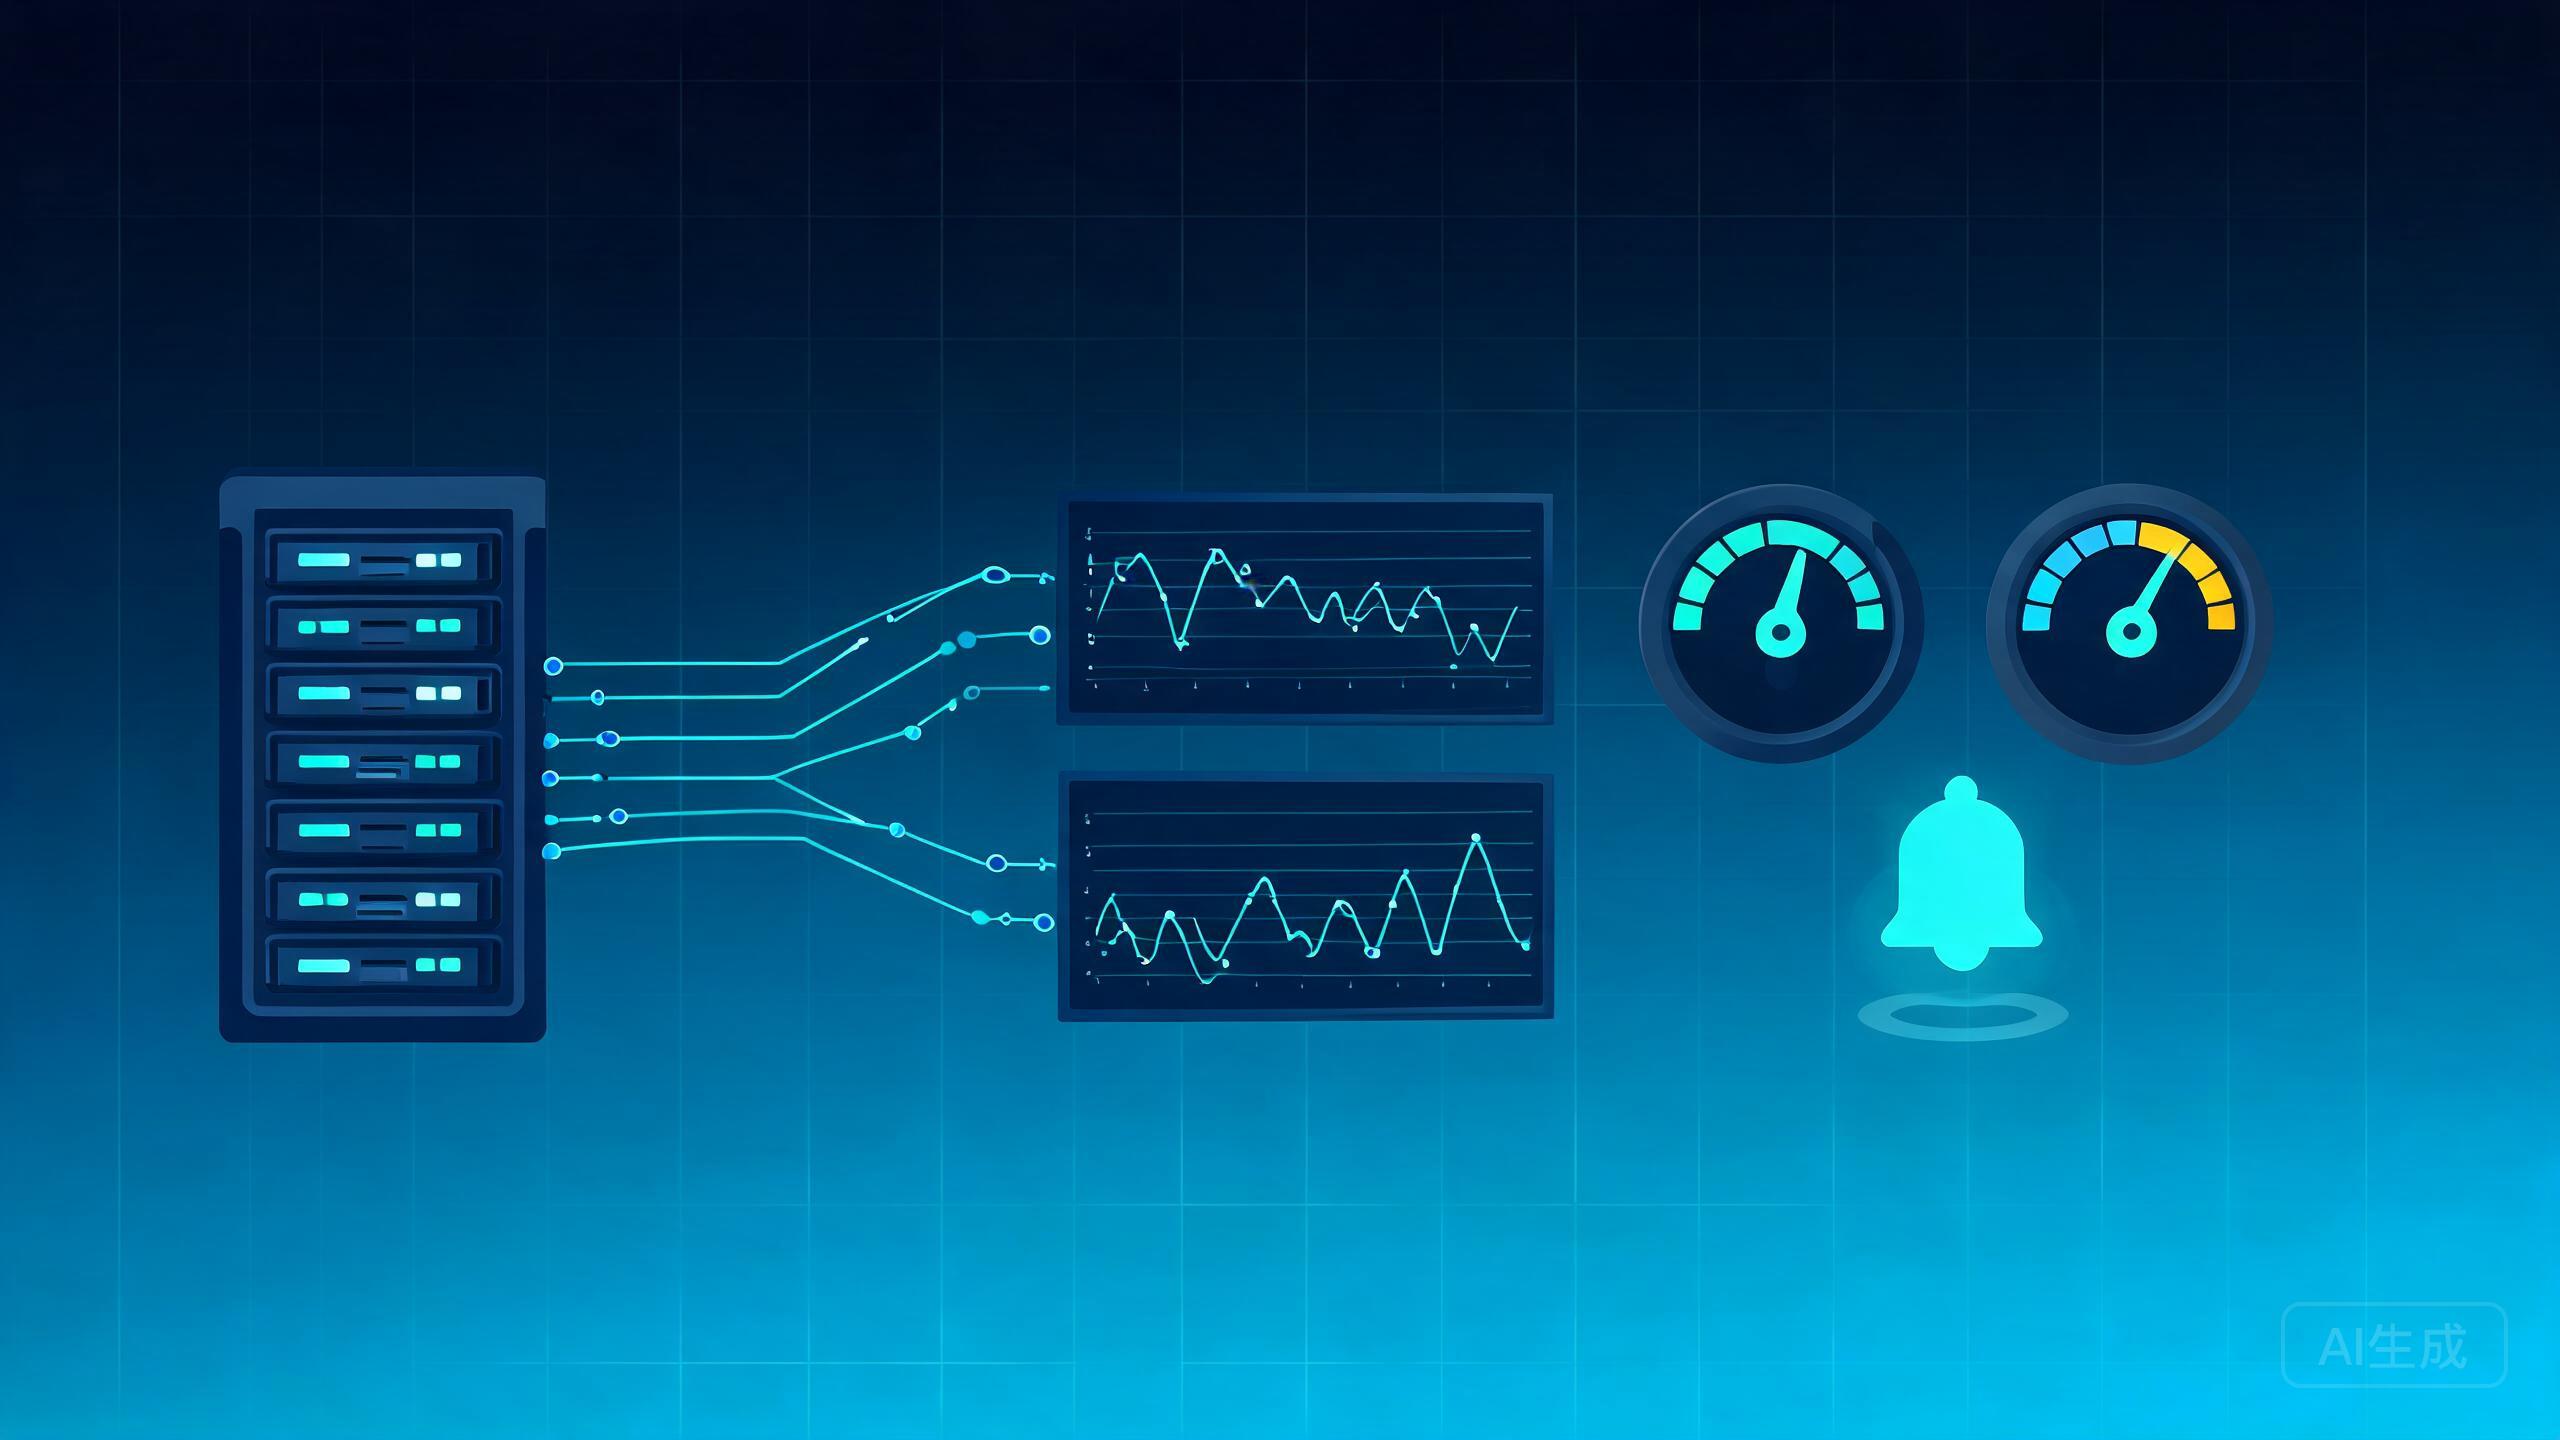
时序数据的特点是"量大、连续、带时间戳":一分钟采一个点,一台机器一天就是上千点,多台机器、多指标叠加后数据点数量巨大。普通关系库不是不能存,而是"扩展和查询都别扭"——你要老是"按时间范围取一段、做聚合、画趋势",关系库写多了会膨胀、查询也慢。时序数据库针对这些做了专门优化:高频写入吞吐高、按时间自动分组、自带"按时间范围聚合降采样"的查询能力、并把"过期数据自动清理"做成内置策略。于是"存很多点、按时间查、留多久都配套"成为它最拿手的。
它在监控栈里的位置:它不像 Prometheus(也是时序库,但更偏拉取式 + 标签维度 + 与服务发现强绑定,常配 Grafana)那样自带抓取与服务发现;InfluxDB 更像一个"主动写入的通用时序存储",配合采集器 Telegraf、可视化 Grafana,是另一条流行、也极易扩展的监控组合。二者都能配 Grafana 画图,选 InfluxDB 往往因为"要接多种数据源、写法/查询习惯、或 Prometheus 之外的采集需要"。
二、用 Telegraf 采集:一条命令把系统/服务指标喂进 InfluxDB
时序数据要先"采"到。最常用的采集器是 Telegraf:它以"插件"方式从各种来源拉指标——系统(CPU/内存/磁盘/网络)、数据库、Docker、进程、SNMP、HTTP 探活等,然后把它们格式化成时序点写入 InfluxDB(或别的输出端)。用法是"配一个 toml 指定 input(从哪采)output(写到哪),跑起来它就周期性采并写"。如果你已经跑了一堆自托管,Telegraf 一次接入就能把"系统 + 若干关键服务"指标准时入库,成为 Grafana 画板的原料。
# telegraf.toml 最小示意:采系统指标,写到本地 InfluxDB
[[inputs.cpu]]
  percpu = true        # 每个 CPU 单独采
[[inputs.mem]]
[[inputs.disk]]
  ignore_fs = ["tmpfs", "devtmpfs", "overlay"]
[[inputs.net]]

[[outputs.influxdb]]
  urls = ["http://127.0.0.1:8086"]
  database = "telegraf"
  username = "tgraf"      # 最小权限账号
  password = "强密码"

# 采集器运行(systemd 或 docker)
#   telegraf --config /etc/telegraf/telegraf.toml
采集的坑主要是"权限最小化"与"量别爆":给 Telegraf 用最小权限账号(只写不读管理),别用 root;被采的指标要选够用即可,别把所有插件全打开——每多一个高频率采集都多一份磁盘与写压。先配好"采什么、多久采一次、写哪个库",再谈查询与清理。
三、查询与清理:InfluxQL/Flux 取数 + 保留策略/降采样控制留存
数据采进来了,下一步是"能查 + 能控时间"。InfluxDB 的查询语言有 InfluxQL 与较新的 Flux,都能"按时间范围取一段 + 按 interval 聚合(如每 5 分钟求均值)+ 筛选 measurement/field/tag"。而"数据存多久、要不要老化降采样"由保留策略/桶(bucket)与连续查询/任务控制:你可以设"原始细节只留 7 天,再对 7 天前的数据按小时/天聚合降采样后再留更长"。这样既保证近期有高频细节,又不让海量原始数据无限放大磁盘,是生产用法。
# InfluxQL 示例:查 最近 2 小时、每 5 分钟聚合的 cpu 使用率的均值
SELECT mean("usage_idle")
FROM "cpu"
WHERE time > now() - 2h
GROUP BY time(5m), "cpu"

# 保留策略:让原始数据只留短、越久越粗(示意)
#   ALTER RETENTION POLICY "autogen" ON "telegraf"
#     DURATION 7d SHARD DURATION 1d DEFAULT
# 再配一个每 1 小时把"1 天前的数据降采样到 1 小时粒度"的连续查询/任务,
# 让"长期趋势"用便宜得多的粗粒度数据提供,而不是永久囤原始点。
留存的黄金法则:别让"原始高频点"无异地堆成人厌。设好"近期细节 + 历史粗粒度"的两段式保留,既能回答"昨晚 3 点到底高到多少"这种近期档,也能看"这半年趋势"这种长期档,还不会把磁盘吃光。这是 TSDB 用好与用砸的分水岭。
四、常见坑:写入量爆掉、查询卡顿、磁盘规划与安全
InfluxDB 跑起来,四个坑要尤其防。一是"写入量爆掉":采集频率太高 + measurement/tag 太多 + 数据点爆炸,写入超限、内存/磁盘飙升——用合理采样频率 + 精简 tag + 按需采集来控量。二是"查询卡顿":跨超大时间范围 + 高基数 + 没降压采样的裸查询会又慢又吃内存——善用时间范围限制、降采样与索引 tag,别做全表扫。三是"磁盘规划":时序数据最易无声长胖,务必提前定好保留策略、监测磁盘、并安排备份/导出(InfluxDB 自带备份与 export)。四是"安全":InfluxDB 即便只收本机也设强密码、限监听地址,配上 HTTPS 与反代,别把裸 8086 暴露公网——它是"能写数据的后门"。
# 排查思路
#   写入变慢/失败:看 InfluxDB 日志与"线速率/磁盘"监控,多半是写入量大
#   查询慢:加 backpressure 提示后,先缩小 time 范围再看是否需降采样
#   磁盘吃紧:检查各 bucket/保留策略留多久,收紧"冗余原始点"
# 备份:
#   influx backup /srv/influx-backup-$(date +%F)
把这当排障 SOP:先看"是不是采太多了(写压)"、再看"查询是不是全表扫(慢)"、后查"保留策略有没有失控(磁盘)"。时序监控最怕"数据源写崩"导致连监控都没了,所以 InfluxDB 自身也要纳入磁盘与日志监测。
五、边界:TSDB 管"时序指标",不当关系库用,也不替代真实可观测
InfluxDB/TSDB 的边界要认清:它擅长"随时间增长的高频指标",但不适合当"事务关系库"用——关系、多表 join、强一致事务不是它的强项,别把业务关系数据硬塞进时序库。其次,它存的是"指标",补足不了"日志/链路"这类别的可观测维度——完整可观测是 指标(metrics)+日志(logs)+链路(traces) 三件套的配合,InfluxDB 管其中一腿。最后,时序库数据量大、是重要的历史资产,要在备份与迁移上给足规范,别把"监控数据"当可有可无的东西随手丢。
把 InfluxDB 放回自托管整体:它是"把系统与应用的时序指标按时、可查询、可控留存地存下来供分析与画图"的存储基座。落地要点:用 Telegraf 加最小权限账号按时采集到 InfluxDB,配 Grafana 做可视化;用保留策略 + 降采样把"近期细节 + 历史粗粒度"两段式留存,防止数据爆长;防住写入量爆、查询卡顿、磁盘失控、接口裸奔四坑,并配好备份;认清它管时序指标、不当关系库、也补不了日志与链路。当你把时序数据"按时采好、按需查、按策略留、有备份"这套闭环做成,自托管的监控才从"看一块板"升级为"有根有据、留得住查得动"。
结语
InfluxDB 与 TSDB 的价值,是为"随时间增长的高频指标"提供写入快、按时间查询顺、能自动控留存的存储,与 Telegraf、Grafana 组成易扩展的自托管监控组合。落地要点:用 Telegraf + 最小权限账号按时采集,按测量项精简;用保留策略 + 连续查询/降采样把数据做成"近期细节 + 历史粗粒度"两段留存,防止磁盘被原始点吞掉;防住写入量爆、查询卡顿、磁盘失控、接口裸奔四坑,并定期备份;认清它是时序存储、不当关系库、也补不了日志与链路。当你把时序指标按时采好、按需查得动、按策略留得住、还带备份,自托管的监控数据才会成为真正可靠、可回溯的历史资产。