Kubernetes 能跑起来,靠的是"一批 Pod 既互相能通、规则又受控",而这一切底层是一套叫 CNI(Container Network Interface)的插件在替容器搭桥、插路由、配策略。很多自托管用户跑 K3s/K8s 只用默认网络,没理解"Pod 之间的网络是 CNI 给的"——于是遇到"服务间通不了、跨主节点不通、想隔离却控制不住"时就无从下手。这篇讲清 CNI 解决什么、主流插件(Flannel/Calico/Cilium)差异、Pod 网络/Segment/策略的三层关系,以及常见坑与边界。
一、CNI 解决什么:给"每个 Pod"标配一块网卡 + 一条可达的路
容器隔离了进程,但也把网络隔开了;K8s 要求"每个 Pod 都有自己稳定的 IP、任两个 Pod 无论在哪台节点都能互通"。谁来做这件事?就是 CNI 插件:它负责为每个 Pod 在网络命名空间里创建/挂接虚拟网卡、分配唯一 IP、配置路由让各节点与各 Pod 之间可达。没有 CNI,Pod 要么没有 IP、要么互不相通。所以"Pod 网络的整个格局(IP 段、跨节点转发、是否重叠)"都取决于你选用了哪个 CNI、怎么配。
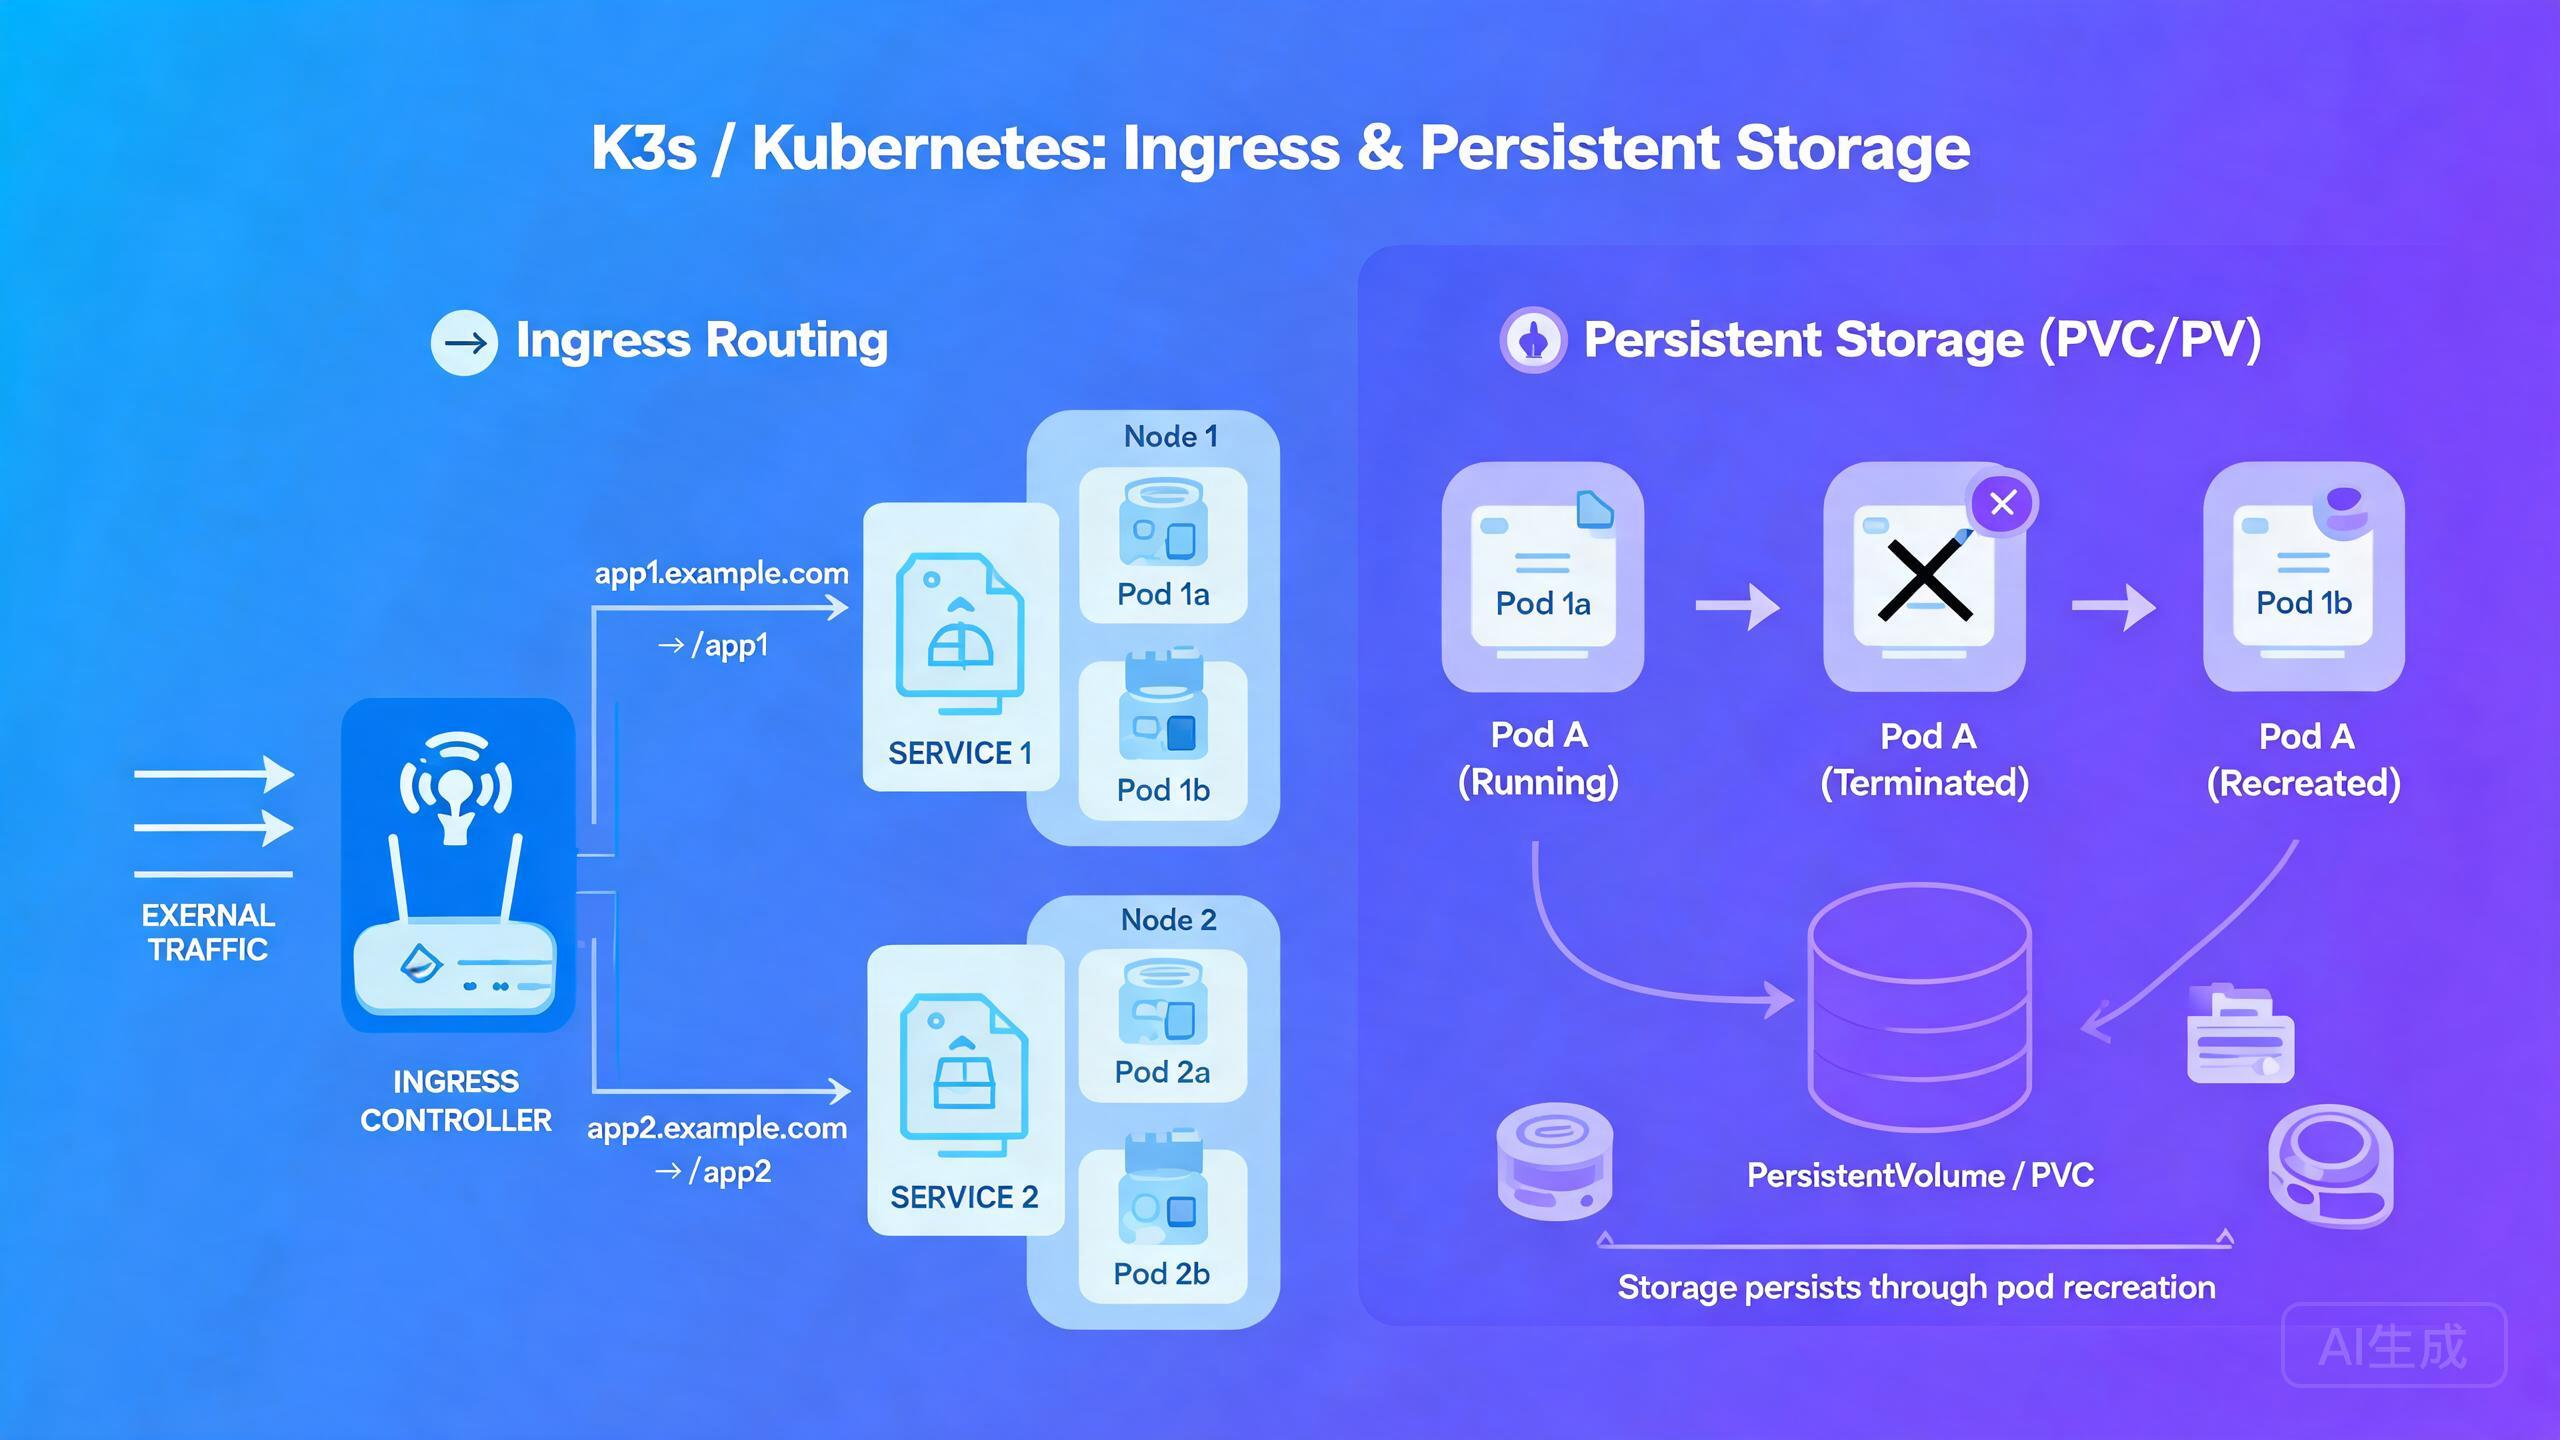
把层次分清能避免很多困惑:K8s 的 Service 负责"把一组 Pod 的流量负载均衡暴露给入口(ClusterIP/NodePort/LoadBalancer)",Ingress 负责"按域名/路径把外部流量路由到 Service";而 CNI 是更底层的那一层——它先确保"Pod 之间有可用的网络和路由",上面的 Service/Ingress 才能工作。很多"Service 通不了"的怪问题,根子其实在 CNI/网络层。
二、主流 CNI 怎么选:Flannel 简单、Calico 策略强、Cilium 是新锐
自托管最常见的三个 CNI 取舍很清晰。Flannel:最简单,主打"给每个 Pod 一个 IP 并让它跨节点可达",用 VXLAN 等封装做 overlay;适合"只要通、不想折腾"的场景,但基本不带网络策略(NetPol)。Calico:BGP + IPIP/ VXLAN,支持精细的 NetworkPolicy 网络隔离、带宽限制、甚至多网卡/负载;能力全面、资料多,是"想要隔离与策略"的默认选择。Cilium:基于 eBPF 的新锐,性能好、可观测性好,自带较成熟的网络策略、透明加密、还可扩展服务网格;能力最强但学习和运维门槛也高。选型原则:先问"要不要网络策略/隔离、有多大集群、愿不愿意养复杂 CNI"。
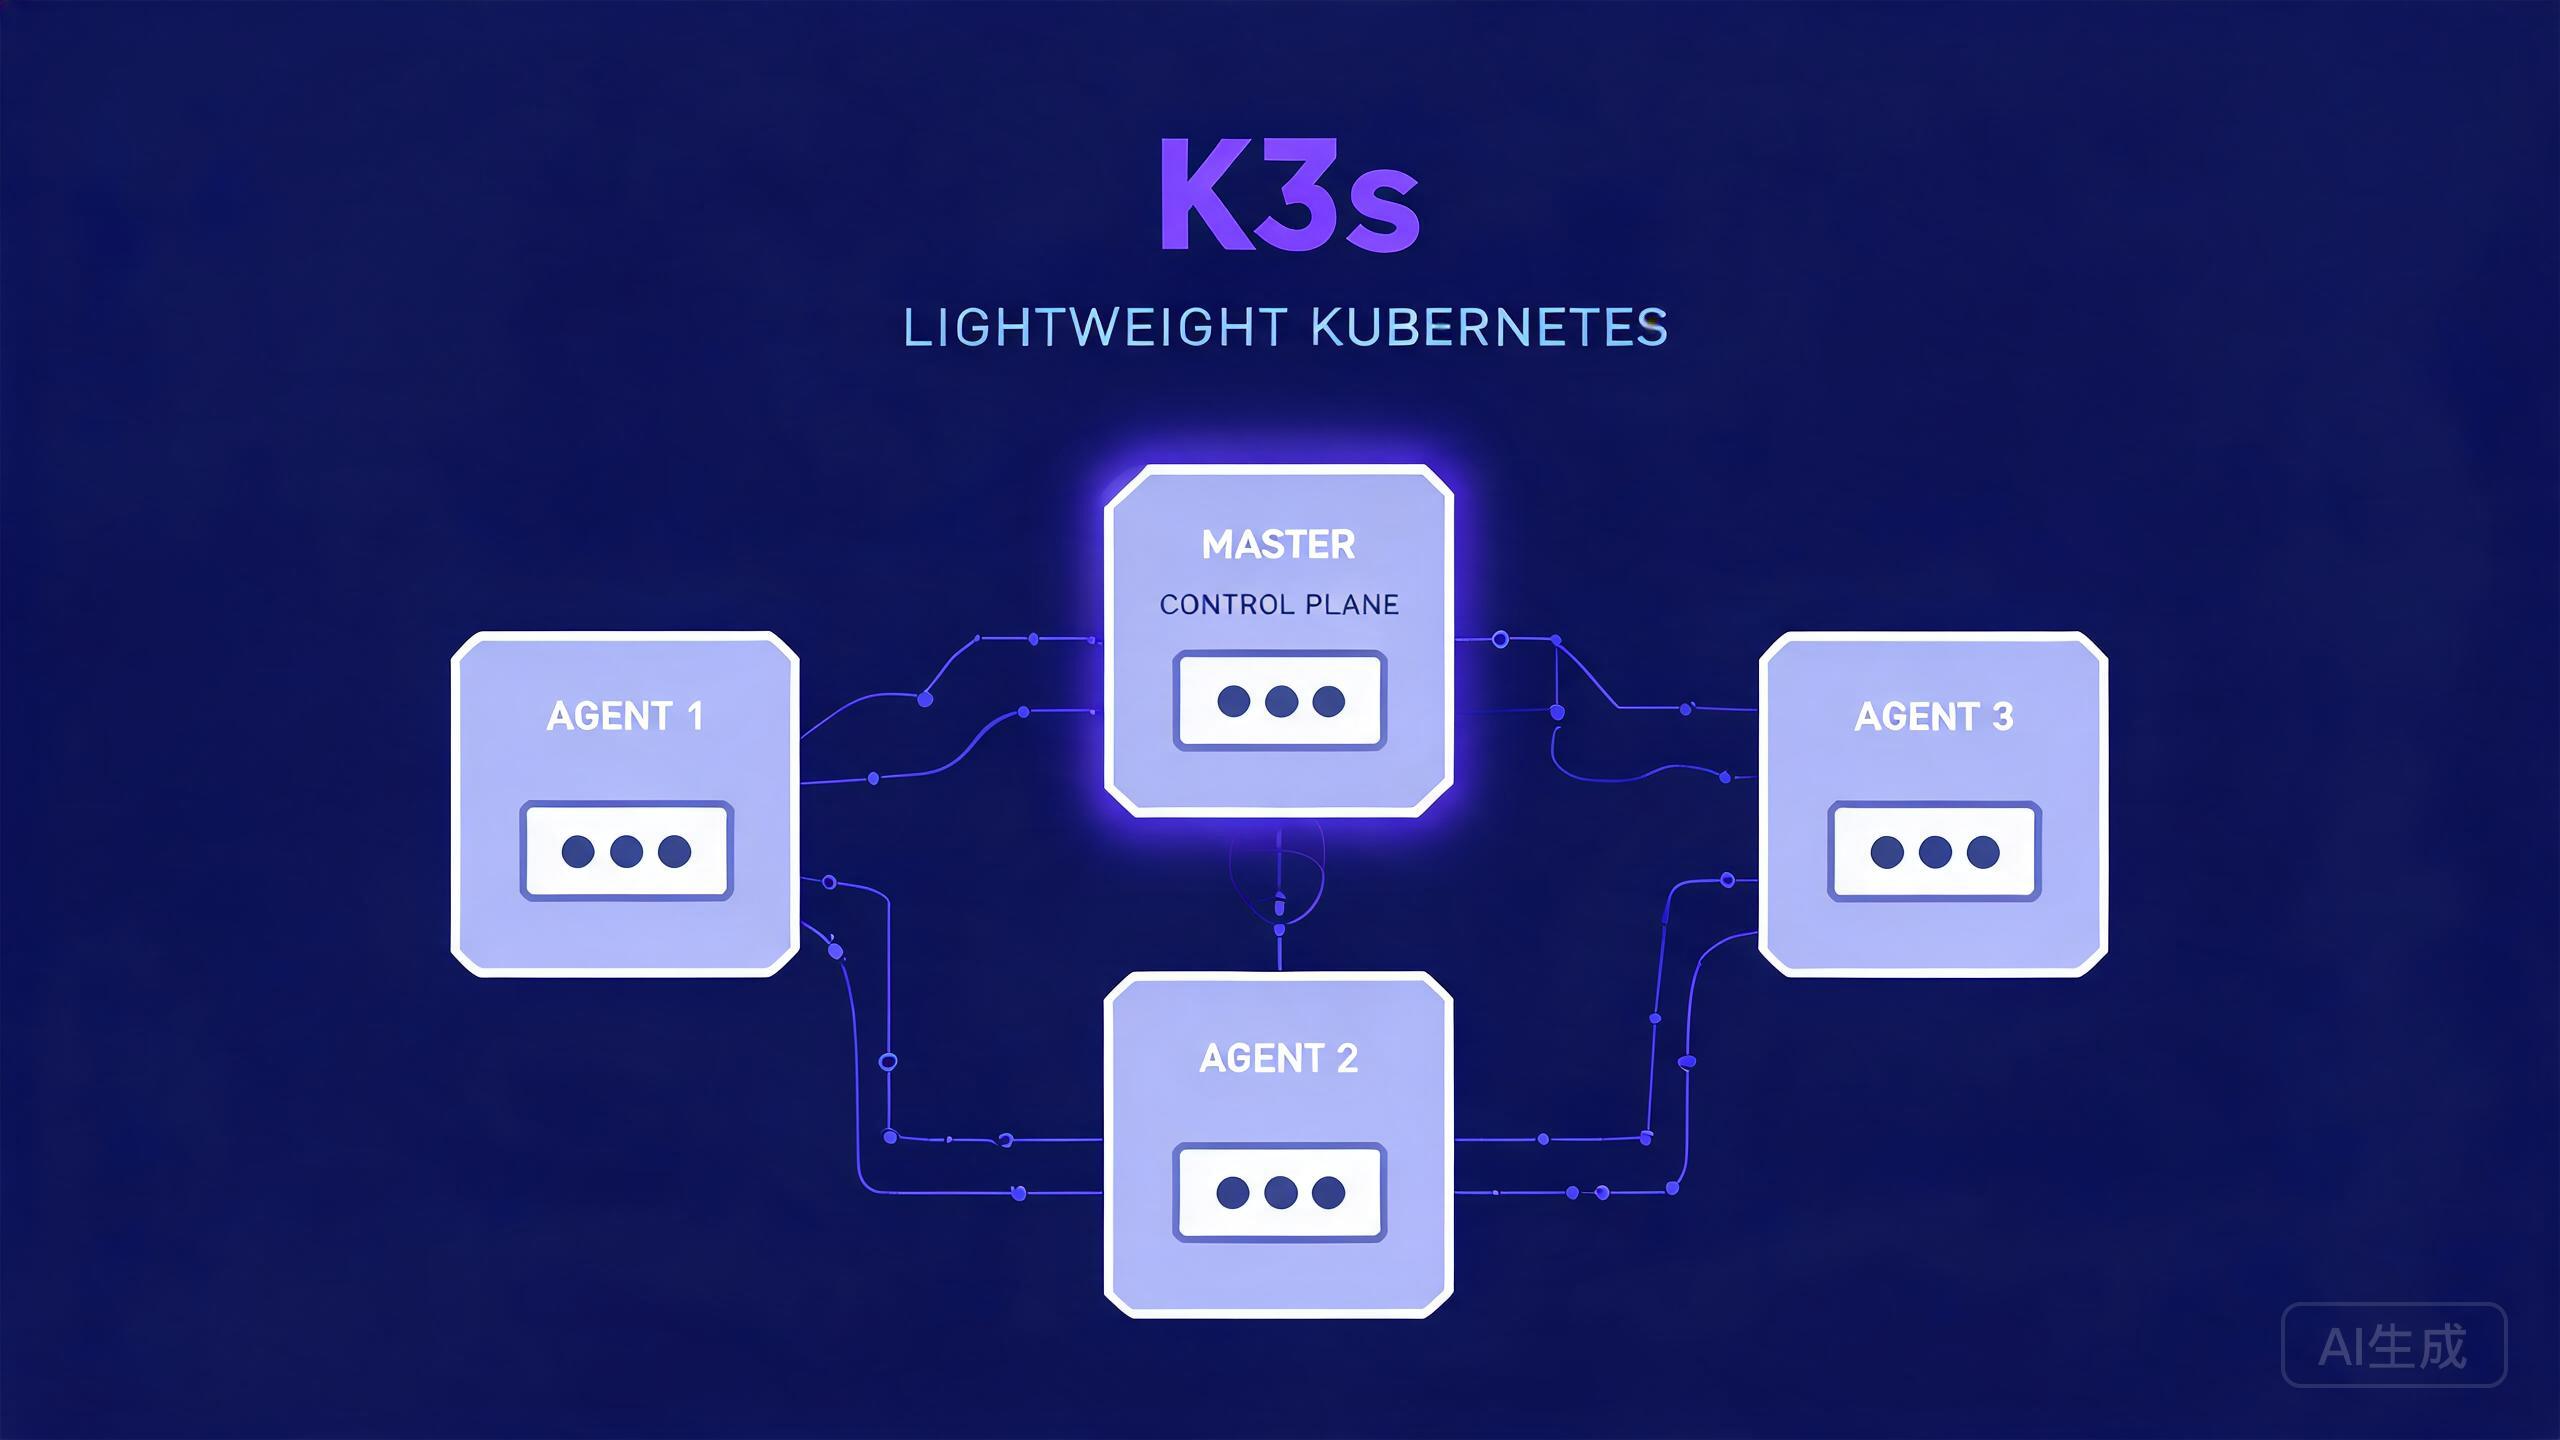
# K3s 默认用 Flannel(k3s 启动参数可拿到 CNI)
#   k3s server --flannel-backend=wireguard-native   # 内置 flannel(可换后端)
# 若用 Calico,常通过 k3s --flannel-backend=none 后手动装 Calico:
#   kubectl apply -f https://raw.githubusercontent.com/.../calico.yaml
# 装什么 CNI 决定 Pod 网段/路由/策略能力,换 CNI 往往要重建节点网络、
# 存量 Pod 重建,所以"一开始就想清楚"比"事后折腾换"省事得多。
对纯自托管、一台到几台机器、主要要"稳定通"的,Flannel 往往够;要"能按命名空间/label 做隔离、拦住不该通的"就上 Calico;要是资源足、想要 eBPF 性能与可观测、也愿意学,可上 Cilium。判定标准是"你的需求到哪一层"——别为了高级而上 Cilium,除非明确需要它的能力。
三、Pod 网络 / Segment / NetworkPolicy:从"通"到"受控"
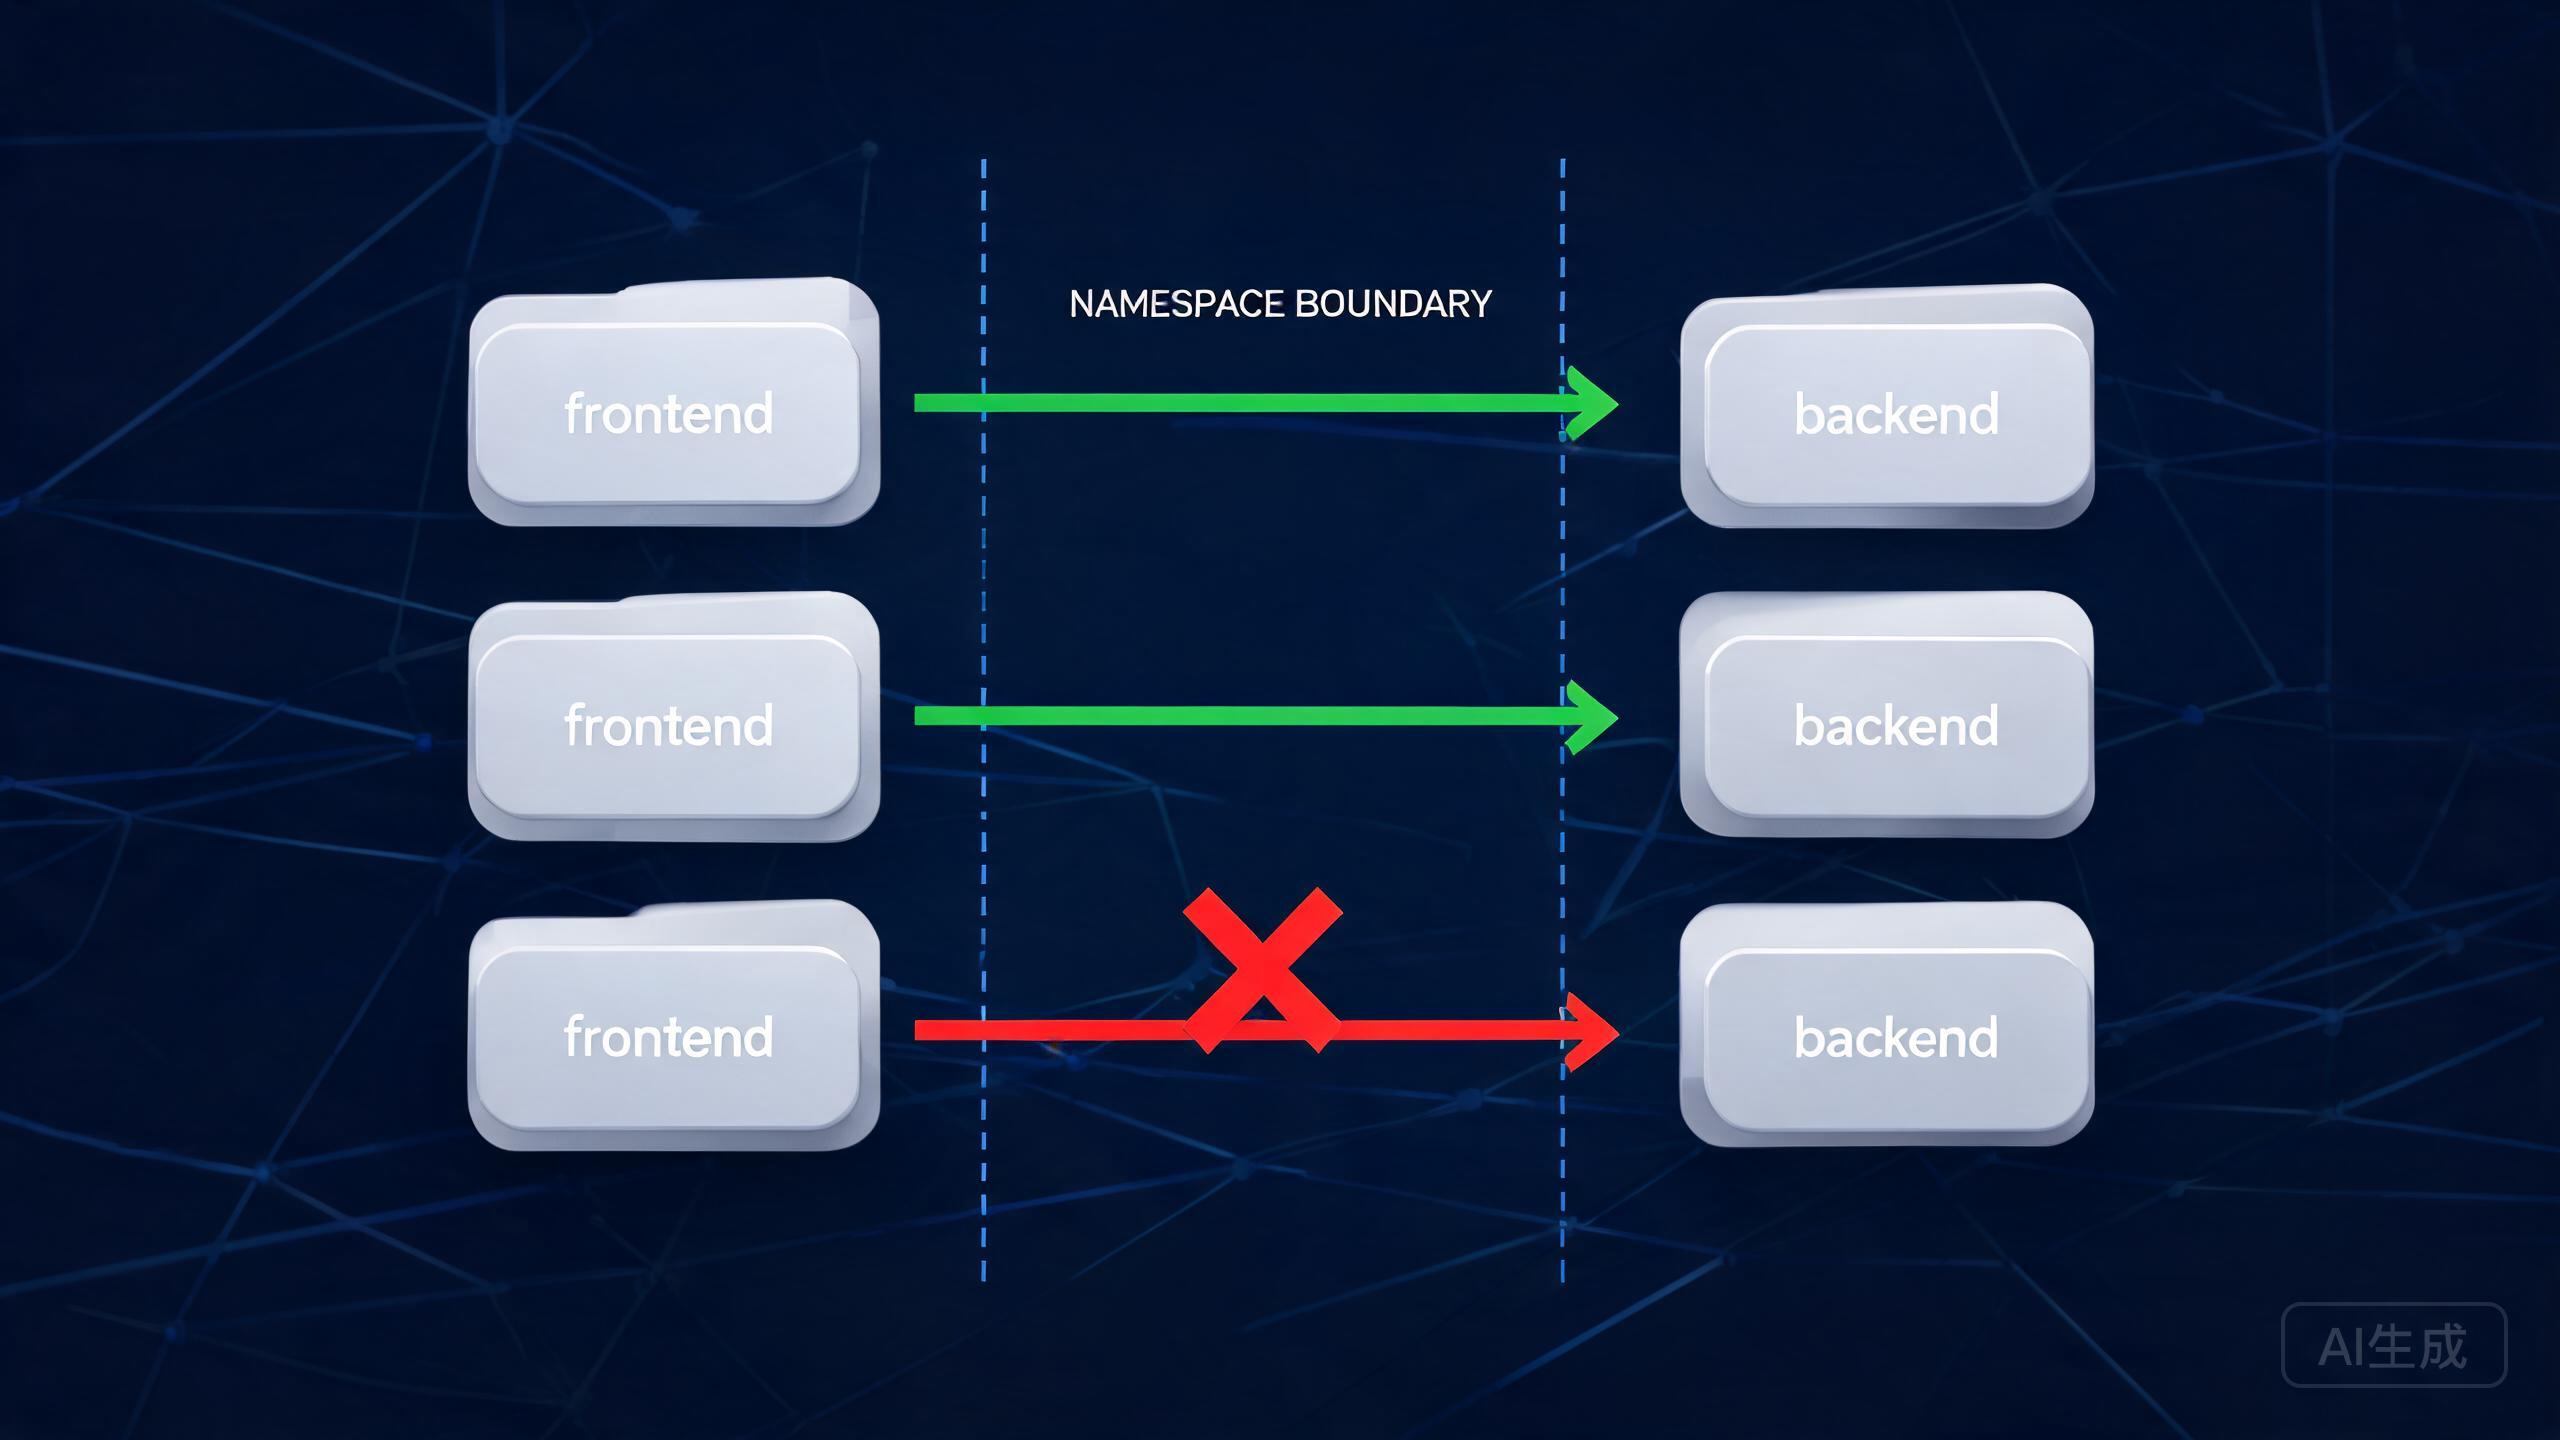
CNI 不只解决"通",还提供"受控"。K8s 里体现"受控"的主要是 NetworkPolicy(NetPol):声明"哪些来源能访问哪些 Pod 的哪些端口"。要实现 NetPol 必须依赖支持策略的 CNI(Calico/Cilium;Flannel 默认不支持)。而"隔离维度"则由命名空间、Pod 的 label 来表达:你能定义"只允许带 app=front 的 Pod 访问带 app=api 的 Pod 的 8080 端口"。这样集群内部不再是"谁都能连谁",而是"按策略收拢"——这通常是不信任内部网络、做纵深防御时很重要的一环。
# 一条 NetworkPolicy 示意:只允许带 app=front 的 Pod 访问 api 的 8080
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: api-allow-front
spec:
  podSelector: { matchLabels: { app: api } }
  ingress:
    - from: [ { podSelector: { matchLabels: { app: front } } } ]
      ports: [ { protocol: TCP, port: 8080 } ]
# 注意:此策略要生效,需要 CNI 具备策略引擎(Calico/Cilium)
话术要先建立:NetPol 的语义是"白名单"——不显式放行的默认拒绝(取决于实现,部分 CNI 默认要求有策略才拒绝)。所以上线 NetPol 前先看当前 CNI 是否支持、并把"默认行为"档位搞清,否则一次收紧策略可能把所有连通都切断。从"能通"到"受控"是阶梯:先通、再分命名空间、最后上 NetPol 逐条放行,步步为营更稳。
四、常见坑:CNI 换装、跨节点路由、MTU、Service 与 NetPol
网络层出问题最隐蔽,四个坑要尤其注意。一是"跨节点不通":多节点时 Pod 在不同节点要靠 CNI 的转发(VXLAN/ BGP)/路由,防火墙、内核转发开关(ip_forward)、云厂商安全组没开都会导致跨机不通——排查要从"单机内通不通"到"跨机呢"逐层推进。二是"MTU 不匹配":VXLAN 会降低有效 MTU(如容器内 1450/1392),应用大包/某些协议(DHCP/部分 VPN)会因为分片问题连不上——按网络栈对好 MTU 别乱改。三是"换 CNI 的代价":换 CNI 常要重建节点网络、存量 Pod 重新调度,相当于动"地基"——尽量一开始就定好,变更前先备份清单并在低峰演练。四是"NetPol + Service 主次搞反":Service 能通不代表 CNI 策略没问题,跨命名空间被 NetPol 挡住的"Service 时通时不通"很常见——把 NetPol 与 Service/ClusterIP 的配合也纳入排查。
# 网络层排查 SOP:逐层定位"哪里断了"
#   1) 两个 Pod 在同一节点能 ping 通吗(同机内通?)
#   2) 不同节点的 Pod 能通吗(跨机路由/转发?)
#   3) 通过 Service 访问通吗(ClusterIP 转发?被 NetPol 挡?)
#   4) 看 CNI 组件日志/状态:kubectl -n kube-system get pods | grep -E 'calico|cilium|flannel'
网络故障最怕"只盯着应用"。把"单机→跨机→Service→策略"这条排查链固定成习惯,多数"时通时不通"都能精确定位到某一层:同机不通多半容器/CNI,跨机不通多半路由/防火墙/MTU,Service 不通结合 CNI 与 NetPol 一起看。别一上来就在应用里加重试,把根子找到更省心。
五、边界:CNI 管"Pod 之间的可达与受控",管不了出口与数据
CNI 的边界要认清:它负责集群内部的 Pod 网络连通与隔离策略,但"Pod 访问外网 / 外部访问集群"通常是额外的 egress/ingress 配置(路由、NAT、Ingress/网关)的事,不单是 CNI。其次,网络策略管"能不能连、连什么端口",管不了"业务数据是否正确"——数据的安全与备份仍是数据库与备份的职责。再则,越强的 CNI(尤其 Cilium/eBPF)意味着越深的依赖,升级内核/换 Node 时更易受影响,要有"网络层变更的演练与回退预案"。把"内部可达与受控"与"外部出入口"分开理解,才能把 K8s 网络这块想明白。
把 CNI 放回自托管整体:它是 K8s"Pod 之间能通且受控"的地基,Service/Ingress/策略都建其上。落地要点:先想清楚要"通"还是"通+受控"再选 CNI——Flannel 管通、Calico 加策略、Cilium 更强但更重;用命名空间 + label + NetworkPolicy 把"谁访问谁的哪个端口"收拢成策略,步步为营从通到受控;防住跨节点路由、MTU 不匹配、换 CNI 重代价、NetPol 与 Service 混淆四坑;并认清它管内部可达与受控、管不了外部出入与业务数据。地基一旦被 CNI 架稳,其上的一切"服务互通、策略隔离"才会真正可靠。
结语
Kubernetes 网络模型与 CNI 的价值,是给每个 Pod 一块"能与任何其他 Pod 互通、并受策略约束"的网,是集群内一切 Service/Ingress 的地基。落地要点:三选一——Flannel 只要通、Calico 要策略/隔离、Cilium 要 eBPF 性能与能力,按需求选而别跟风;用 NetworkPolicy 结合命名空间与 label 把"谁访问谁的哪个端口"做成白名单式受控;防住跨节点路由、MTU、换 CNI 重代价、Service 与 NetPol 混淆四坑,并按"同机→跨机→Service→策略"的排查链定位故障;认清它管集群内部可达与受控、管不了外部出入与数据。把 Pod 网络这块地基用 CNI 架稳并配好策略,K8s 自托管才会从"能跑"走向"既能通、又受控、还能查"。