Kubernetes 在很多人眼里是"大厂才玩得起的东西":一堆 master + worker、etcd、各种网络插件,跑起来就吃掉几 GB 内存,还要一条 DDL 手册才能配置明白。其实对自托管、边缘、实验室这类场景,有一个很轻的选择叫 K3s——它就是给"资源有限、想少折腾、又要标准 K8s API"的人设计的:安装只要一条命令,默认用 SQLite 不用 etcd,网络默认用轻量的 Flannel,几分钟就能在一个单机甚至一块树莓派上跑起标准 Kubernetes 集群。这篇讲清 K3s 到底砍掉了什么、怎么把一台 VPS 变成集群、以及 Server 和 Agent 的关系、存储与备份这几个自托管最关心的点。
一、K3s 不是"阉割版 K8s",而是"单二进制 K8s"
K3s 和标准 Kubernetes 用的是同一套 API 和语义——你能用 kubectl 操作的一切它都能操作,Pod、Deployment、Service、Ingress 这些概念一个不少。它的"轻"体现在打包方式:把所有核心组件(API Server、controller-manager、scheduler、kubelet、kube-proxy 逻辑)打进一个单二进制,把可替换的存储从 etcd 换成 SQLite(当然它也支持 etcd,用于多节点高可用模式),把内置网络做成轻量的。
这带来三个直接感受。一是内存占用比完整集群低得多,一两 GB 内存甚至更低就能跑;二是安装体验被压成"一条命令 + 一个 token";三是它保持了跟上游同步的 API 标准,所以你学到的、写出来的 YAML,拿到正规 K8s 集群一样能用。它的定位是"让标准 K8s 变得对小机器友好",而不是"另起炉灶的简化玩具"。
二、最小上手:一台机器装出集群
在一台 Linux VPS(建议 1-2 GB 内存起)上,默认安装会同时跑起"Server(控制面 + 数据面)",单机单角色就已经是一个能用的集群:
# 在要当 Server(控制面)的机器上安装
curl -sfL https://get.k3s.io | sh -
# 之后本机就能用 kubectl
kubectl get nodes

# 看集群运行需要的核心日志
journalctl -u k3s -f
装完 `kubectl get nodes` 应该能看到本机处于 Ready。一台机器就搞定,是因为默认单节点时 Server 同时承担调度和运行 Pod 的角色。如果你只在很单一的机器上跑几个自托管应用,这个"单节点 K3s"是最低摩擦的起步:安装脚本会自动注册成 systemd 服务,改配置后重启 k3s 服务即可。要加节点,则看下面的 Server / Agent 模型。
三、多节点时才需要知道 Server 与 Agent 的分工
单机够用,但很多人想"再多加一两台 VPS 组成小集群"。这时要理解 K3s 的两个角色:Server 是控制面(管理集群、管 API),Agent 是被管的数据面(实际跑业务容器)。注意:K3s 里不叫 worker,而叫 Agent。新增一台 Agent 只要一条命令,带上 Server 的地址和共享的 join-token:
# 在 Server 上拿到加入集群的 token
sudo cat /var/lib/rancher/k3s/server/node-token

# 在另一台要加入的机器上执行(把地址和 token 换成你的)
curl -sfL https://get.k3s.io | K3S_URL=https://server-ip:6443 \
  K3S_TOKEN=你的token sh -
多节点场景最需要提前想清楚的三个点:一是存储——Agent 上的 Pod 数据默认放在本机,如果跑的是数据库,节点一挂数据就悬,得依赖下面说的持久化方案;二是网络——多节点的容器互通靠内置网络插件,跨机器要保证端口互通;三是控制面高可用——只有单个 Server 时,Server 挂了整个集群的 API 就不可用,想要高可用集群需要部署多个 Server + 真正的 etcd,那是进阶话题,自托管一般先不碰。
四、让数据别跟着 Pod 走:PersistentVolume 与 StorageClass 实践
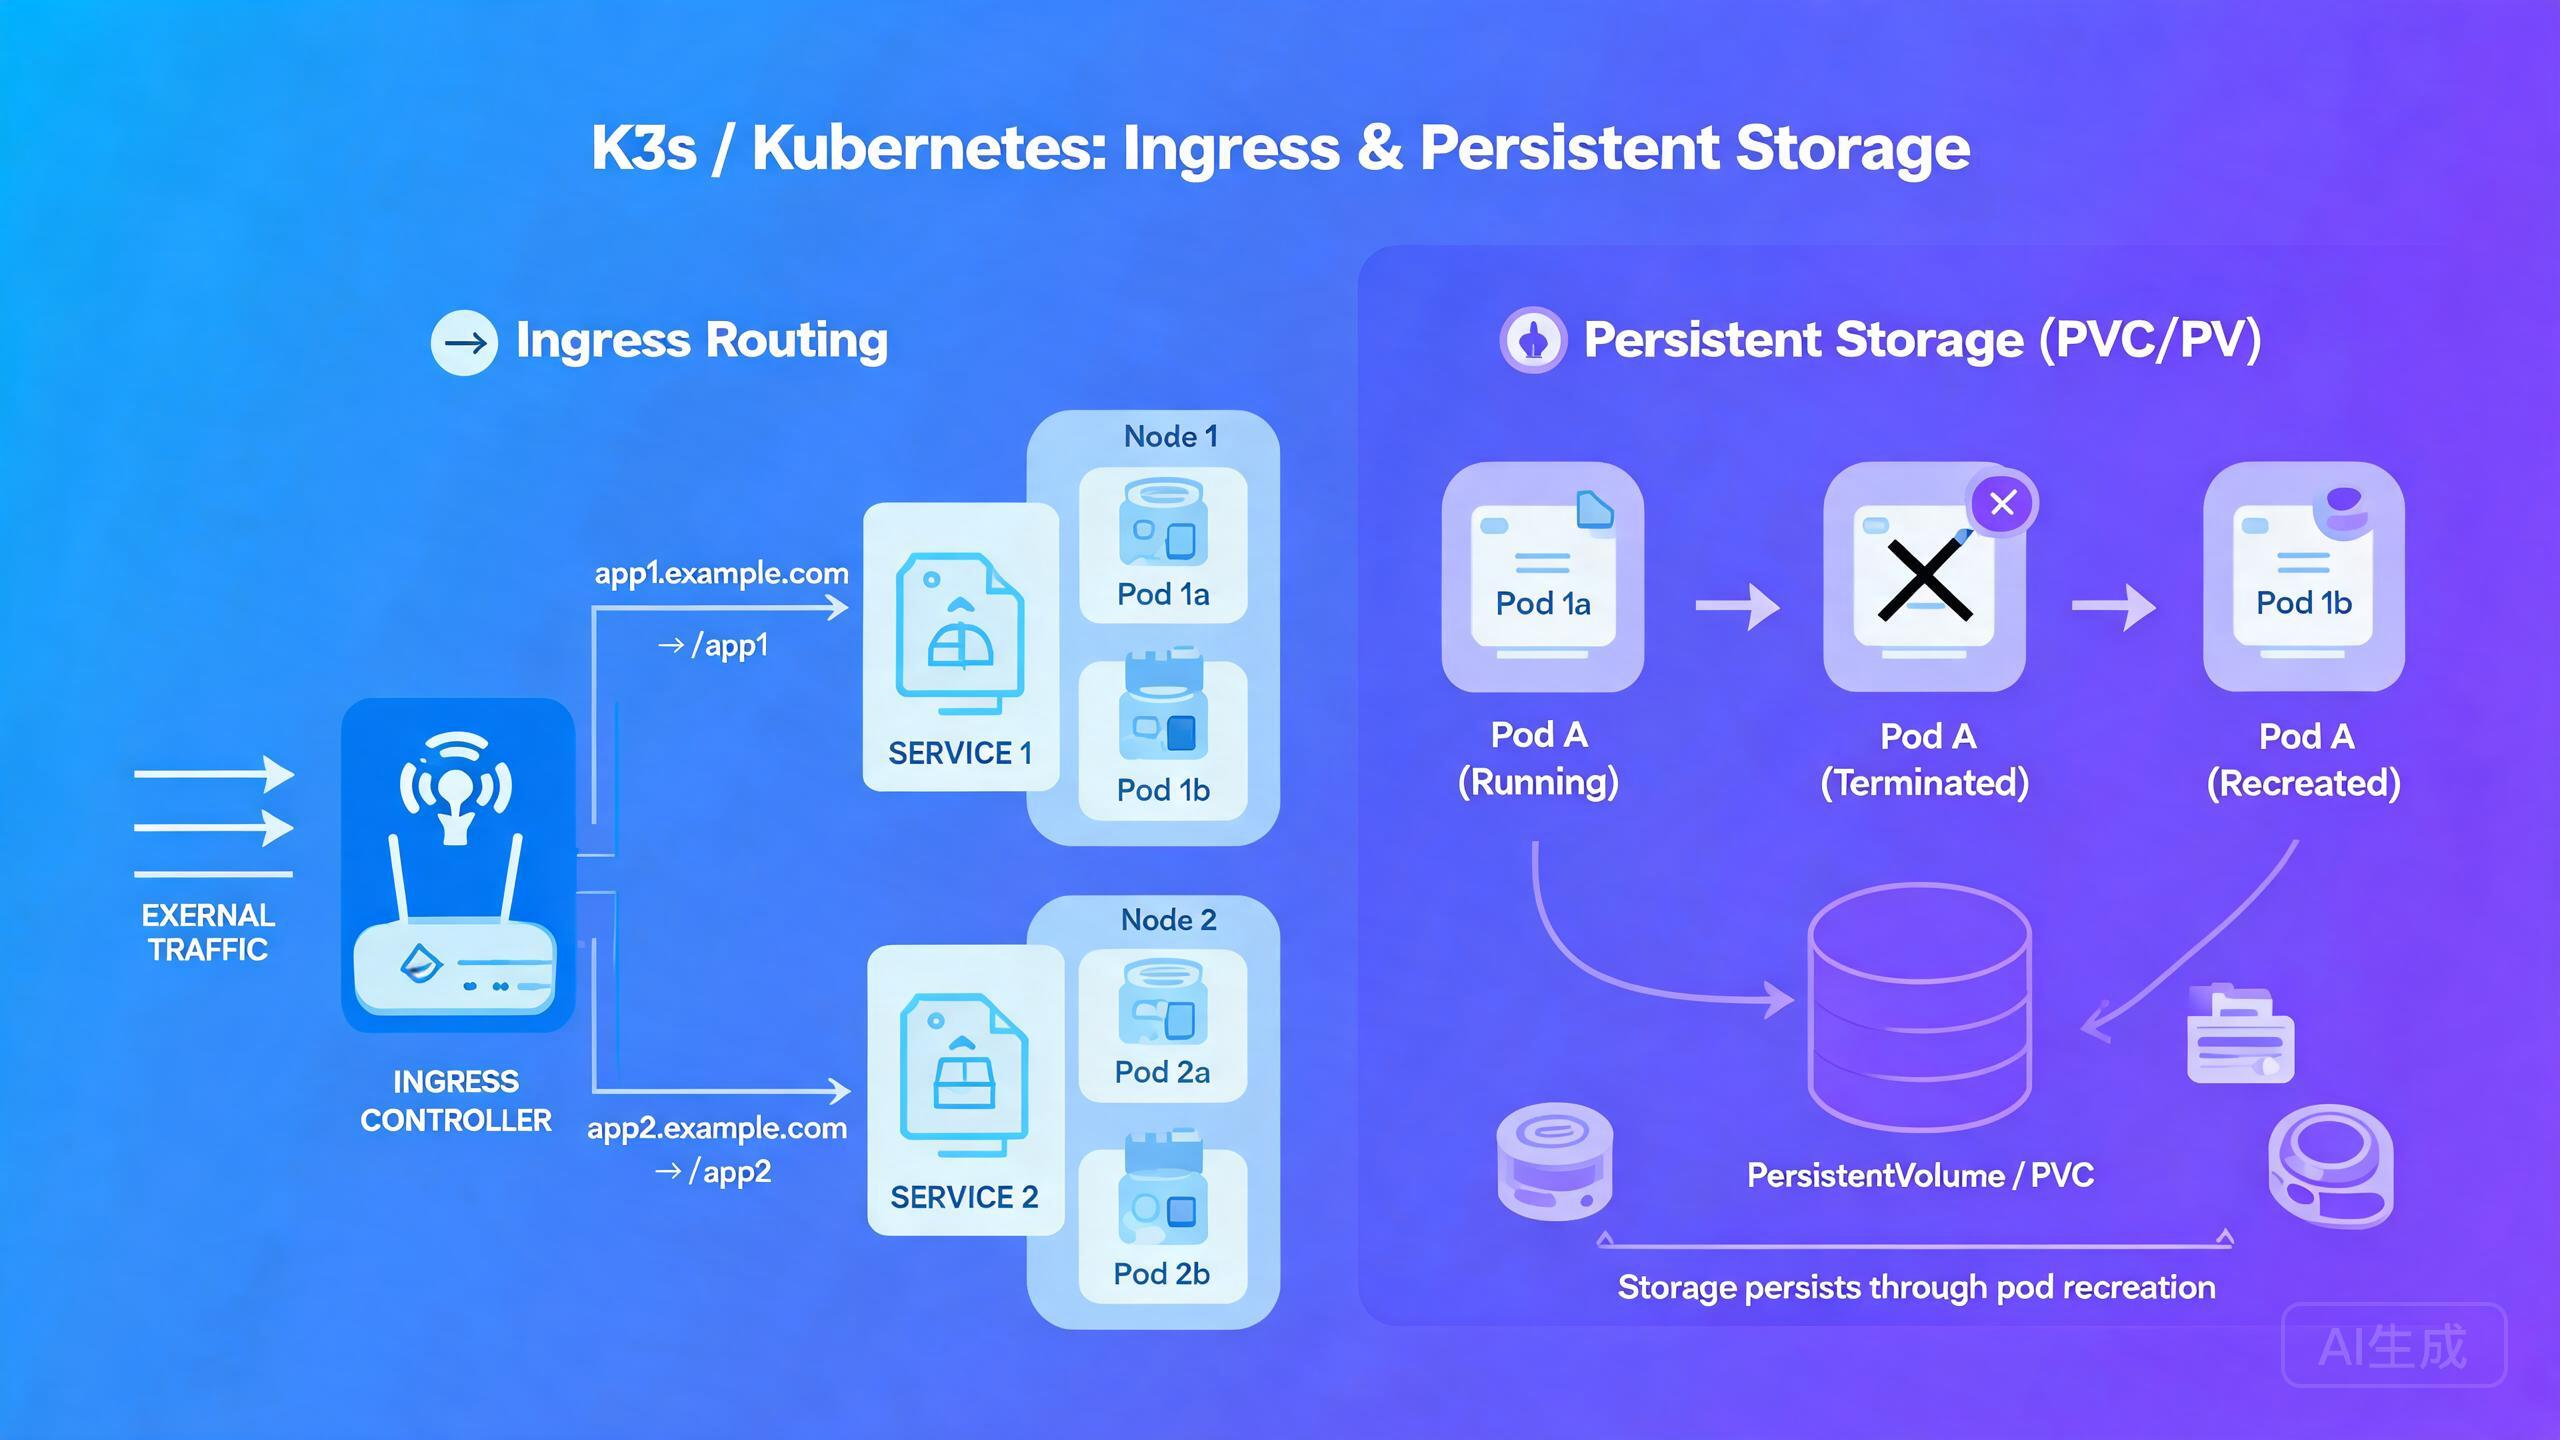
Kubernetes 的理念是"Pod 是瞬态的",但你的数据库、配置文件不能是。所以要用持久化卷(PersistentVolume,PV)把数据从 Pod 生命周期里剥离出来。K3s 内置了两种最常用的 StorageClass:local-path(数据落到节点本地目录)和 OpenEBS/Longhorn 这类基于网络的方案。对单节点或少量 VPS,local-path 是最常见的起步选择。
# 一个用 local-path 持久化的示例:声明 PVC 并挂到 MySQL
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: mysql-data
spec:
  accessModes: [ "ReadWriteOnce" ]
  storageClassName: local-path
  resources:
    requests:
      storage: 5Gi
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: mysql
spec:
  selector:
    matchLabels: { app: mysql }
  template:
    metadata:
      labels: { app: mysql }
    spec:
      containers:
      - name: mysql
        image: mysql:8
        env:
        - { name: MYSQL_ROOT_PASSWORD, value: "改这里" }
        volumeMounts:
        - { name: data, mountPath: /var/lib/mysql }
      volumes:
      - name: data
        persistentVolumeClaim: { claimName: mysql-data }
把数据库迁上 K3s 时我会提醒一个朴素但常被忽略的坑:local-path 数据在"那台 Agent 机器上",如果节点坏了或你要迁移集群,数据不会自动跟着走。所以在用 local-path 存重要状态前,先想清楚"这台机器坏了,数据还在吗"。对真正的关键数据,要么给节点做磁盘级别的备份,要么转用能跨节点复制的存储方案,并且始终配合"应用自身的数据备份"(比如数据库 dump)作为最后兜底。
五、自动证书、资源边界与备份:几个自托管高频设置
用 K3s 承接自托管服务,有三件事值得主动配置。第一是自动 HTTPS——K3s 内置的 Traefik Ingress Controller 配上 cert-manager,就能让每个域名自动申请并续期 Let's Encrypt 证书,访问统一走 Ingress。给一个最小 Ingress 示例:
# 定义一条 ingress,把 app.example.com 的 HTTPS 流量送到 my-app 服务
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: my-app
spec:
  ingressClassName: traefik
  rules:
  - host: app.example.com
    http:
      paths:
      - path: /
        pathType: Prefix
        backend:
          service:
            name: my-app
            port: { number: 80 }
  tls:
  - hosts: [ "app.example.com" ]   # 配合 cert-manager 自动签证书
第二是内存边界——小机器上最怕"一个 Pod 把所有内存吃光"。一定要给容器设 `requests`/`limits`(上面 MySQL 里那种写法),并给 namespace 加 ResourceQuota,让超额的服务被调度器挡住而不是把整机拖死。第三是备份——K3s 有一个官方备份工具(k3s etcd snapshot,多节点 etcd 模式下)以及社区常用的 velero 方案;对单节点自托管,最务实的是"定期把关键 PVC 目录 + 数据库 dump 一起打包备份",别指望集群本身替你扛数据安全。
六、什么情况别硬上 K3s
K3s 很香,但不是所有场景都该用它。如果你只有一两台机器、服务就两三个、还都用 Docker Compose 管得挺好,那硬搬上 Kubernetes 纯粹是给自己加负担——K8s 的编排能力在应用数量少、依赖简单时体现不出来,反而多了一套控制面要维护。更合适的场景是:应用数量开始变多、想要统一的部署清单与回滚、想让多个服务之间用标准 Service/Ingress 组织和伸缩、或者想"用标准 API"但机器资源不足以跑完整集群。
一句话判断标准:当"十几二十个服务的部署、更新、证书、暴露方式"已经多到 Compose 和脚本管得手忙脚乱时,K3s 就值得上了;在那之前,先别为了解决一个小问题引入一个大系统。把它当成"到规模了再请来的管家",而不是"一装就全能"的银弹。
结语
K3s 用"单二进制 + 轻存储"换来了"标准 K8s 在小机器上也能跑",是自托管和边缘场景接近 Kubernetes 最轻的一条路。抓四件事就能用自己的节奏落地:单机一条命令起步,理解 Server 与 Agent 的分工,用 PV/PVC 和 local-path 把数据从 Pod 生命周期中剥出来,再配合 Ingress 自动证书、资源限配和备份把日常运维守住。同时记得它不等于"万能编排器"——服务少时 Compose 更顺手,规模上来再请 K3s 这位管家,它才是帮你把自托管栈从"一堆脚本"升级成"可统一声明与回滚的集群"的正确时机。