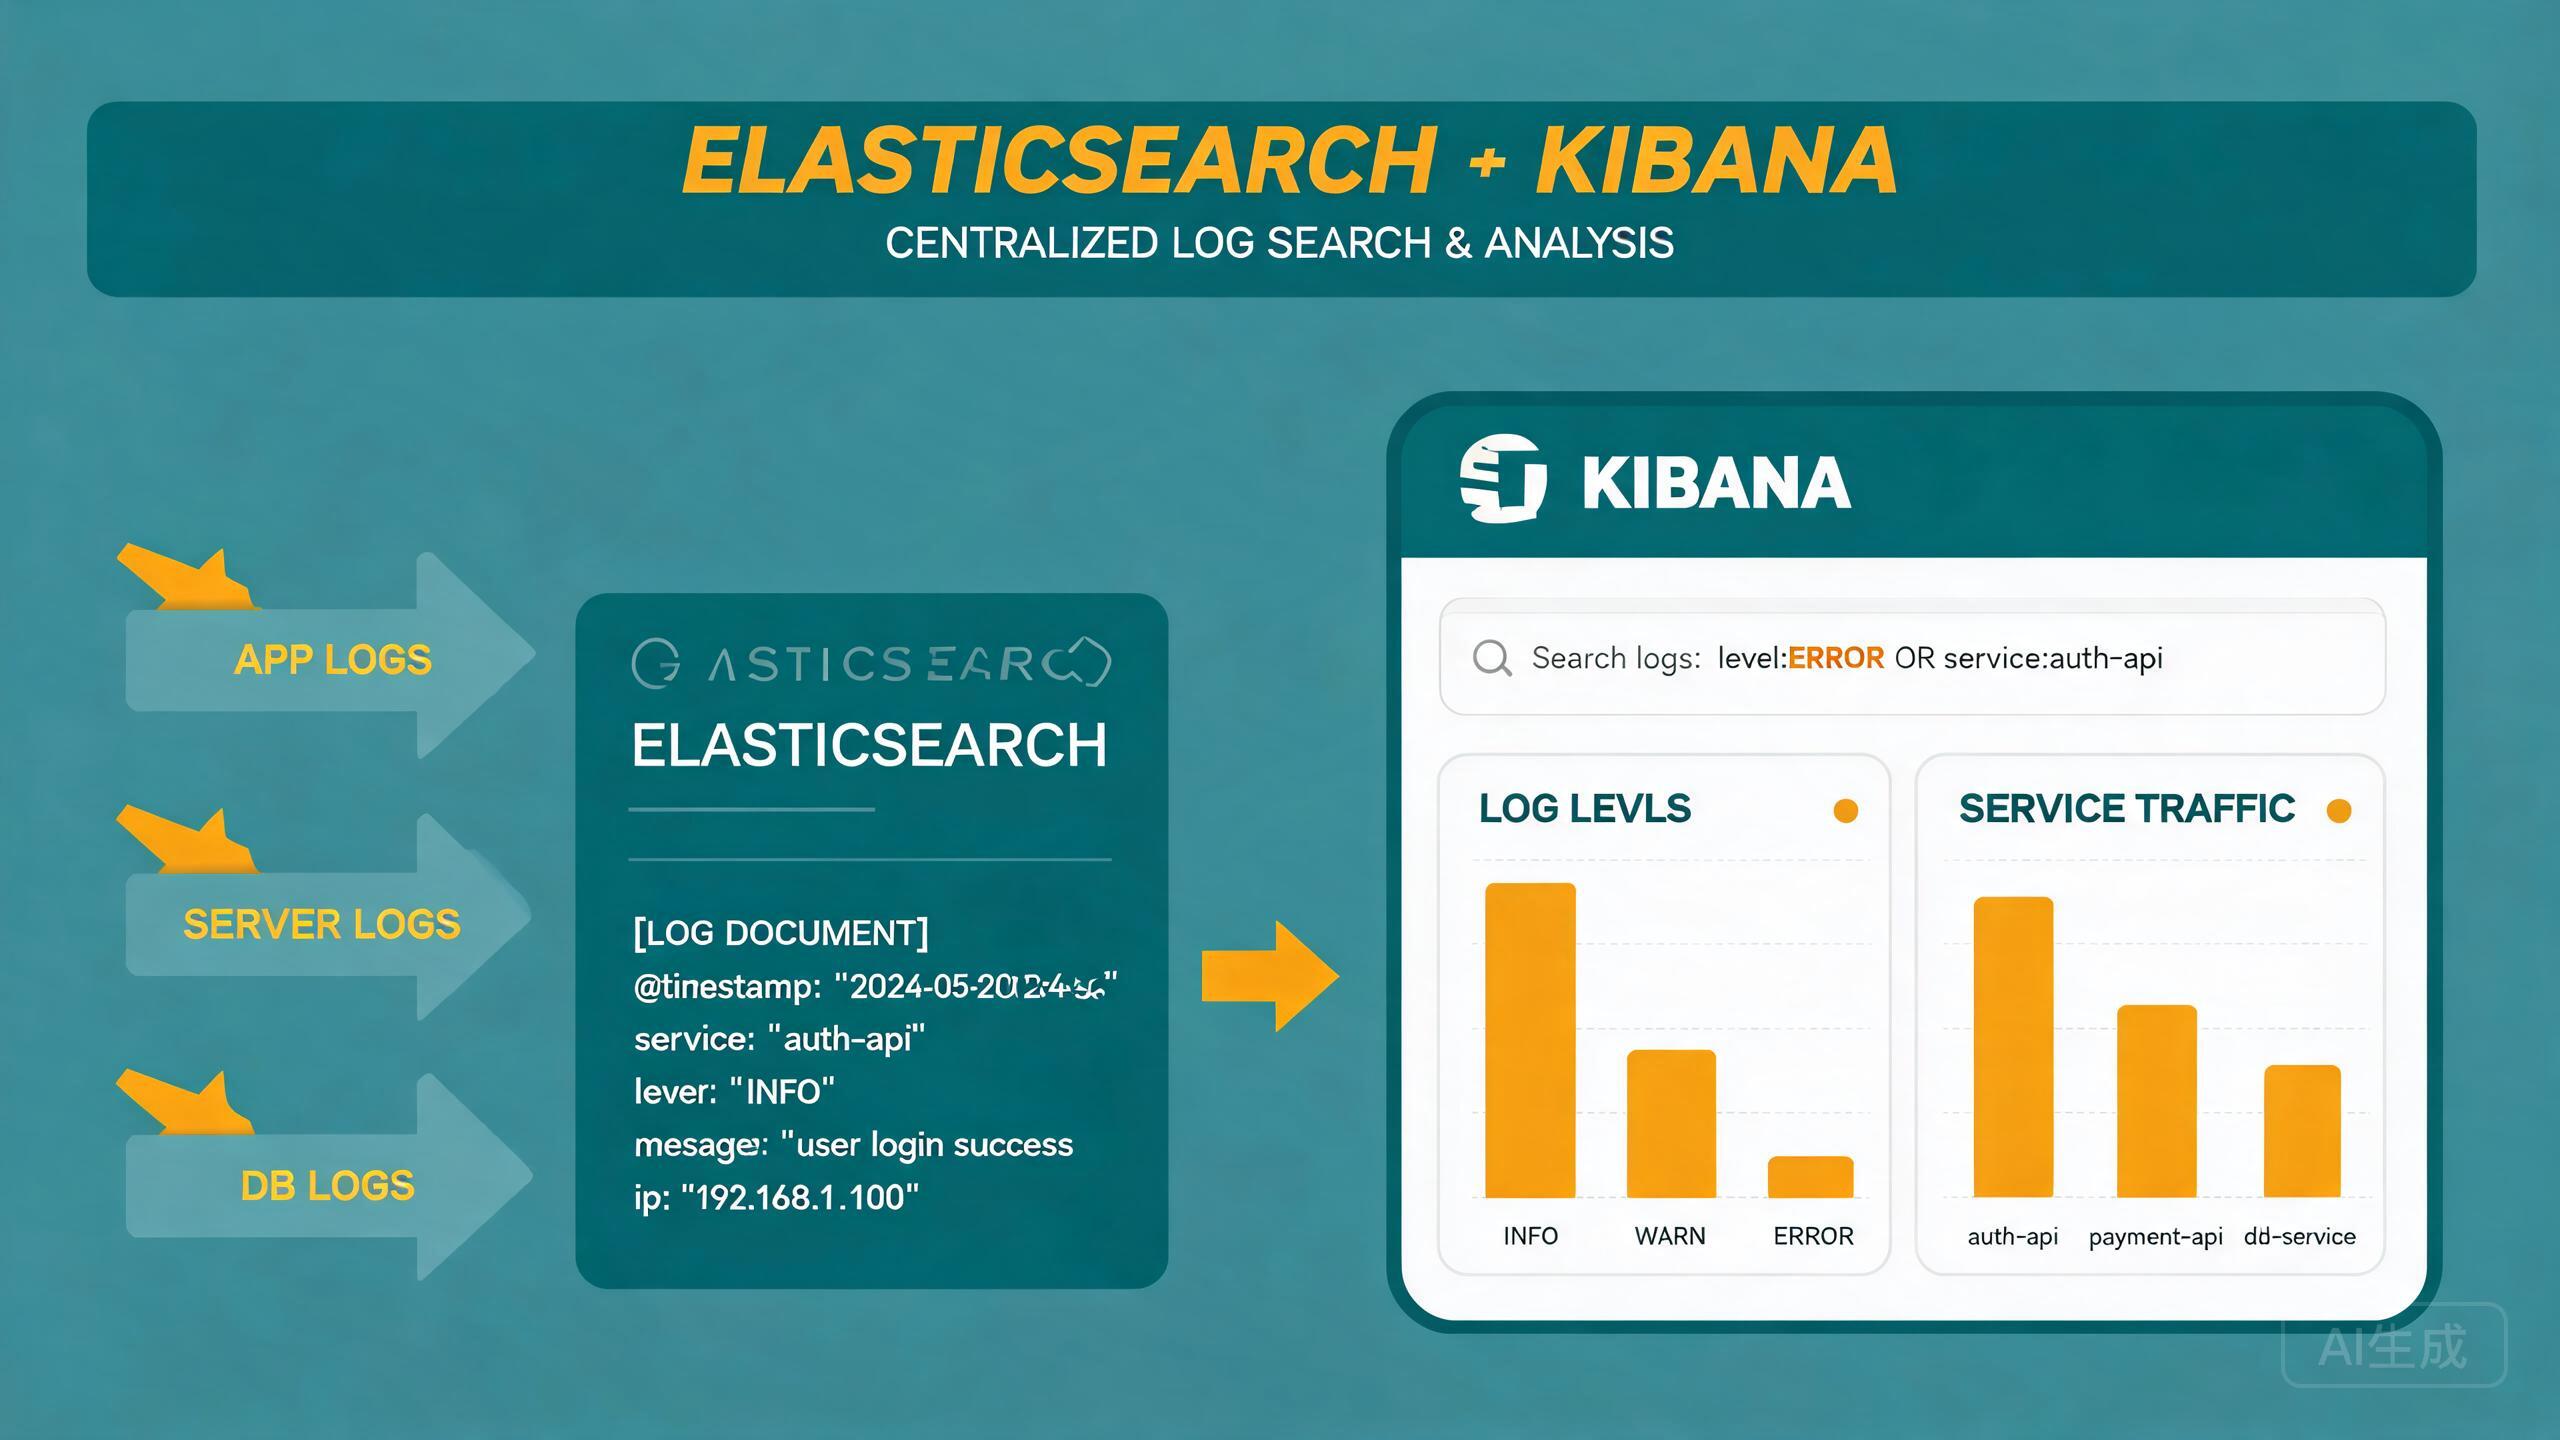
当你在自托管栈里堆的服务越来越多,会产生一个从来没被"关系型数据库 + 一张表"很好回答过的问题:如果你想按关键词快速搜遍所有文章的正文、想在一堆日志里找到"昨晚 2 点那个报错的完整上下文",传统数据库要么慢、要么笨。Elasticsearch 系(本文用其开源分支 OpenSearch)坐的地方正是这里:一个专为"近实时全文检索 + 海量日志与分析"设计的分布式搜索引擎。它和 MySQL 这类关系库不是替代关系,而是补上了"全文检索""聚合统计""海量写入吞吐"这几块短板。这篇讲清它怎么分片与复制、怎么建模索引、怎么接日志,以及一个自托管最容易踩的坑——内存和分片规划。
一、OpenSearch 和关系库分工:它擅长的三件事
很多人对"搜索"的理解是 SQL 里那句 `LIKE '%关键词%'`。但那条语句在小数据量凑合,数据多到几百万行、还要做"相关性排序、模糊、同义词、聚合统计"时就会彻底垮掉。OpenSearch 的底层是倒排索引(inverted index)——它把"文档"切词后,反过来建"每个词出现在哪些文档"的映射,让"按词查文档"变成一次精确定位而不是全表扫描。这决定了它的典型用途:一是全文检索,搜文章、搜商品、搜代码片段;二是日志分析,把海量日志灌进去,用查询与聚合把问题揪出来;三是聚合统计,按维度做计数、求均值、画趋势。
所以要分清工具分界:结构化的、需要强一致的事务数据仍然放 MySQL/PostgreSQL;而那些"只写不经常改、主要用来搜和统计"的数据(日志、文章正文、监控时序的索引),放 OpenSearch 就顺其自然。之前聊过 Loki 是做日志的轻量方案,OpenSearch 属于"更重、但检索与统计能力更强"的路线,选谁看你要不要复杂的词级检索和分析。
二、一个分布式搜索怎么"分布":分片与副本
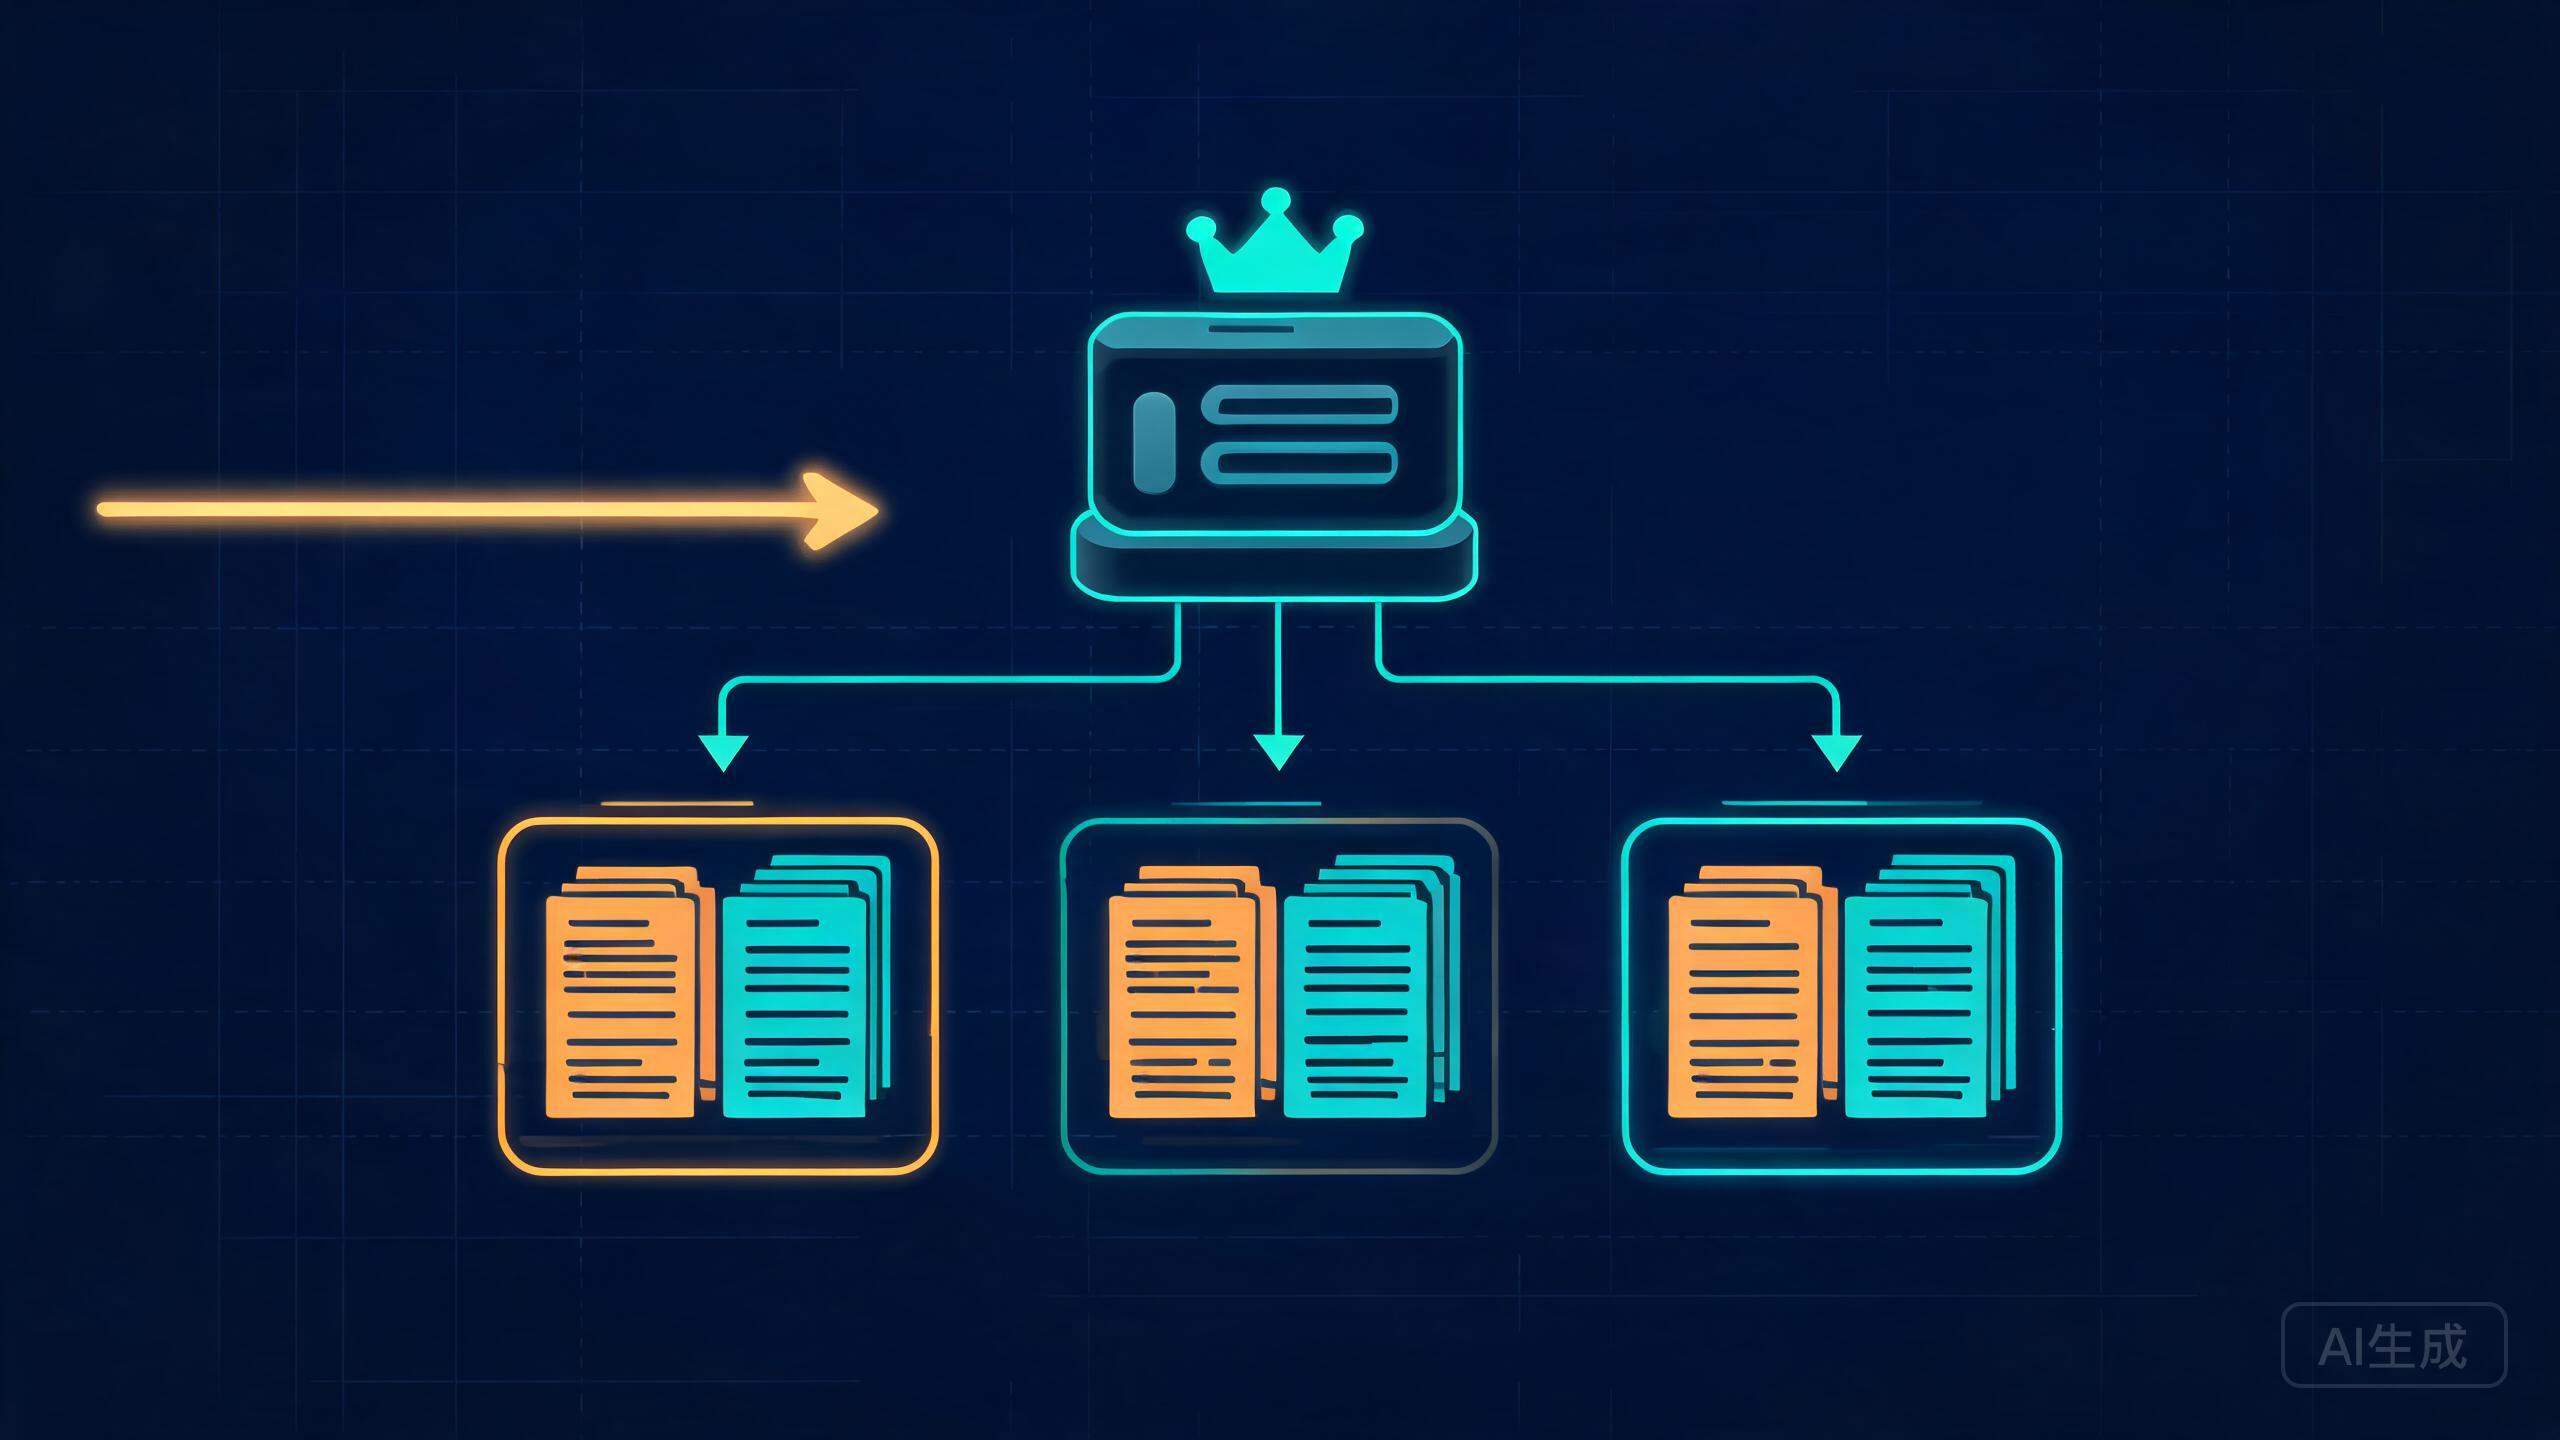
理解 OpenSearch 的性能首先要抓住两个概念。分片(shard)把一份索引的数据切碎后散到多个分片里,横向扩展、并行检索都要靠它;副本(replica)是每个分片的多份拷贝,既提供容错(某节点挂了数据不丢),又承担读流量分担。一个索引创建时就定好分片数(主分片数不可改,副本数随时可调)。
# 创建一个索引:3 个主分片、1 份副本,并定义字段类型映射
PUT /articles
{
  "settings": {
    "number_of_shards": 3,
    "number_of_replicas": 1
  },
  "mappings": {
    "properties": {
      "title":   { "type": "text" },
      "content": { "type": "text" },
      "author":  { "type": "keyword" },
      "views":   { "type": "integer" },
      "pub_date":{ "type": "date" }
    }
  }
}
这里 `text` 类型会被分词(适合做全文搜索),`keyword` 类型不分词(适合精确匹配、排序、聚合),日期单独立类型。这个选择直接决定你后面查起来顺不顺手——把"作者名"建成分词 text,那按作者精确匹配和聚合就会很别扭。映射是 OpenSearch 的"schema",提前想清楚字段语义,胜过后补。
三、把数据写进去并搜出来:索引与查询的基本功
写入用一个"文档(document)"即可,OpenSearch 会自动给它一个 _id,也可以显式指定(比如用文章本身的 id,避免重复写入)。查询则统一走 Query DSL 的 JSON。先给一套最小可用的读写示例:
# 写入一篇文档(指定 _id 以便幂等)
POST /articles/_doc/article-1001
{
  "title": "OpenSearch 实战入门",
  "content": "倒排索引让全文检索变成精确查找……",
  "author": "admin",
  "views": 120,
  "pub_date": "2026-09-01"
}

# 全文搜索:匹配 content 里包含"倒排"的文章,并按相关度排序
POST /articles/_search
{
  "query": { "match": { "content": "倒排" } }
}

# 聚合:按作者统计文章数(aggregation)
POST /articles/_search
{
  "size": 0,
  "aggs": {
    "by_author": { "terms": { "field": "author" } }
  }
}
三个查询分别代表三类能力:`match` 是做全文检索的核心,`terms` 聚合是按维度统计。会记住这三句就等于拿到了搜索和统计的最常用入口。`size: 0` 表示"我不要命中列表,只要聚合结果"——日志报表场景很常用。
四、把日志灌进去:Filebeat/管道与索引模板
OpenSearch 最常见的使用方式之一是把应用日志送进来做检索与告警。生态里有轻量的采集器(如 Filebeat/Logstash)负责读日志文件推送到 OpenSearch。为了不让索引名乱成一团,正式用法是"索引模板":预先定义"以后以 logs- 开头的索引长什么样、几个分片、什么映射",这样每天新产生的索引自动套用同一套规矩。
# 索引模板:所有 logs- 前缀的索引都按此设置创建
PUT /_index_template/logs_template
{
  "index_patterns": ["logs-*"],
  "template": {
    "settings": { "number_of_shards": 1, "number_of_replicas": 1 },
    "mappings": {
      "properties": {
        "@timestamp": { "type": "date" },
        "level":      { "type": "keyword" },
        "message":    { "type": "text" },
        "host":       { "type": "keyword" }
      }
    }
  }
}
一条日志经过采集后以"@timestamp + 字段"的文档进入以日期命名的索引(比如 logs-2026.09.01)。这样做的价值有两层:一是按天建索引,查询时间范围时只搜对应索引,速度快;二是"老旧索引可以直接删或归档",配合生命周期管理,Log 数据就不会无限膨胀吃光磁盘——这是自托管日志栈必须提前规划的一步。
五、自托管最容易踩的坑:内存、磁盘与"分片数永不改动"
OpenSearch 让很多自托管用户栽跟头的,95% 不是查询语法,而是资源与分片规划。第一是内存——它把 JVM 堆内存和文件系统缓存都要用,官方默认堆内存设为主机内存的一半左右;一台 2GB 的 VPS 硬跑带重负载的 OpenSearch 会 OOM,起步建议至少 3-4GB,并且给堆内存留上限避免吃掉全部系统内存。第二是分片规划——主分片数在建索引时就固定死,改不了,所以"以后数据会涨多少"要提前想,别一上来就 1 个分片然后塞爆;经验是单个分片数据量控制在几十 GB 以内,过多分片又会拖慢全局。
第三是磁盘生命周期——日志索引只增不减,不设保留策略会无限吃磁盘。务必配"按天索引 + 定期删除老索引/归档"(用镜像仓库或 lifecycle 策略)。第四是别裸奔——至少加上访问认证与最小权限:给 OpenSearch 建专门用户、限制索引范围,并给 Kibana/OpenSearch 前端加前面的反代认证那一层,别让日志管理界面暴露到公网。把这几点想清楚,OpenSearch 自托管的稳定性会比裸跑高很多。
六、与日志/指标方案的关系,以及何时该用
很多自托管栈里其实已经有一个"监控与日志"的组合:Prometheus 管实时指标、Grafana 画面板,Loki 做轻量日志。OpenSearch 在这里的选择依据是:当你的日志里需要真正复杂的全文检索、需要同义词/模糊/高亮、需要做深度聚合分析,Loki 的"按标签查询"够不着,这时 OpenSearch 才是答案。它和 Prometheus 不是竞争(前者管日志检索,后者管时序指标),而是各自的交付物。
落到自托管,我的建议是:日志量小、只需要"按时间翻错"用 Loki 就够了;一旦你要"在日志里全文搜某个错误特征的完整上下文""按多个维度统计请求分布",或者文章类数据要全文检索,再上 OpenSearch——它是这类"检索与分析"需求的重量级正统解法,但也需要你用分片、内存、生命周期三件套把它管好,而不是装完就当杂货铺用。
结语
OpenSearch 补上的,是关系型数据库在"全文检索与海量分析"上的短板:靠倒排索引把搜索变成精确查找,靠分片/副本做到横向扩展与容错。使用要点可以归成四条:明确它管"检索与统计"、关系库管"事务数据",映射想清楚 text 与 keyword;写入用文档、查询用 match 与 terms 聚合;日志用索引模板 + 按天索引并配生命周期;资源上盯紧堆内存、分片数和老的索引保留。把这些立住了,OpenSearch 就会从"一个容易吃内存的大玩具"变成你自托管栈里真正能扛全文检索与日志洞察的可靠一环。