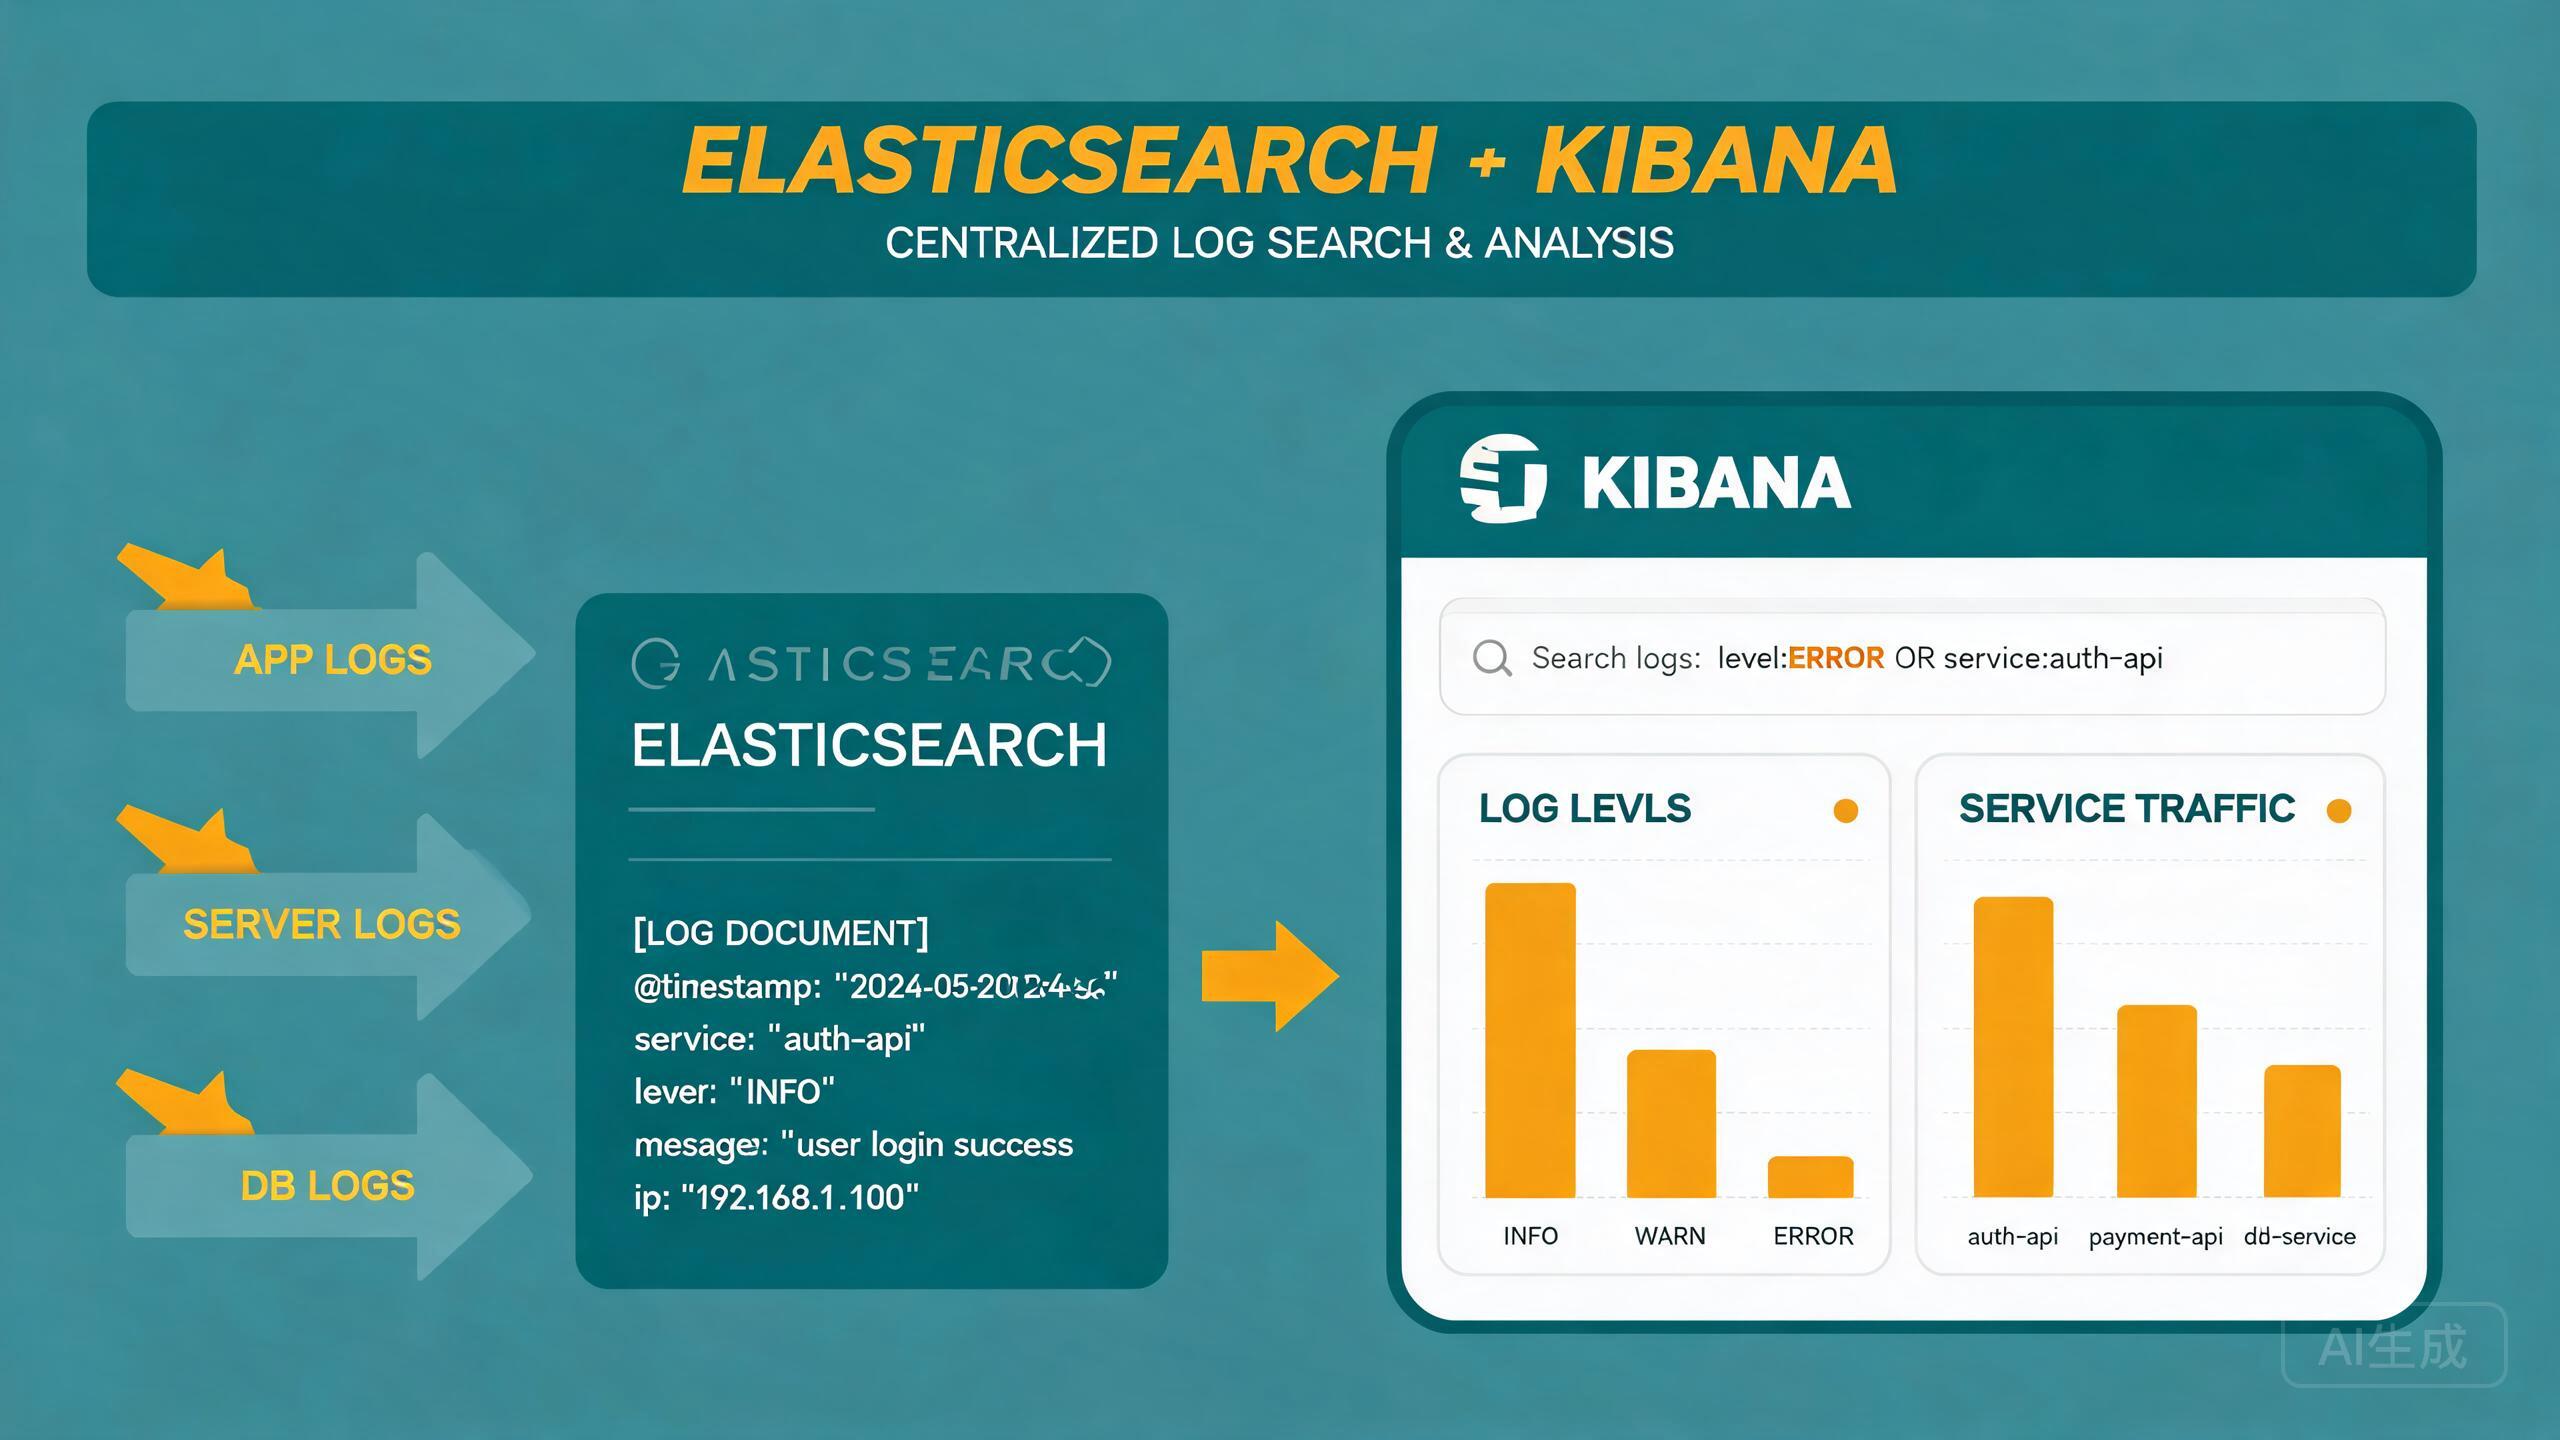
自托管的日志/全文检索走到"一台收不住、或想横向扩、或想换机搬家"时,Elasticsearch(ES)是大多数人的第一选择,但它的"该扩多大、怎么安全下线升级、怎么迁移数据"坑最多。ES 是以"文档 + 倒排索引 + 近实时"为核心的分布式搜索/分析引擎,和"按日志攒数据"(上文的 ClickHouse/Elasticsearch 血缘)以及"面向交互检索"结合得很紧。这篇讲清 ES 解决什么、集群三件核心概念(node/索引分片/副本)、扩容/下线/升级的流程怎么走、数据迁移怎么做,以及值得一投的常见坑与边界。
一、Elasticsearch 解决什么:把"全文搜索与近实时分析"做得既快又横向可扩
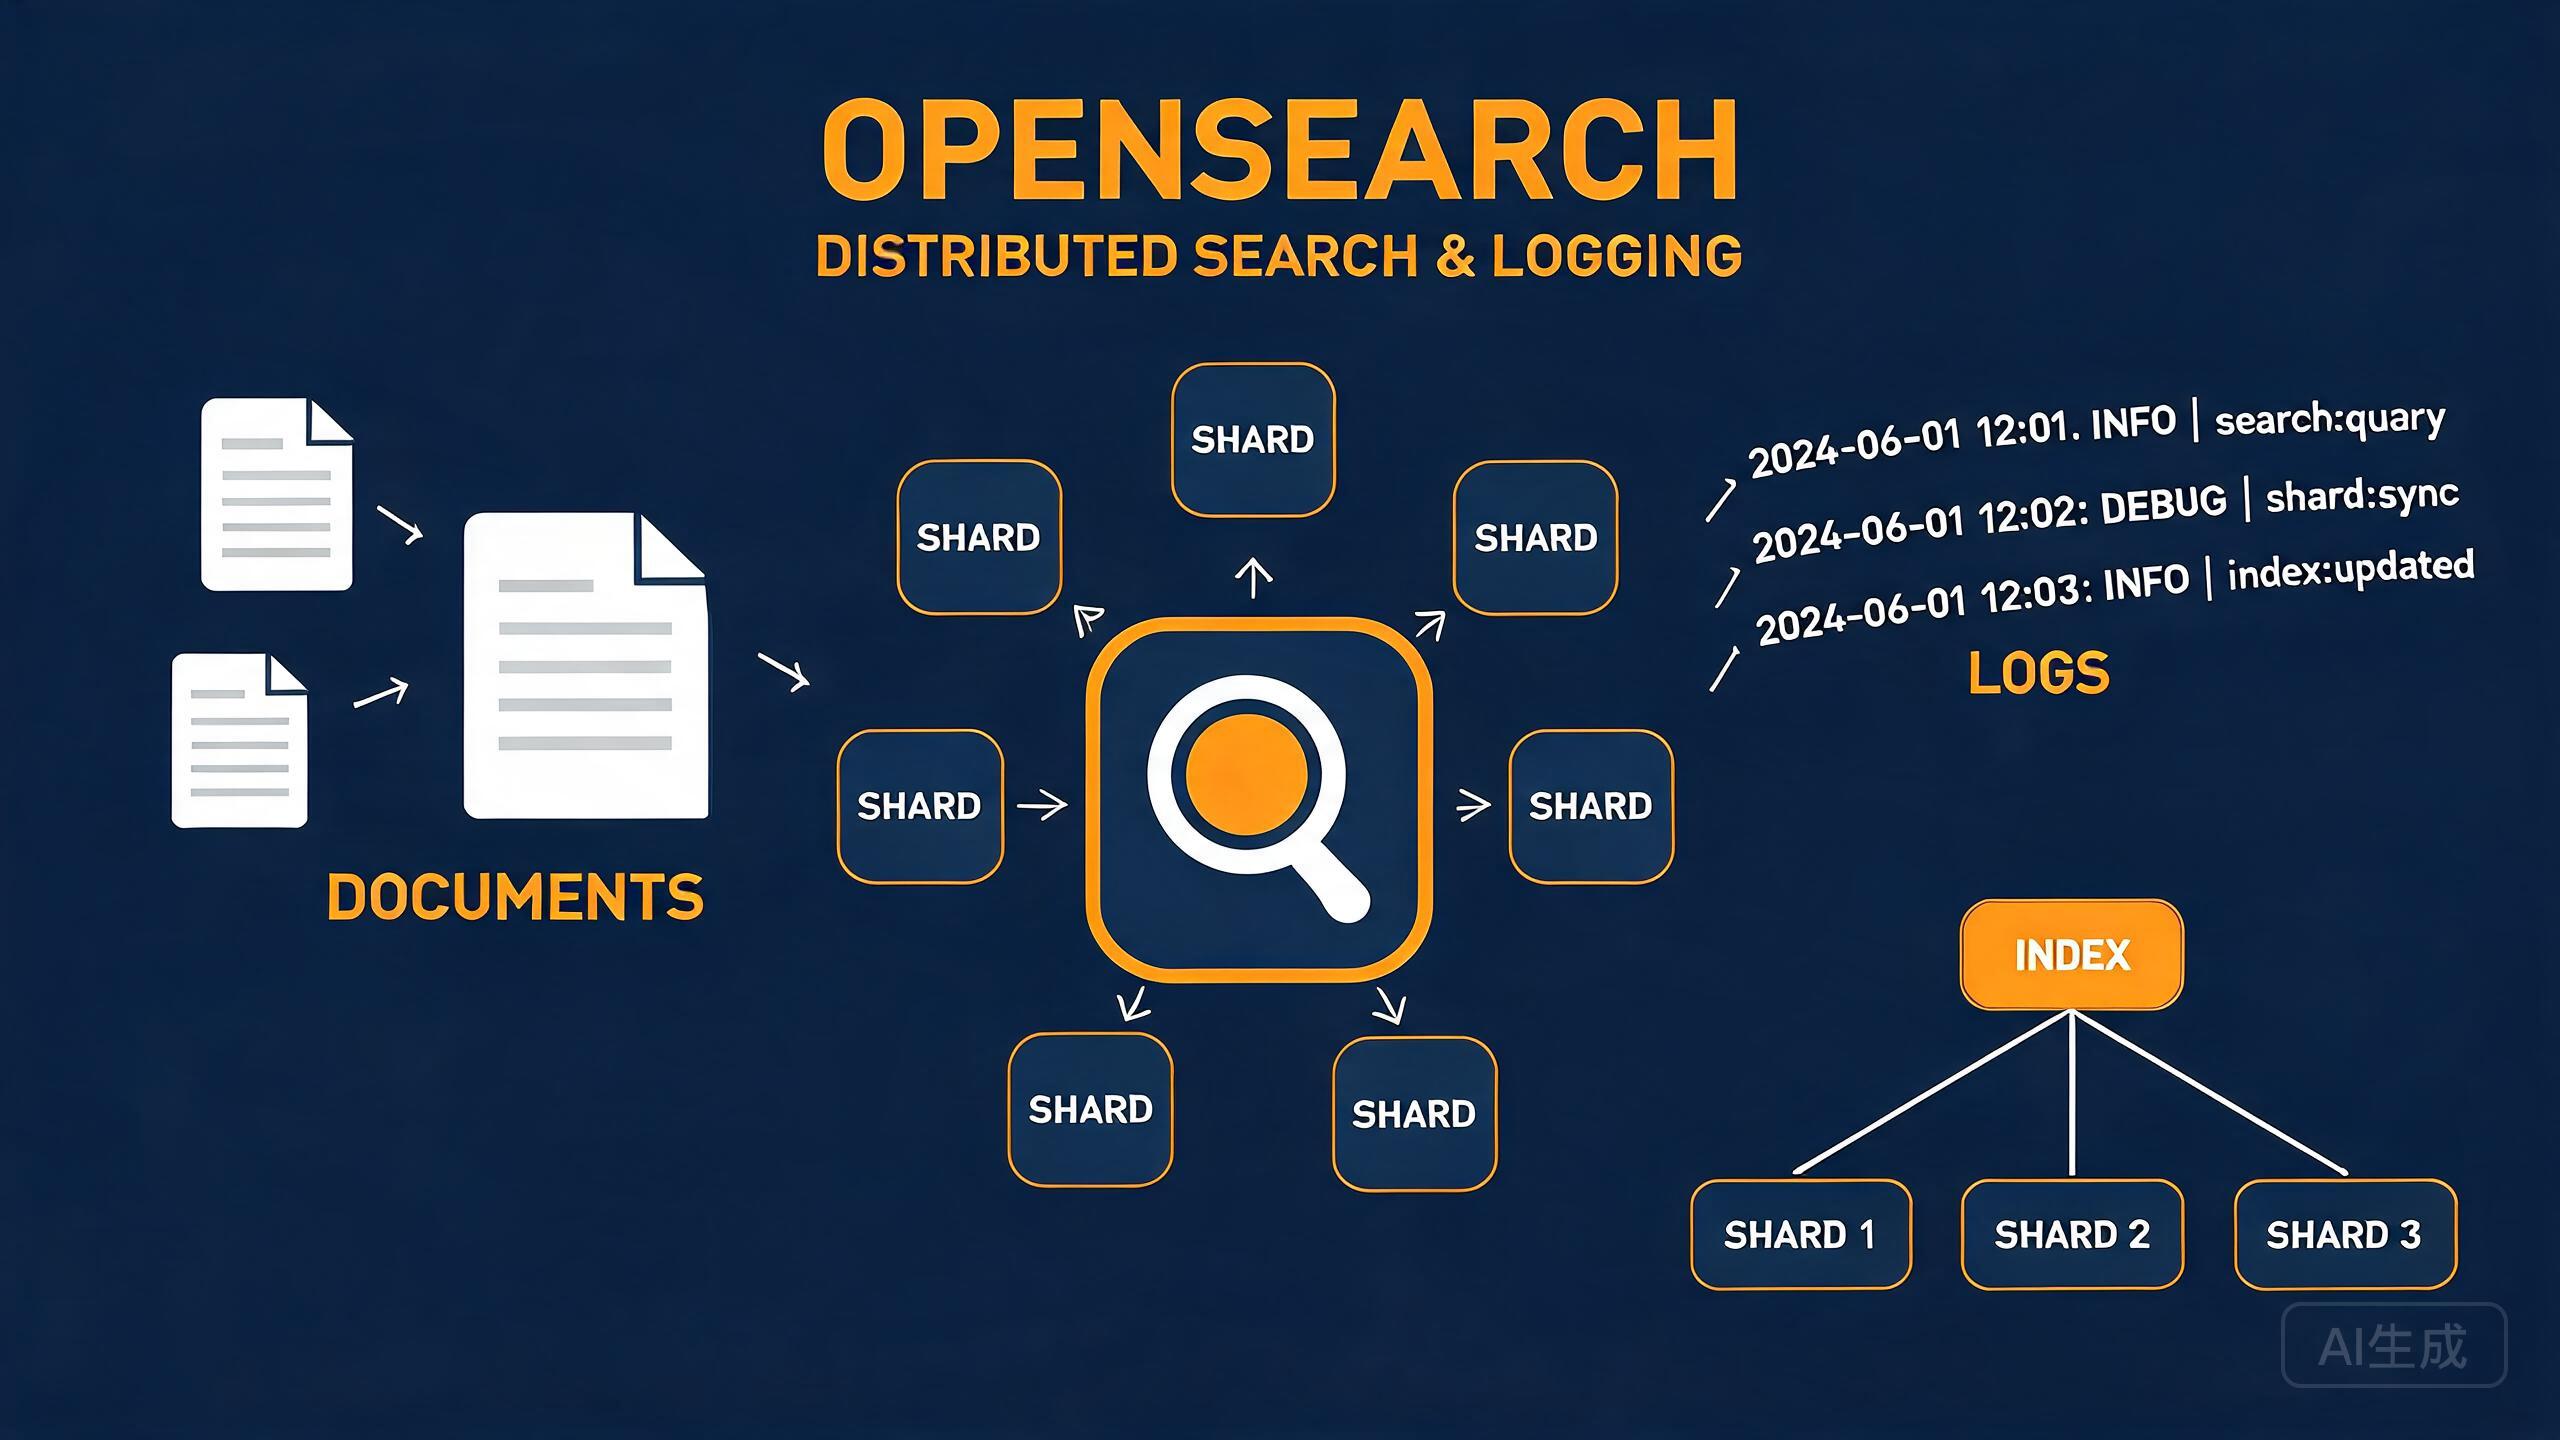
ES 的强项是"海量文本/日志的全文检索 + 聚合":它把每条文档拆成 token 建倒排索引,查"某关键词出现在哪些日志/文档"毫秒级返回,还能做聚合统计。设计上它按"索引(可类比表/库,含 mapping 定义字段类型)+ 分片(shard,把索引切成若干片分布到多节点,是并行与可扩展单元)+ 副本(replica,每分片的冗余副本,提供高可用与读吞吐)"组织。数据量大时索引会被自动/手动分成多个 shard 摊到节点,某节点挂了副本顶上。理解 ES 先抓三样:索引=逻辑上的一类文档,分片=横向拆分的并行单元,副本=防丢与高可用的冗余。它"近实时"(写入后秒级可见)、"落地磁盘"(不像纯内存缓存),适合做日志检索、搜索引擎、业务数据全文检索。
二、集群怎么扩/怎么安全下线:先看分片与节点角色
集群由若干"节点"组成,各节点可承担不同角色(master 候选、data、ingest)。扩容量常见就是"加 data 节点",但加之前先看分片:一个索引的分片数决定它能被多平方地摊到多少节点(分片数太少,加节点也不提升并行)。安全下线一个节点(维护/换机)不要直接 kill——要先把它在的数据"搬走"再停,否则副本不足影响集群状态。正确做法:从候选里摘掉目标节点、把它的分片 reroute 到其它可用节点、等集群转 green 再停。
# 看集群健康(green=全绿其余/RED=有主分片不可用,第一时间看)
curl -s localhost:9200/_cluster/health?pretty

# 查索引分片分布,判断是否摊得开 / 某节点扛了多少
curl -s localhost:9200/_cat/shards?v
curl -s localhost:9200/_cat/nodes?v

# 让某个 data 节点退出前先把分片排出去(示例 node name=node-3)
curl -s -XPUT localhost:9200/_cluster/settings -H 'Content-Type: application/json' \\
  -d '{ "transient": { "cluster.routing.allocation.exclude._name": "node-3" } }'
# 等上面 rebalance 完成后(转 green)再停该节点,而不是直接 kill
这一段的坑集中在:分片数/副本数规划失当(分片过多则元数据与段管理开销大、过少则扩展性差);直接 kill 导致 RED/RED 状态(主分片缺副本触发恢复风暴);把"视图健康"误当成"能长期跑"——要同时盯磁盘水位与堆内存。加节点/下线前先 `/_cluster/health` 与 `_cat/shards` 看清再动。
三、升级与数据迁移:分片 reroute 与 reindex 两条路
ES 升级与跨集群迁移常要动"索引数据",两条主要路径:一是"集群内/跨节点搬运分片"(上面 reroute,适合加/换节点、不改 mapping 的平移);二是"重建索引(reindex)"——把旧索引按新 mapping 复制成新索引(适合改字段类型、合并索引、跨集群迁移),reindex 本质是把旧索引按目标配置重写一遍再切换别名,是最稳妥的数据整形手段。跨集群迁移(换新集群)常见用"快照/恢复(snapshot & restore)"或 reindex-from-remote。升级顺序要先读官方升级路径,别连跳大版本。
# 重建索引:把 logs_v1 以新版 mapping 重建到 logs_v2(途中可用 alias 无感切换)
# 先建一个新的空索引并设好 mapping/分片,然后:
curl -s -XPOST localhost:9200/_reindex -H 'Content-Type: application/json' \\
  -d '{ "source": { "index": "logs_v1" }, "dest": { "index": "logs_v2" } }'
# 基建好后切别名,客户端一直用别名(读旧写新,完成后切回)
curl -s -XPOST localhost:9200/_aliases -H 'Content-Type: application/json' \\
  -d '{ "actions": [ { "add": { "index": "logs_v2", "alias": "logs" } },
       { "remove": { "index": "logs_v1", "alias": "logs" } } ] }'
迁移的坑:reindex 前没把新索引的 mapping/分片/副本设对,重建成"照旧错";reindex 全程没切换 alias,客户端看到新数据不完整;升级跳大版本造成不兼容。迁移后务必做一段验证(对比条数、抽查检索与聚合),再删除旧索引。
四、边界与结论:它是"近实时检索与分析",要管好吃内存与磁盘
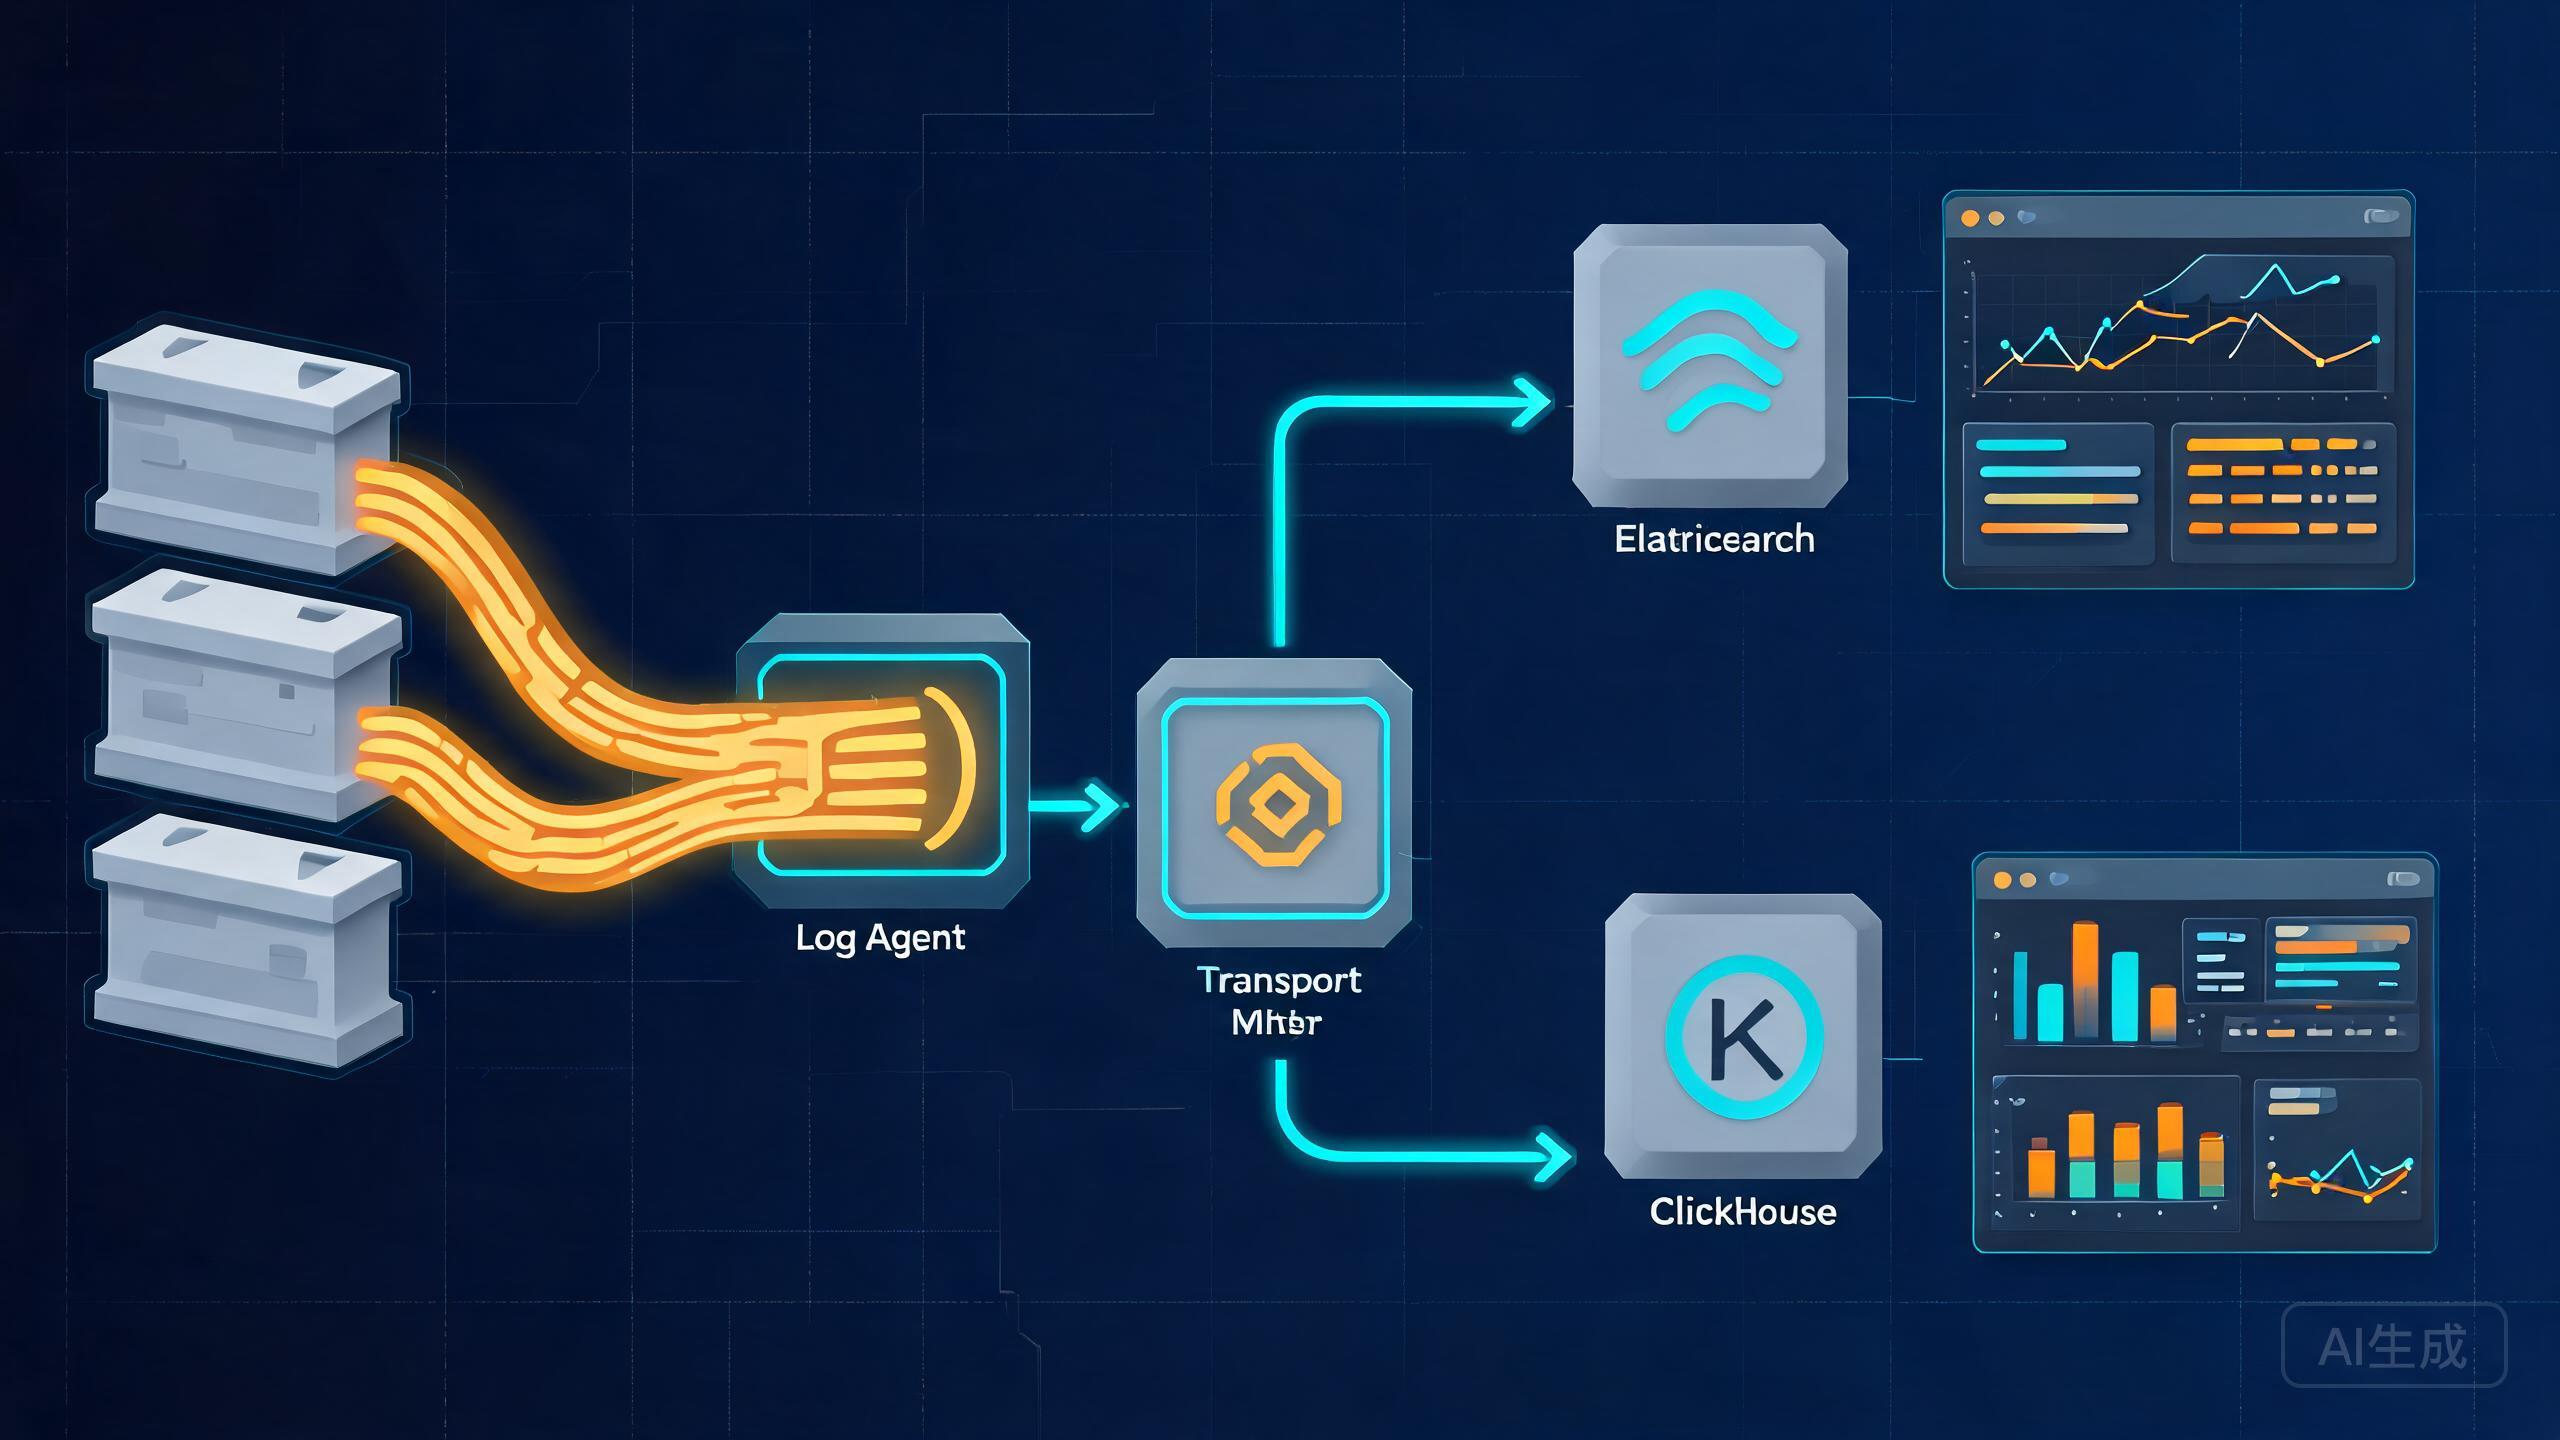
ES 的边界:它是"近实时",写后秒级才可见,不等同于强一致事务库;它把索引的段结构放内存/H 堆外,堆内存与磁盘水位直接影响可用性,shard 数、字段类型(尤其把随意多值高基数都开了"searchable")都会撑内存。它的强项是全文检索与聚合、日志/文档检索,弱项是超高频单行写、复杂 join、事务性。自托管里它和日志链路(如 filebeat + ES)、监控聚合常配套。把它当"近实时检索与分析引擎",配好分片/副本/水位/快照,自托管的日志与全文检索才既快又不会"一满就挂"。下手前先把"扩容要动分片、下线先 reroute、迁移健康走快照/reindex"这套流程顺熟,是长期稳稳收拾它的一线经验。