自托管服务多了以后,会出现一个"要有却总被拖到最后"的需求:日志去哪看。出问题时,是翻一个个容器的 `docker logs`、一个个服务的 `/var/log`,还是统一到一个能全文搜索、按时间范围过滤、一眼看清报错与关联的地方?当日志散落各处、量又大时,前面的做法都不够好。Elasticsearch + Kibana(常与 Logstash 串成 ELK 栈)正是解决"集中收集、全文检索、可视化分析日志"的经典组合:Elasticsearch 做存储与搜索,Kibana 做界面与探索,Logstash/Fluentd 负责把分散日志收进来。这篇讲清它解决什么、最小怎么起一栈、怎么做字段化解析与检索,以及它的资源与运维现实边界。
一、分散日志的痛点:要的不是"能看",而是"能搜、能过滤、能关联"
当服务只有一两个时,命令行 `journalctl`、`docker logs`、`tail -f` 就够用了。但当你有十几个容器、多个应用、且出问题时你想"在这时间窗口针对这个字段搜所有报错"时,分别翻各自的日志既慢又没法统一过滤。集中式日志(centralized logging)把各处的日志统一收进一个可全文搜索的仓库,把"一行行翻"变成"写个查询就能筛",是量上去后的必然升级。
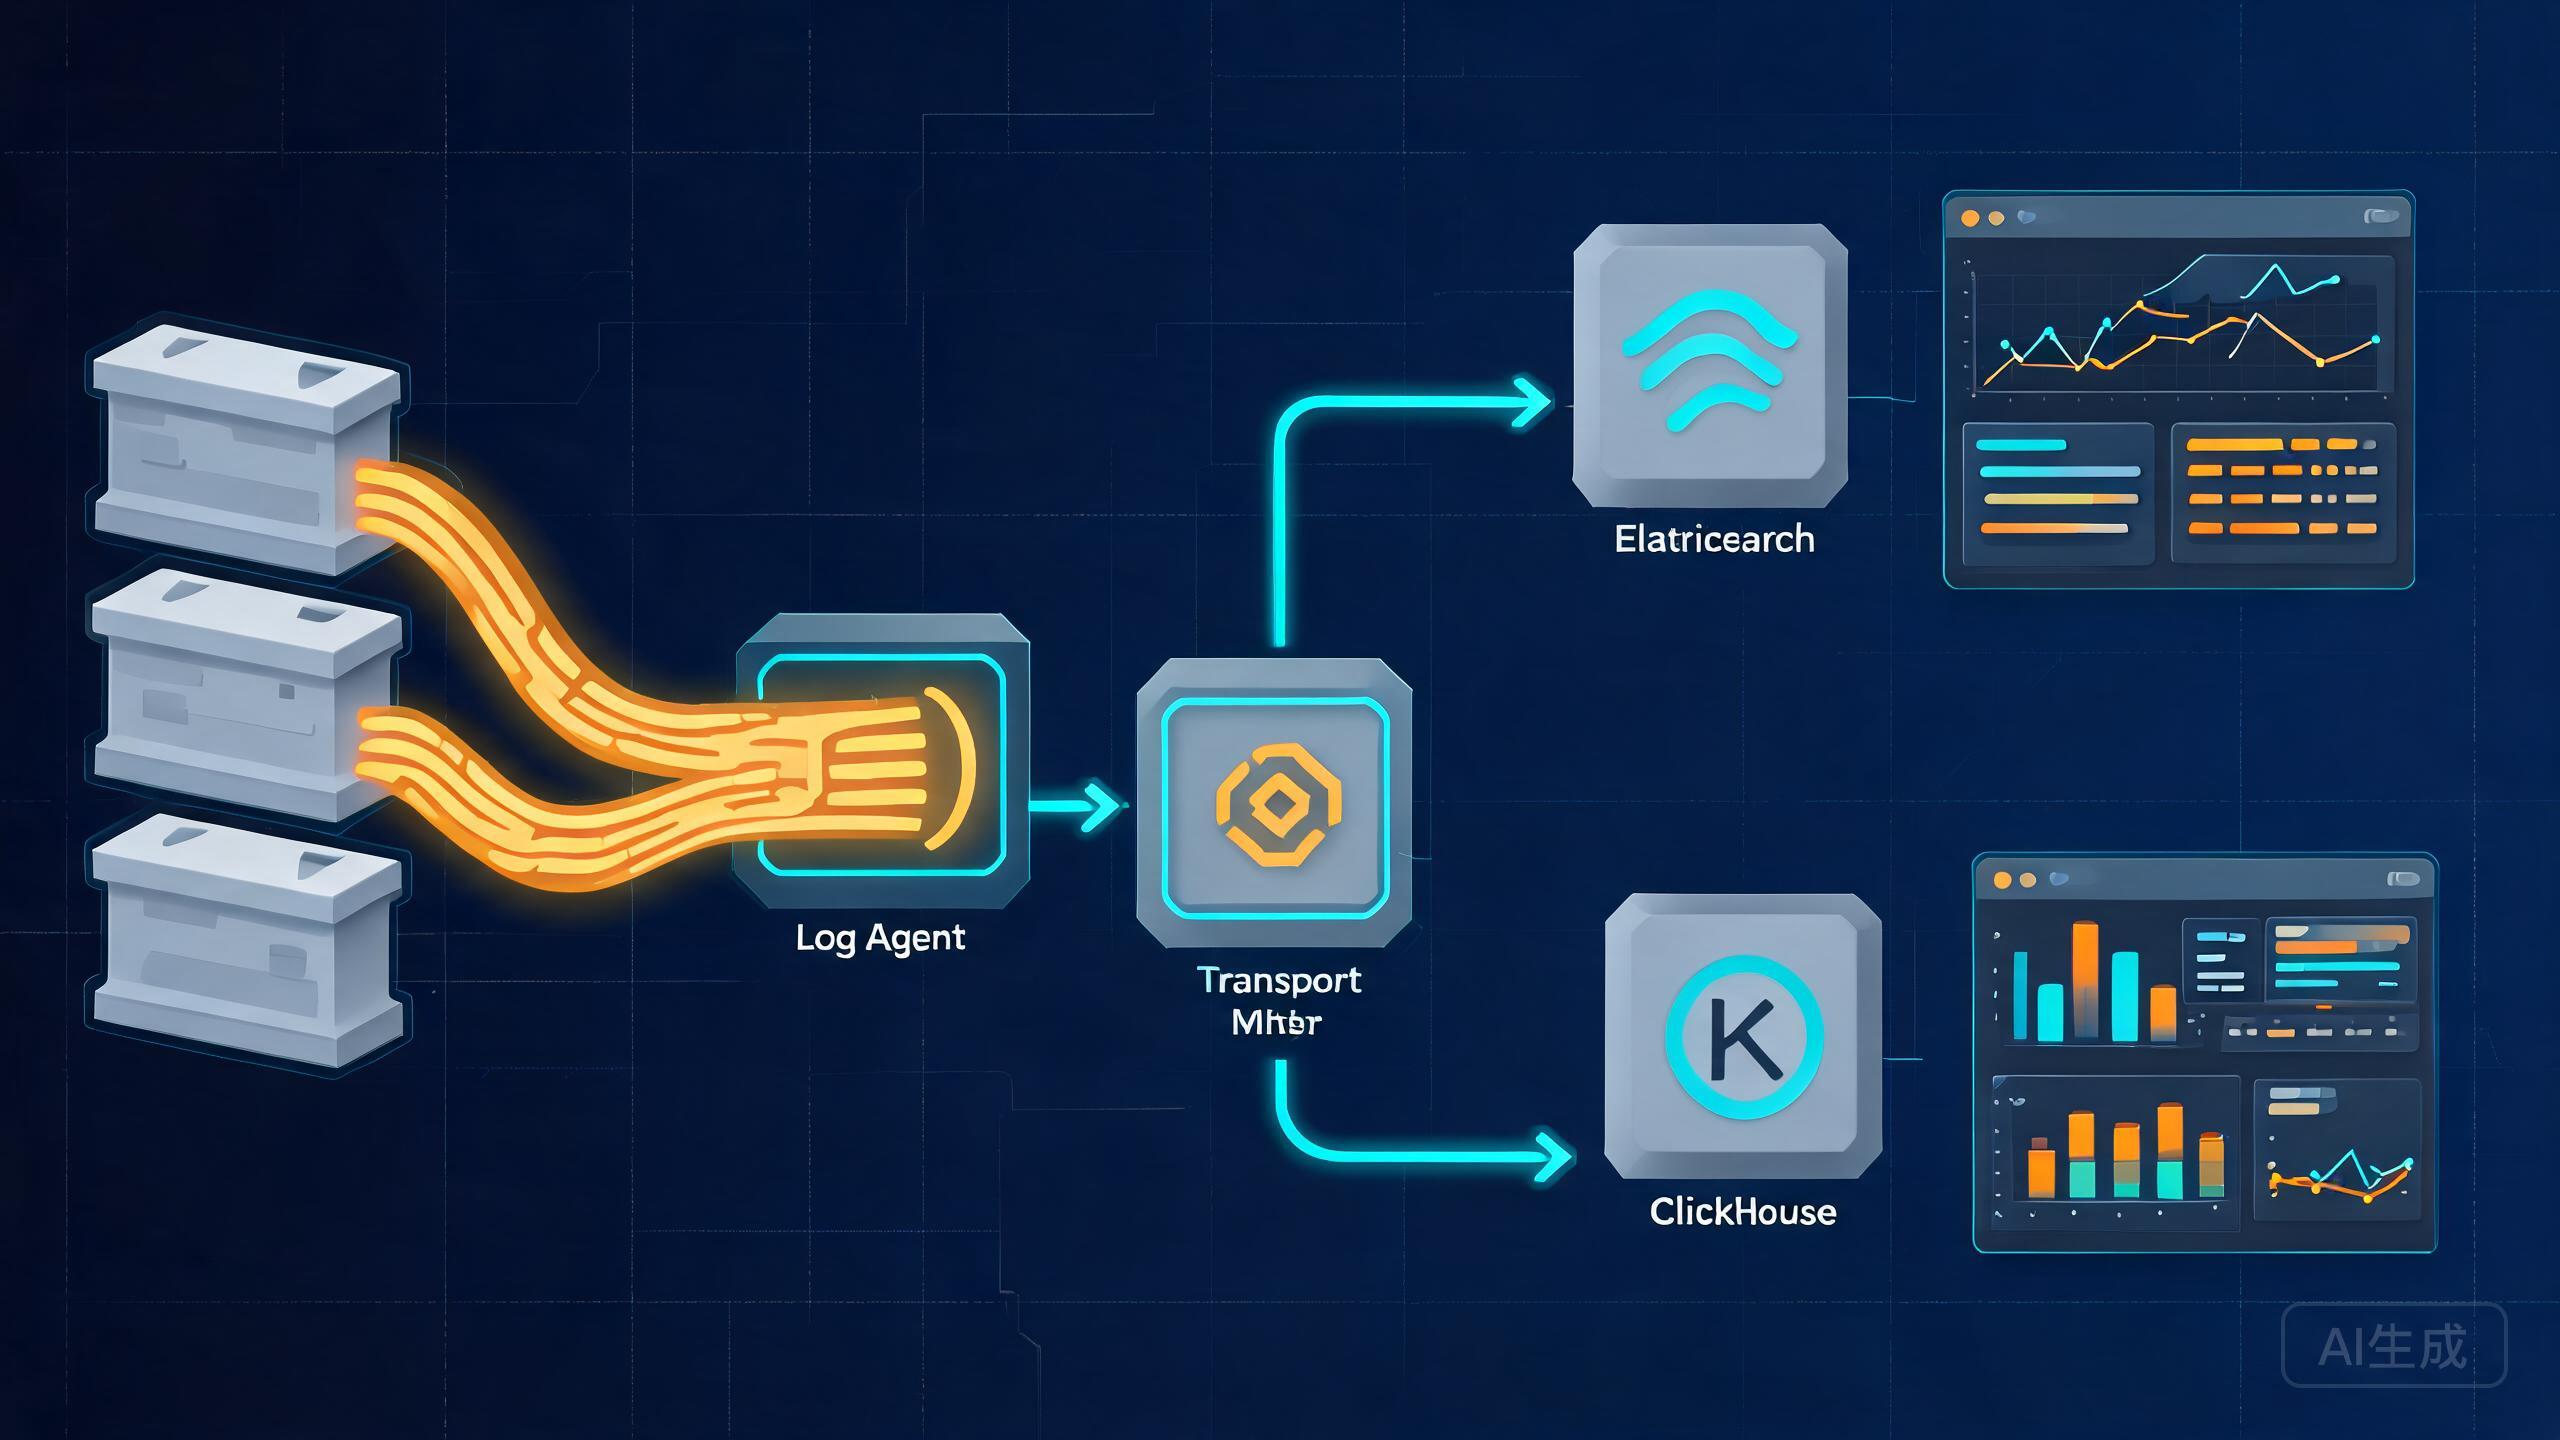
ELK 是这个领域的经典三件套:Elasticsearch 存日志并提供全文检索与聚合;Kibana 是可视化与探索界面;Logstash(或更轻的 Filebeat/Fluentd)负责把日志从各来源采集、解析、投递。前一篇用 Loki 侧重"轻量 + 与 Grafana 集成";而 Elasticsearch 的定位是"更强大的全文检索与分析能力",适合你需要复杂查询、复杂聚合、或者客户端带成熟的 Kibana 探索体验的场景。两者的选择要看你对检索能力与资源投入的权衡。
二、最小落地:起 ES + Kibana,让日志先"能进来看"
最省的起步是只起 Elasticsearch + Kibana(暂不接 Logstash/Filebeat),先让"界面能打开、能建索引"跑通,再逐步加采集。给一个 docker-compose 的最小示意:
# docker-compose.yml(示意:单节点 ES + Kibana)
services:
  es:
    image: docker.elastic.co/elasticsearch/elasticsearch:8.14.2
    environment:
      - discovery.type=single-node      # 单节点足够入门
      - xpack.security.enabled=false    # 入门先关安全,正式务必启用
      - "ES_JAVA_OPTS=-Xms1g -Xmx1g"    # 给 ES 明确 JVM 堆
    ports: [ "9200:9200" ]
    volumes: [ "./esdata:/usr/share/elasticsearch/data" ]
  kibana:
    image: docker.elastic.co/kibana/kibana:8.14.2
    ports: [ "5601:5601" ]
    environment: { ELASTICSEARCH_HOSTS: "http://es:9200" }
    depends_on: [ es ]
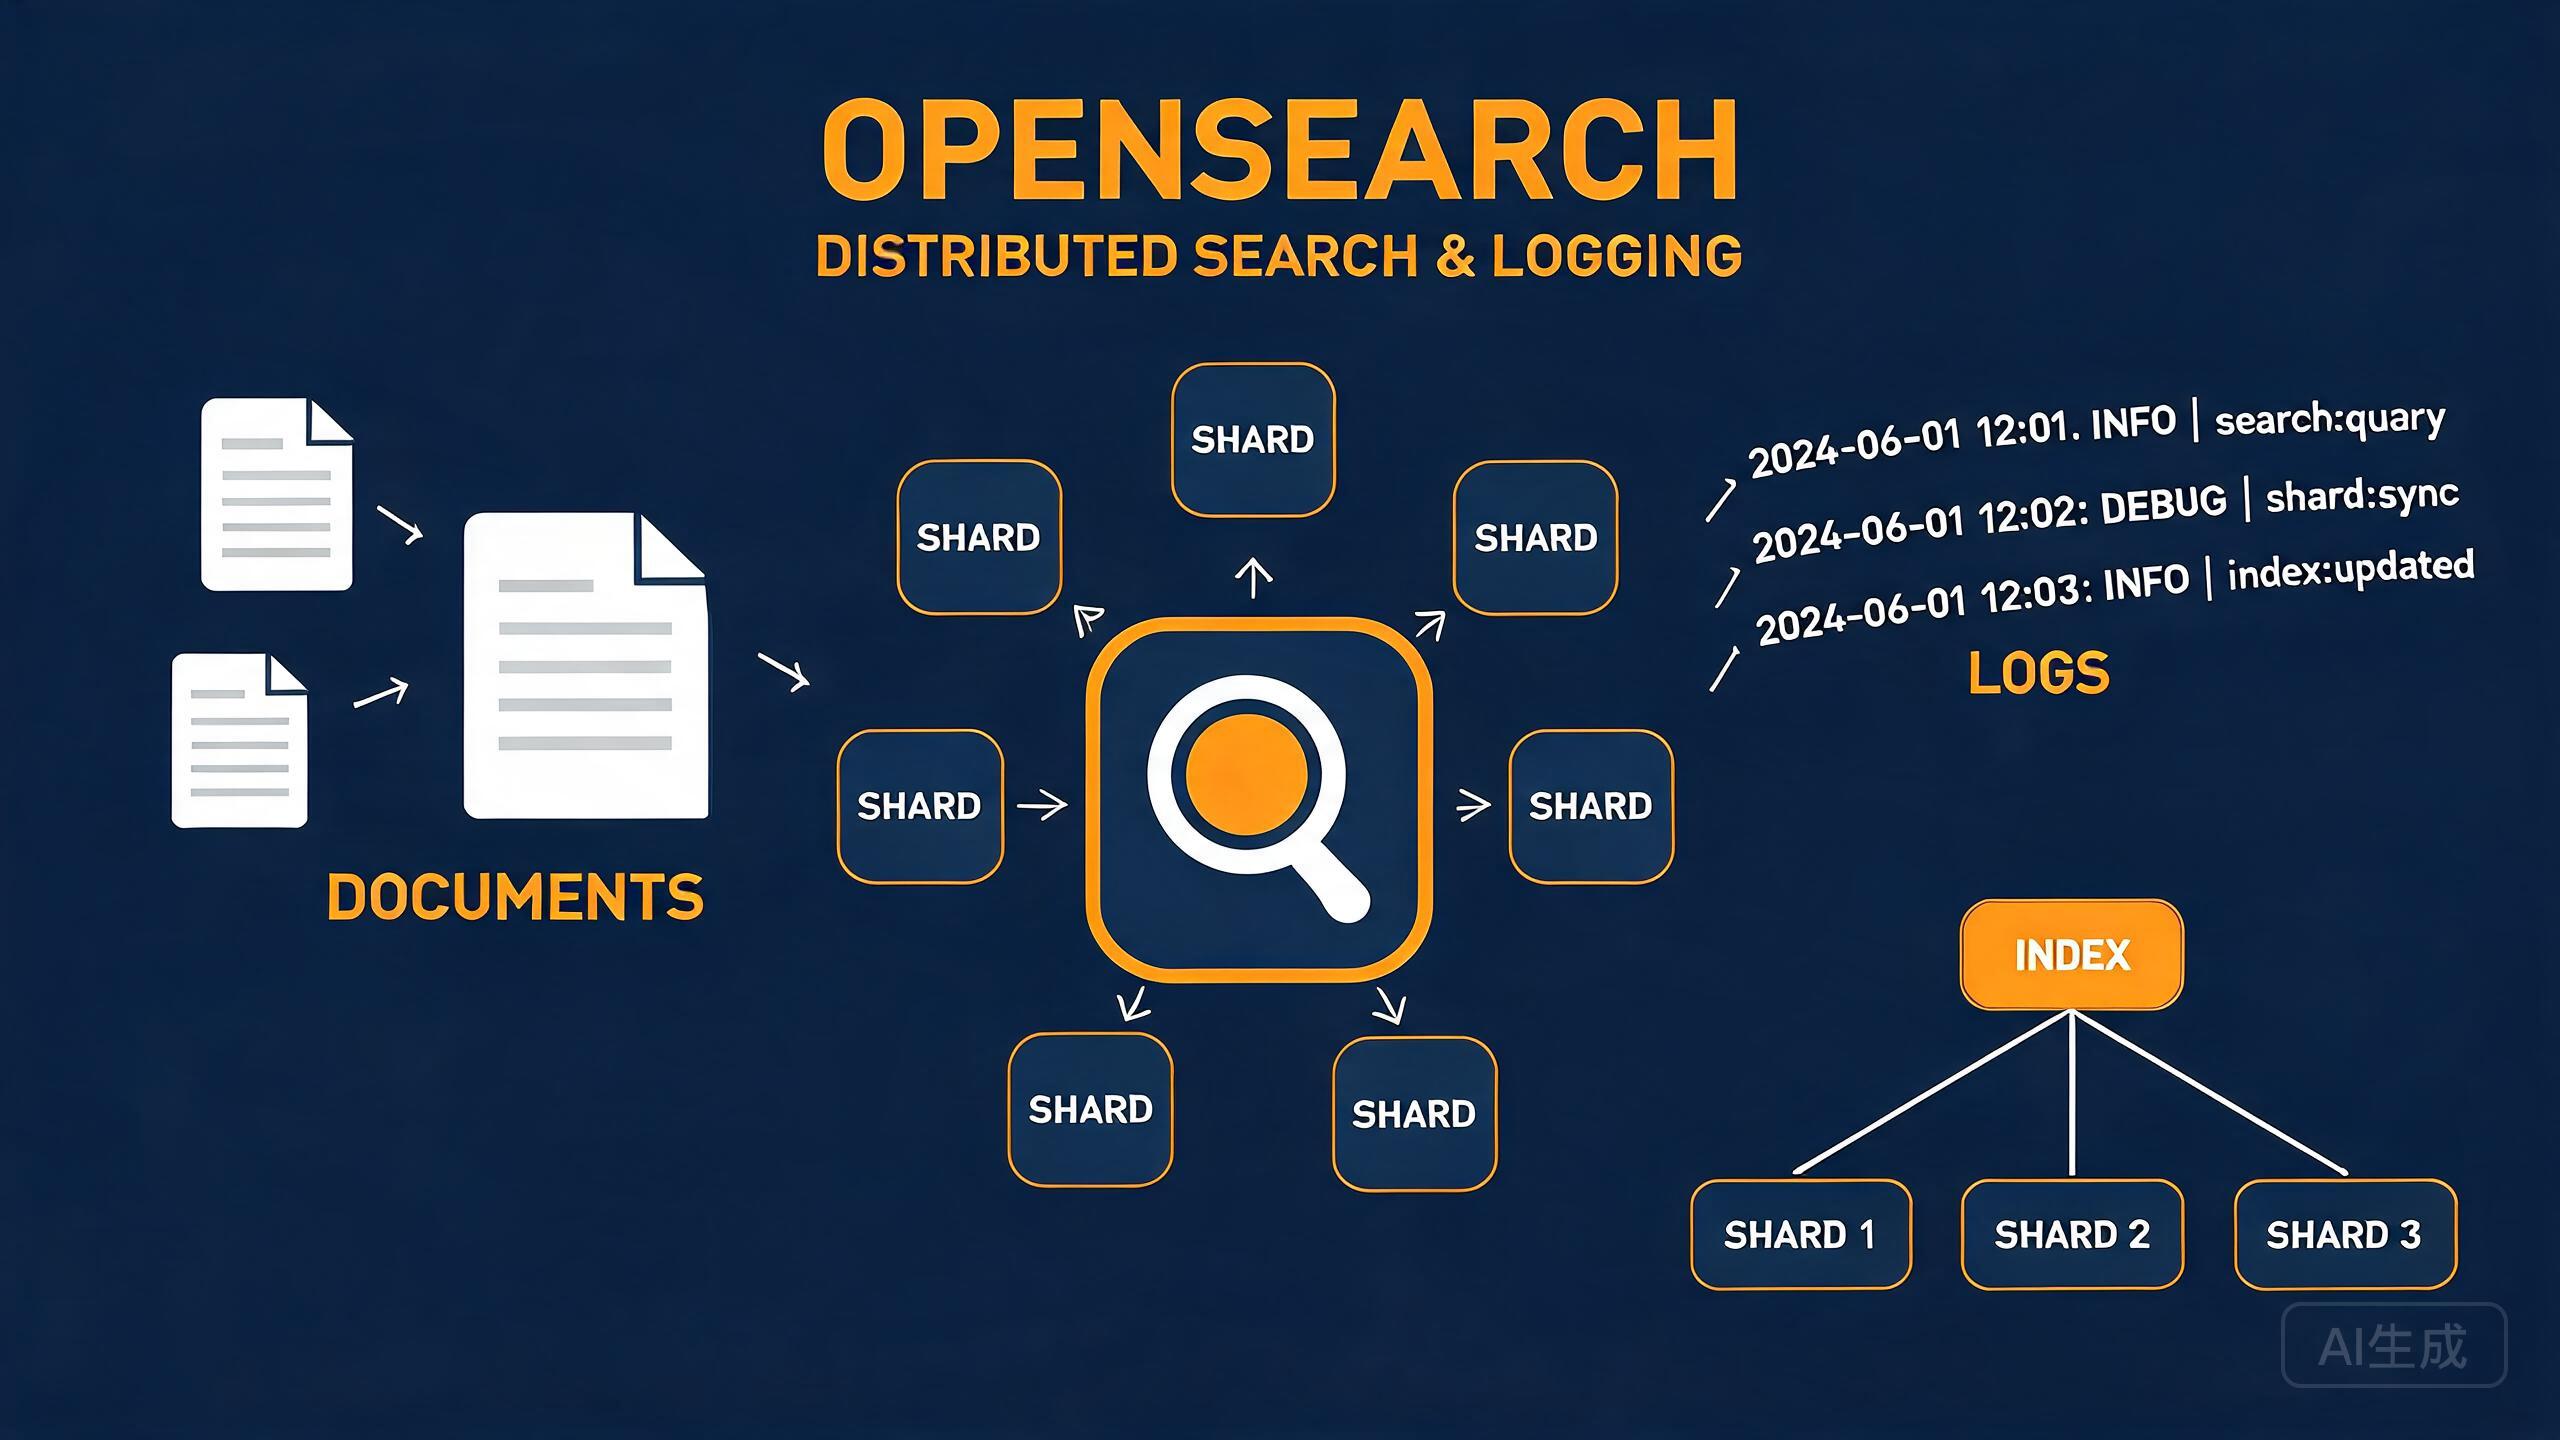
上手时认清 ES 的"底子"很重要:它是基于倒排索引 + 日志的搜索/分析引擎,数据先被解析成结构化字段(如 `@timestamp`、`level`、`message`),你才能按字段过滤与聚合——这一点和前面聊过的 OpenSearch 是同一家族。先把"索引、文档、字段"这几个概念对应起来(一条日志 = 一个文档,一类日志组织成一个索引),再用 Kibana 的 Discover 跑通"查全部 / 按字段筛 / 按时间窗拉",你对这套栈的掌握就上了道。
三、字段化解析与检索:把日志变成"可查可统计"的结构化数据
日志能搜起来的关键是"字段化":原始的一行文本,经过解析器拆出具体字段(时间戳、级别、服务名、错误码等),才能做精准过滤与聚合。Logstash/Filebeat 的职责就是把非结构化的日志行转成结构化事件——比如用 grok 或 json 解析器把一行的关键部分提取为字段。搜起来之后,你能做的事就从"看有没有这个字"升级到"按 level=error 且 service=api 统计"。
# Logstash 解析示意(把一行拆成字段,才能过滤/聚合)
filter {
  grok { match => { "message" => "%{TIMESTAMP_ISO8601:ts} %{LOGLEVEL:level} %{WORD:service} %{GREEDYDATA:msg}" } }
}
# Kibana 查询示例:
#   level:ERROR AND service:api      # 按字段组合过滤
#   message:"panic" OR message:"OOM" # 全文关键词
落地关键是把"先想清楚哪些字段值得结构化"作为起点:至少要给时间戳、级别、来源服务这类的字段,其余按需补。别试图把每一条日志的所有内容都解析得面面俱到——"足够支持常见过滤与聚合"即可;反而不加解析全文搜也能用。把"采集 → 解析成字段 → 按字段检索/聚合"这条链理顺,日志就从"一卷卷原始文字"变成"一个可精确查询、可统计的检索库"。
四、告警与可视化:从"能搜到问题"到"问题自动暴露"
集中日志的另一层价值在于"把模式做成可视化与告警":Kibana 能存储检索、仪表盘聚合展示、并按条件触发告警(如某服务 `level=ERROR` 在窗口内超过阈值)把异常推给你。这把日志从"事后翻找"变成"事前被看到"——配合前面聊的 Uptime Kuma(可用性)与 Prometheus(指标),日志栈补上的是"应用 / 运行日志层面的异常"这一维。
# 告警思路:在 Kibana 规则里设置"level=ERROR 每分钟次数 > N 则告警"
# API/服务异常往往比纯"端口通不通"更早暴露,三者合起来覆盖更全
实践建议是分层使用:状态页(可用性)管"活没活",指标栈管"快不快",日志栈管"为什么 / 出了什么异常"。三者不是替代而是互补。别一上来就做极其复杂的告警规则,先把最核心"error 暴涨"这类设好,随着对业务的理解再细化。让日志从"一坨没人翻的文字"变成"能看趋势、能被规则盯住异常"的观测力,才是集中日志的真正收益。
五、必须有心理准备的现实:ES 是"又重又吃资源"的大家伙
诚实地说,ELK/ES 是这些监控选项里资源最重的一个:Elasticsearch 是常驻的 JVM 大数据服务,单节点入门也要给它足够的堆内存与磁盘,索引会持续增长,量大了磁盘很快占掉;Kibana/Logstash 各占一份。所以除非你确实需要它的全文检索与聚合能力,否则它会把小 VPS 压得很难受——这也是很多人用更轻的 Loki 的原因。先评估"我要不要这么强的检索",再做取舍,别为"反正大家都在用 ELK"就硬上。
# 资源提醒:ES 很吃堆内存与磁盘;
# 设好 k 索引生命周期(ILM/data stream)定期滚转与清理,避免日志无限涨满盘
真要让 ES 长期跑得稳,还要做几件事:设好索引生命周期与保留策略,日志不会无限堆积把盘写满;把 ES 数据卷与备份纳入异地快照(丢索引等于丢可搜索的运维资产);给 JVM 堆设明确上限、关注磁盘与段合并的资源占用。把"强检索 + 重资源 + 要顺手治理"这层边界认清,ES 才会是你需要强搜索时的强助力,而不是一个越跑越卡、盘越占越满的大负担。
结语
Elasticsearch + Kibana 的价值,是把散落各处的日志统一收进一个"可全文搜索、可按字段过滤聚合、可可视化告警"的集中仓库:用 Elasticsearch 做存储与检索、Kibana 做探索与面板、Logstash/Filebeat 做采集与字段化。落地要点:先起单节点 ES + Kibana 跑通"索引/字段/Discover",再用 logstash 把关键字段结构化、按字段组合检索与聚合,并可设 error 阈值告警。它的边界是"又重又吃资源"——提前做索引生命周期与数据卷快照备份、设好 JVM 堆与磁盘治理,并先评估是否真需要这么强的检索能力,再决定为它投入多少资源。这样 ES 才会是你运维观测里可靠的一环,而不是压垮小服务器的隐患。