当你把一个对外服务(网站/API)跑在单台服务器上,心里往往会悬着一个问题:万一这台机器挂了,用户访问到的就全没了。你当然可以用备份把数据捞回来,但"让用户在故障时不感知"是另一个层次——需要的是高可用(High Availability):当主节点故障时,流量自动切到备用节点,服务对外几乎不中断。Linux 上把这件事做起来最经典、也最贴合 VPS/自托管场景的组合是 Keepalived + HAProxy:Keepalived 用一个虚拟 IP(VIP)在主机间漂移做到"节点故障自动切换",HAProxy 在前端做负载均衡与健康检查。这篇讲清它解决什么、VIP 与健康检查怎么工作、最小怎么搭一套,以及它的单点与现实边界。
一、高可用解决什么:把"单点故障"变成"自动切换"
单机服务最怕的是"机器没了"——内存、机房断电、网络故障、进程崩溃,用户就访问不到了。有两种思路应对:一是"恢复",用备份重建(会停机、不可感知);二是"高可用",预先备一台(或多台)可顶上来的节点,主节点故障时流量在第一时间切到备节点,用户几乎无感。对真正在乎对外可用性的服务,高可用的价值正在于"故障时服务不中断、回得也快",而不是等备份慢慢恢复。
在自托管/VPS 语境下,Kubernetes 那套自愈对多数人太重,而 Keepalived + HAProxy 是本机或两机之间更朴素、更可控的组合:Keepalived 负责"我说我活着、我说我挂了"以及虚拟 IP 的漂移,HAProxy 负责把请求真正分发给一个健康的后端。它们一起解决的是"节点级漂移 + 服务级健康检查"这套高可用的核心,适合"两台机器、一个对外 VIP"这类经典双机/多机拓扑。
二、核心概念:虚拟 IP 与健康检查如何串起"自动切换"
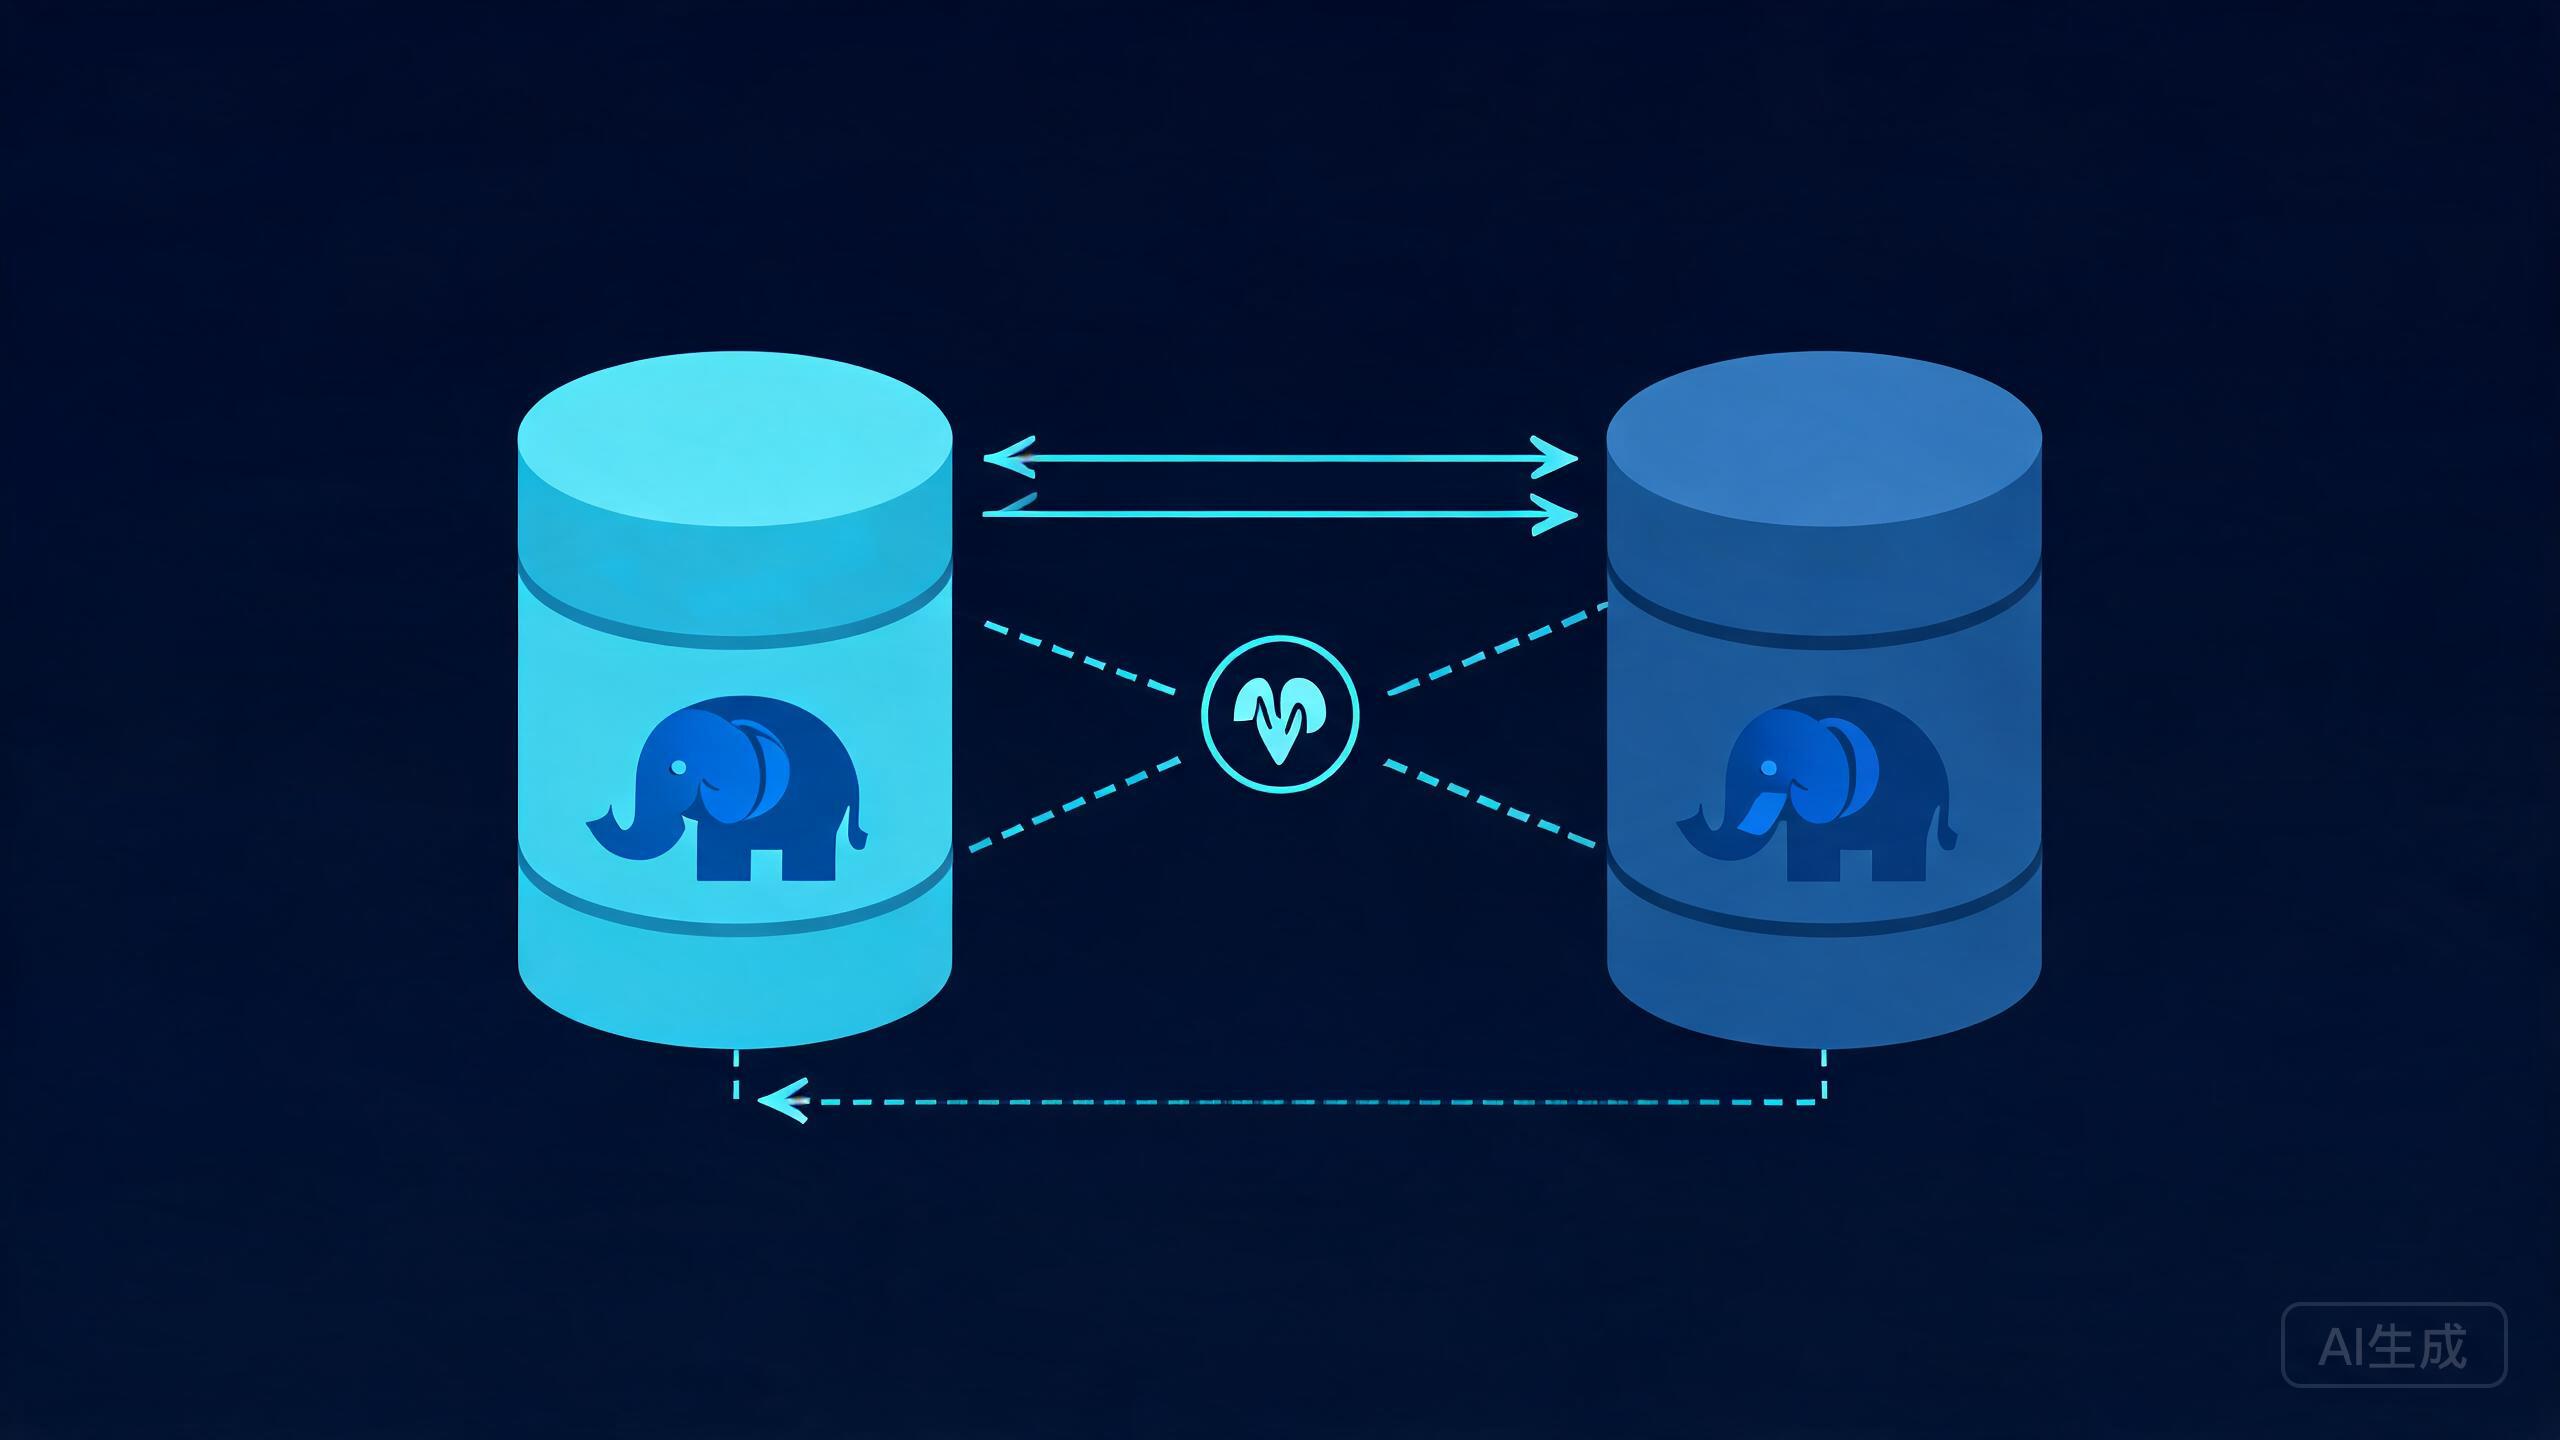
先弄清两个齿轮如何咬合。虚拟 IP(VIP):对外公布的是一个不特属于哪台机器的"虚拟地址",主节点故障后它被"漂移"到备用节点绑定,对外流量自动指向新的活节点——这是"节点级切换"的关键,用户始终访问 VIP,并不知道后端换了机器。健康检查:Keepalived 用 VRRP 心跳在节点间宣告"我还在";HAProxy 则对后端服务做 TCP/HTTP 健康检查,把"进程活着但实际不健康"的节点从分发中摘掉。
# 示意:两台机器对外共享一个 VIP(如 192.168.1.100),Keepalived 决定它漂到谁
# 主节点 keepalived.conf 关键点:
vrrp_instance VI_1 {
  state MASTER            # 优先级高的成为激活方
  virtual_router_id 51
  interface eth0
  virtual_ipaddress { 192.168.1.100/24 }
}
# 备节点 state BACKUP + 较低 priority,主挂后 VIP 自动漂到它
把"这是节点级(VIP 漂移)与端口/服务级(健康检查摘下线)两层配合"的模型想清,高可用的行为就清楚了:Keepalived 判断的是"这台机器整不整、网口活不活",HAProxy 判断的是"这个后端服务真实健不健康"。二者配合,才既能在机器级故障时快速切换,又能在服务级异常时不让它把用户带崩。别把两者混为一行——它们的"健康"判定对象不同。
三、最小落地:Keepalived + HAProxy 的一台"对外入口"
落地时,HAProxy 通常作为对外入口(VIP 绑在它上面做负载均衡到后端),Keepalived 保证如果这台 HAProxy 主机挂了,VIP 漂到备机、备机的 HAProxy 承接。给一个极简的 HAProxy 前端到两个后端 Web 的示意:
# haproxy.cfg 关键片段
frontend www
  bind *:80
  default_backend web
backend web
  balance roundrobin
  option httpchk GET /health
  server web1 192.168.1.10:80 check
  server web2 192.168.1.20:80 check
# + Keepalived 在 192.168.1.10/20 之间漂移 VIP,
#   保证对外始终有一个活动的 HAProxy 前端口
落地关键是把"先单机 HAProxy 跑通再上 Keepalived 双机漂移"作为推进顺序:先在主节点把 HAProxy 到后端跑通、验证健康检查能摘线;再配好两台之间的 Keepalived VIP 漂移,验证拔掉主节点的网线/关掉它时,备节点能顶上来、VIP 正常漂移。别一上来就把两者叠在一起调,分层推进能大幅省去排障时间。
四、排障与验证:别让"高可用"变成"高风险单点"
高可用系统有个反直觉的风险:它本身也可能成为单点或"假健康"。所以要主动验证它的行为而非只靠相信配置:测"杀掉主节点进程/关掉主节点网卡,VIP 是否及何时漂移、备节点是否及时接住";测"某个后端服务返回 500/挂掉后,HAProxy 是否把它摘线、请求是否都打到健康的那个";把这些切换与摘线当成定期演练,而不是只在出事那天赌它工作。假健康(进程在但服务实际不通)是常见坑,健康检查要真正打到应用层(如 HTTP `/health`),而不只是 TCP 通。
# 验证思路(演练,非一次性):
#   1) keepalived 状态:ip addr show(看 VIP 是否在本机 eth0)
#   2) 模拟故障:sudo systemctl stop keepalived    # 或直接停掉一个后端
#   3) 观察 VIP 是否漂到备机、请求是否全部由健康后端承接
落到实操,我给三条原则:健康检查一定要是"应用层能反映真实可用"的探活(HTTP `/health` 优于 TCP ping);故障切换要演练成习惯而非赌;日志与状态(`keepalived` 状态、HAProxy stats 页)要能一眼看出"当前谁是主、各后端健康与否"。高可用做得好的标志不是"配置得像",而是"坏了它能真的切、切完你能看得见"。
五、边界:高可用解决"可用性",不等于"备份"与"零损失"
最后把边界立清。高可用解决的是"可用性/切换"——它保证用户在故障时不丢访问,但它不替代备份:如果"数据"出问题(误删除、被脏写、文件损坏),高可用切到备机也只是切到一份相似的数据,并不能帮你回滚或找回丢失内容。所以高可用和备份是两个互补维度:高可用管"服务在不在",备份管"数据能不能回"。别误以为"做了高可用就不用备份了"。
同时也要认可它的成本与适用边界:双机/多机高可用意味着要养同样的一套机器与配置(Keepalived 那台 HAProxy、以及它的配置同步),复杂度与维护投入随之上升。对多数个人/小业务,先判断"这服务的对外可用性真的值不值得我多养一台机器 + 维护这套切换"。决定上时,把那台"备机"也纳入监控与备份、别让它成为没人管的孤儿。把"高可用管可用性、备份管数据、边界要按需投入"这三点想清,Keepalived + HAProxy 才会是你稳定对外服务的一层可靠保障,而不是又多一个没人维护的单点。
结语
Keepalived + HAProxy 高可用的价值,是用虚拟 IP 在节点间自动漂移实现"节点故障自动切换"、用应用层健康检查把不健康的后端摘下线,让对外服务在单台机器故障时不中断。落地要点:Keepalived 管 VRRP 心跳与 VIP 漂移(节点级)、HAProxy 管 HTTP/TCP 健康检查与分发(服务级),两者配合;先单机跑通再做双机漂移验证;把"杀进程/断网线/停后端"做成定期演练,健康检查务必打到应用层 `/health`。边界是"它管可用性、不管数据备份",且要按需付出养备机与维护的成本——想清后再决定是否上,上了就把它纳入监控、备份与演练。