单台 VPS 上跑着网站,最大的风险就是"单点故障":机器宕机、机房断网、进程崩溃,任何一个问题都会让网站直接无法访问。解决思路很直接——准备两台服务器,一台挂了另一台顶上,而让"切换"自动发生,靠的就是 VRRP 协议和 Keepalived。
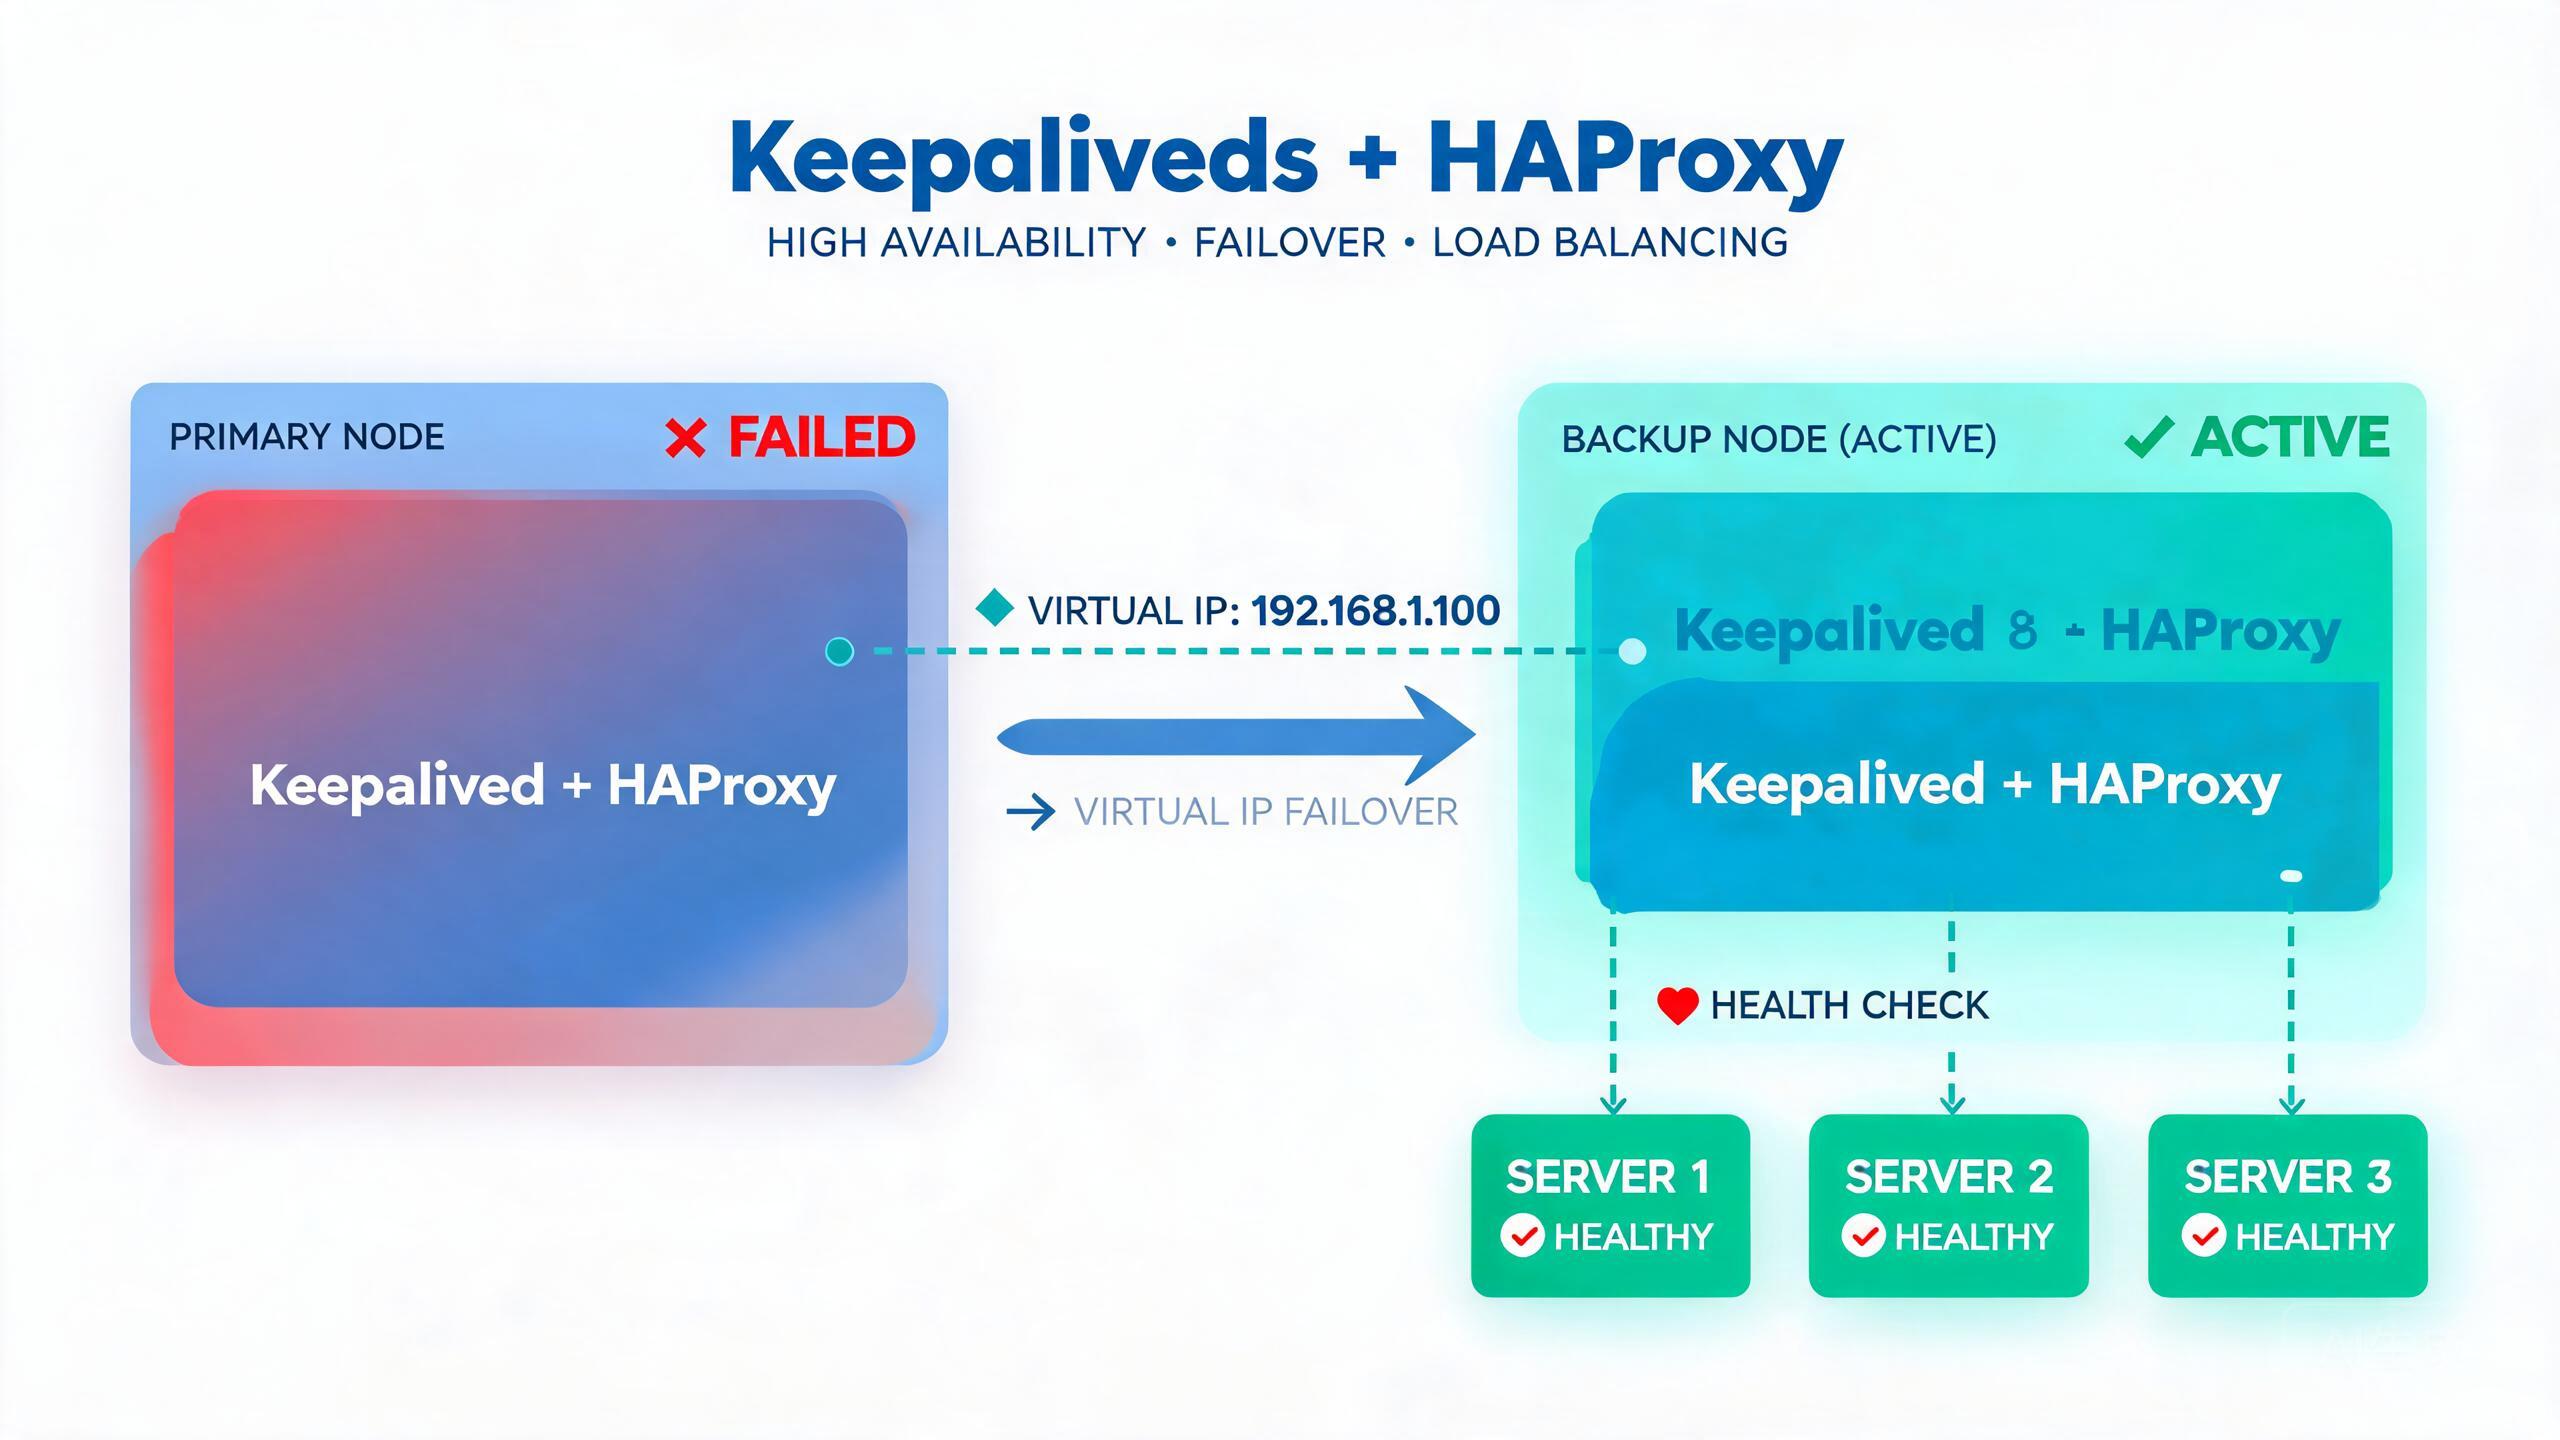
Keepalived 通过 VRRP(虚拟路由冗余协议)在两台服务器之间维护一个"虚拟 IP"(VIP)。正常情况下 VIP 绑定在主节点上,主节点挂了之后 VIP 会在几秒内漂移到备节点,客户端依然访问同一个 IP,感知不到任何变化。本文用两台 Nginx 服务器做演示,完整讲解 Keepalived 的安装、配置、健康检查和故障排错。
一、高可用架构与原理
先看整体架构:
       客户端(访问 http://1.2.3.100)
                     |
              [ 虚拟 IP: 1.2.3.100 ]
              /                    \
     Master(1.2.3.1)          Backup(1.2.3.2)
        Nginx                  Nginx
        Keepalived             Keepalived
工作流程:
1. Master 上的 Keepalived 周期性发送 VRRP 组播通告(默认 1 秒一次)
2. Backup 持续监听,如果连续 3 个通告周期没收到 Master 的消息
   (默认 3 秒超时),判定 Master 失联
3. Backup 将自己的网卡绑定上虚拟 IP 1.2.3.100,接管流量
4. Master 恢复后重新抢占虚拟 IP(priority 高的优先)
关键概念:
VRID      # 虚拟路由 ID,同一组高可用节点必须一致(1~255)
priority  # 优先级,数值越大越优先成为 Master,主备必须不同
VIP       # 虚拟 IP,客户端访问的地址
vrrp_script  # 自定义检查脚本,用于探测 Nginx 是否存活
二、环境准备与安装
两台机器假设如下:
Master: 192.168.1.10  (CentOS Stream 9)
Backup: 192.168.1.11  (CentOS Stream 9)
VIP:    192.168.1.100
两台机器都要装 Nginx 和 Keepalived:
# CentOS/Rocky
yum install -y nginx keepalived

# Debian/Ubuntu
apt-get install -y nginx keepalived
确认安装版本:
keepalived -v
# Keepalived v2.2.8 (09/19, 2023)
为了方便验证切换效果,给两台 Nginx 的首页写上不同标识:
echo "This is MASTER (192.168.1.10)" > /usr/share/nginx/html/index.html   # 主节点
echo "This is BACKUP (192.168.1.11)" > /usr/share/nginx/html/index.html   # 备节点
systemctl enable --now nginx
三、编写健康检查脚本
Keepalived 默认只检测"自己进程活着",但如果 Nginx 挂了而 Keepalived 还活着,VIP 不会漂移,用户照样访问不到。所以要写一个脚本探测 Nginx,脚本放在两台机器的 /etc/keepalived/check_nginx.sh:
#!/bin/bash
# 探测 Nginx 是否存活:存活返回 0,挂掉返回 1(并尝试拉起一次)
if ! pgrep -x nginx >/dev/null; then
    systemctl start nginx
    sleep 2
fi
pgrep -x nginx >/dev/null && exit 0 || exit 1
赋予执行权限:
chmod +x /etc/keepalived/check_nginx.sh
更严格的探测可以加上端口和 HTTP 状态码检查,防止"进程活着但服务不可用"的情况:
#!/bin/bash
curl -sf -o /dev/null http://127.0.0.1/health || exit 1
exit 0
四、Master 节点配置
编辑 /etc/keepalived/keepalived.conf:
global_defs {
    router_id LVS_MASTER        # 本机标识,主备不要一样
}

# 健康检查脚本,每 2 秒执行一次
vrrp_script check_nginx {
    script "/etc/keepalived/check_nginx.sh"
    interval 2
    weight -20                  # 脚本失败时优先级降低 20
    fall 2                      # 连续 2 次失败才算失败
    rise 2                      # 连续 2 次成功才算恢复
}

vrrp_instance VI_1 {
    state MASTER                # 主节点状态
    interface eth0              # 绑定的网卡(用 ip addr 确认)
    virtual_router_id 51        # VRID,主备必须一致
    priority 100                # 主节点优先级(备节点必须更低)
    advert_int 1                # VRRP 通告间隔 1 秒
    nopreempt                   # 主节点恢复后不主动抢占(可选)
    authentication {
        auth_type PASS
        auth_pass 8$#KvPSecrEt  # 主备一致的明文密码,勿用默认
    }
    virtual_ipaddress {
        192.168.1.100/24 dev eth0   # 虚拟 IP 及掩码
    }
    track_script {
        check_nginx
    }
    notify_master "/etc/keepalived/notify.sh master"
    notify_backup "/etc/keepalived/notify.sh backup"
}
五、Backup 节点配置
备节点除了 state、priority、router_id 外基本一致:
global_defs {
    router_id LVS_BACKUP
}

vrrp_script check_nginx {
    script "/etc/keepalived/check_nginx.sh"
    interval 2
    weight -20
    fall 2
    rise 2
}

vrrp_instance VI_1 {
    state BACKUP
    interface eth0
    virtual_router_id 51
    priority 90                 # 备节点优先级必须低于主节点
    advert_int 1
    authentication {
        auth_type PASS
        auth_pass 8$#KvPSecrEt
    }
    virtual_ipaddress {
        192.168.1.100/24 dev eth0
    }
    track_script {
        check_nginx
    }
}
两台机器都启动 Keepalived:
systemctl enable --now keepalived
六、验证故障切换
先在 Master 上确认 VIP 已绑定:
ip addr show dev eth0 | grep 192.168.1.100
# inet 192.168.1.100/24 scope global secondary eth0   ← 有输出说明 VIP 在 Master 上
用另一台机器持续访问 VIP:
while true; do curl -s http://192.168.1.100/; sleep 1; done
# 持续输出 This is MASTER (192.168.1.10)
现在模拟故障——直接停掉 Master 的 Keepalived(或拔网线、关 Nginx):
systemctl stop keepalived # 在 Master 上执行
观察 curl 输出,大约 3~5 秒后会变成:
This is BACKUP (192.168.1.11)
再到 Backup 上确认 VIP 已漂移过来:
ip addr show dev eth0 | grep 192.168.1.100
把 Master 的 Keepalived 重新启动,由于配置了 nopreempt,VIP 不会立刻抢回,避免频繁切换抖动;如果没有配置 nopreempt,Master 恢复后约 1~3 秒内会自动抢占回 VIP。
七、排错与避坑
问题 1:VIP 起不来,日志报 authentication failed
主备两端的 auth_pass 不一致或 VRID 不一致都会导致协商失败。查看日志定位:
journalctl -u keepalived -f
tail -f /var/log/messages | grep -i keepalived
# 出现 "VRRP_Instance(VI_1) removing protocol" 或 "authentication failed"
# 检查 auth_pass 是否完全一致、virtual_router_id 是否相同
问题 2:VIP 频繁在两端来回漂移(脑裂/抖动)
通常是网络抖动导致 VRRP 组播包丢失,两端都认为自己是 Master。处理思路:
1. 确认两台机器在同一广播域(同一交换机/同一内网),VRRP 组播不能跨三层
2. 把 advert_int 适当调大(如 2 秒),容忍短时丢包
3. 检查防火墙是否放行 VRRP 协议:
   firewall-cmd --permanent --add-protocol=vrrp && firewall-cmd --reload
4. 检查是否有其他机器误配了相同的 VRID
问题 3:Nginx 挂了但 VIP 不漂移
说明 track_script 没有生效。逐个排查:
1. 确认脚本有执行权限:ls -l /etc/keepalived/check_nginx.sh
2. 手动执行脚本看返回值:/etc/keepalived/check_nginx.sh; echo $?
3. 脚本路径必须写绝对路径,并去掉脚本里的换行符问题(Windows 编辑过的脚本会报错)
4. 查看 keepalived 日志里是否有 "Unknown track_script" 字样
问题 4:主节点恢复后没有抢回 VIP
如果配置了 nopreempt,主节点不会主动抢回,这是正常设计。需要立即抢回时,去掉 nopreempt 并保证主节点 priority 更高即可。注意 nopreempt 只在 state MASTER 节点上配置才有效。
问题 5:VIP 在网卡上但外网访问不通
检查 VIP 是否绑定在正确的网卡、掩码是否一致,以及后端 Nginx 是否监听在 VIP 上(默认 Nginx 监听 0.0.0.0 即可,不用特意绑 VIP)。另外云厂商的 VPS 若 VIP 是内网地址,需要确认安全组放行了对应端口。
问题 6:weight 为负导致优先级归零
weight -20 在脚本失败时把优先级扣 20。如果主节点 priority=100 扣完剩 80,仍高于备节点 90?不会——主节点 priority 100 扣 20 后是 80,低于备节点 90,VIP 正确漂移。所以设计时记得:主节点 priority - weight 必须小于备节点 priority,切换逻辑才成立。
八、总结
Keepalived + Nginx 是 VPS 双机高可用的经典组合:VRRP 负责虚拟 IP 漂移,track_script 负责探测业务健康,配合 notify_* 脚本还能在切换时自动发告警。配置核心就三件事:主备 priority 拉开差距、健康检查脚本可靠、VRID 和认证信息两端一致。部署后务必做一次"拔网线式"演练(直接 stop keepalived 或关 Nginx),确认切换时间在几秒以内,否则这套高可用就只是"看起来有"。对于追求更短故障转移时间的业务,后续还可以在此基础上叠加 DNS 轮询、负载均衡器或者云厂商的 SLB,但 Keepalived 永远是自建方案里最透明、最可控的那一个。