跑 K8s 的自托管,到了"数据库、Redis、有状态的中间件"这步就开始犯难:Deployment 假设 Pod 是无状态、可随时重建的,而像数据库这类服务天生是"有身份的、数据要跟着自己走的"——每次重启换一个名字、数据盘飘忽不定,完全没法跑。Kubernetes 用 StatefulSet 专管这类"有状态应用":给每个 Pod 稳定的序号与稳定的网络身份,配合持久卷(PVC/PV),让"哪个实例对应哪块数据"稳稳钉住。更进阶的还有 Operator,把复杂有状态应用(数据库这类)的部署、备份、扩缩容交给"懂它"的控制器自动打理。这篇讲清 StatefulSet 与 Operator 解决什么、怎么用、典型场景,以及常见坑与边界。
一、有状态应用为什么要特殊处理:身份要稳定、数据要跟着走
Deployment 对 Pod 是"无名之辈,可随意替换":名字随机、可滚动重建,你也不该依赖某个具体 Pod。但有状态应用(最主要的是数据库)无法接受这种"无常":它需要"我认得出是我"的稳定身份(别人要靠它连接)、需要"我的数据在我的固定存储里"(不能每次换盘)、需要"扩容/缩容节点时别把数据弄乱"。StatefulSet 就是为此设计:给每个副本一个稳定且有序的名字(如 db-0、db-1)、一个稳定的网络身份(用 Headless Service 提供 peer DNS),并通过它声明的 VolumeClaimTemplates 让每个 Pod 拿到"自己专属、稳定绑定"的 PVC——于是"哪个节点、哪块数据"被确定性地钉住,不再随 Pod 重建而漂移。
它和 Deployment/前面的无状态操作的分界:无状态应用(Web、API、批处理)用 Deployment 最省心、可随意滚动;有状态应用(数据库、Redis、ZooKeeper)才用 StatefulSet,接受"顺序启动/终止、身份稳定"的约束。不是"高级就用 StatefulSet",而是"你的应用到底有没有状态"决定用哪个——很多人把无状态服务硬套 StatefulSet,反而自找麻烦。
二、StatefulSet 怎么用:稳定的名字 + VolumeClaimTemplates 让数据钉住
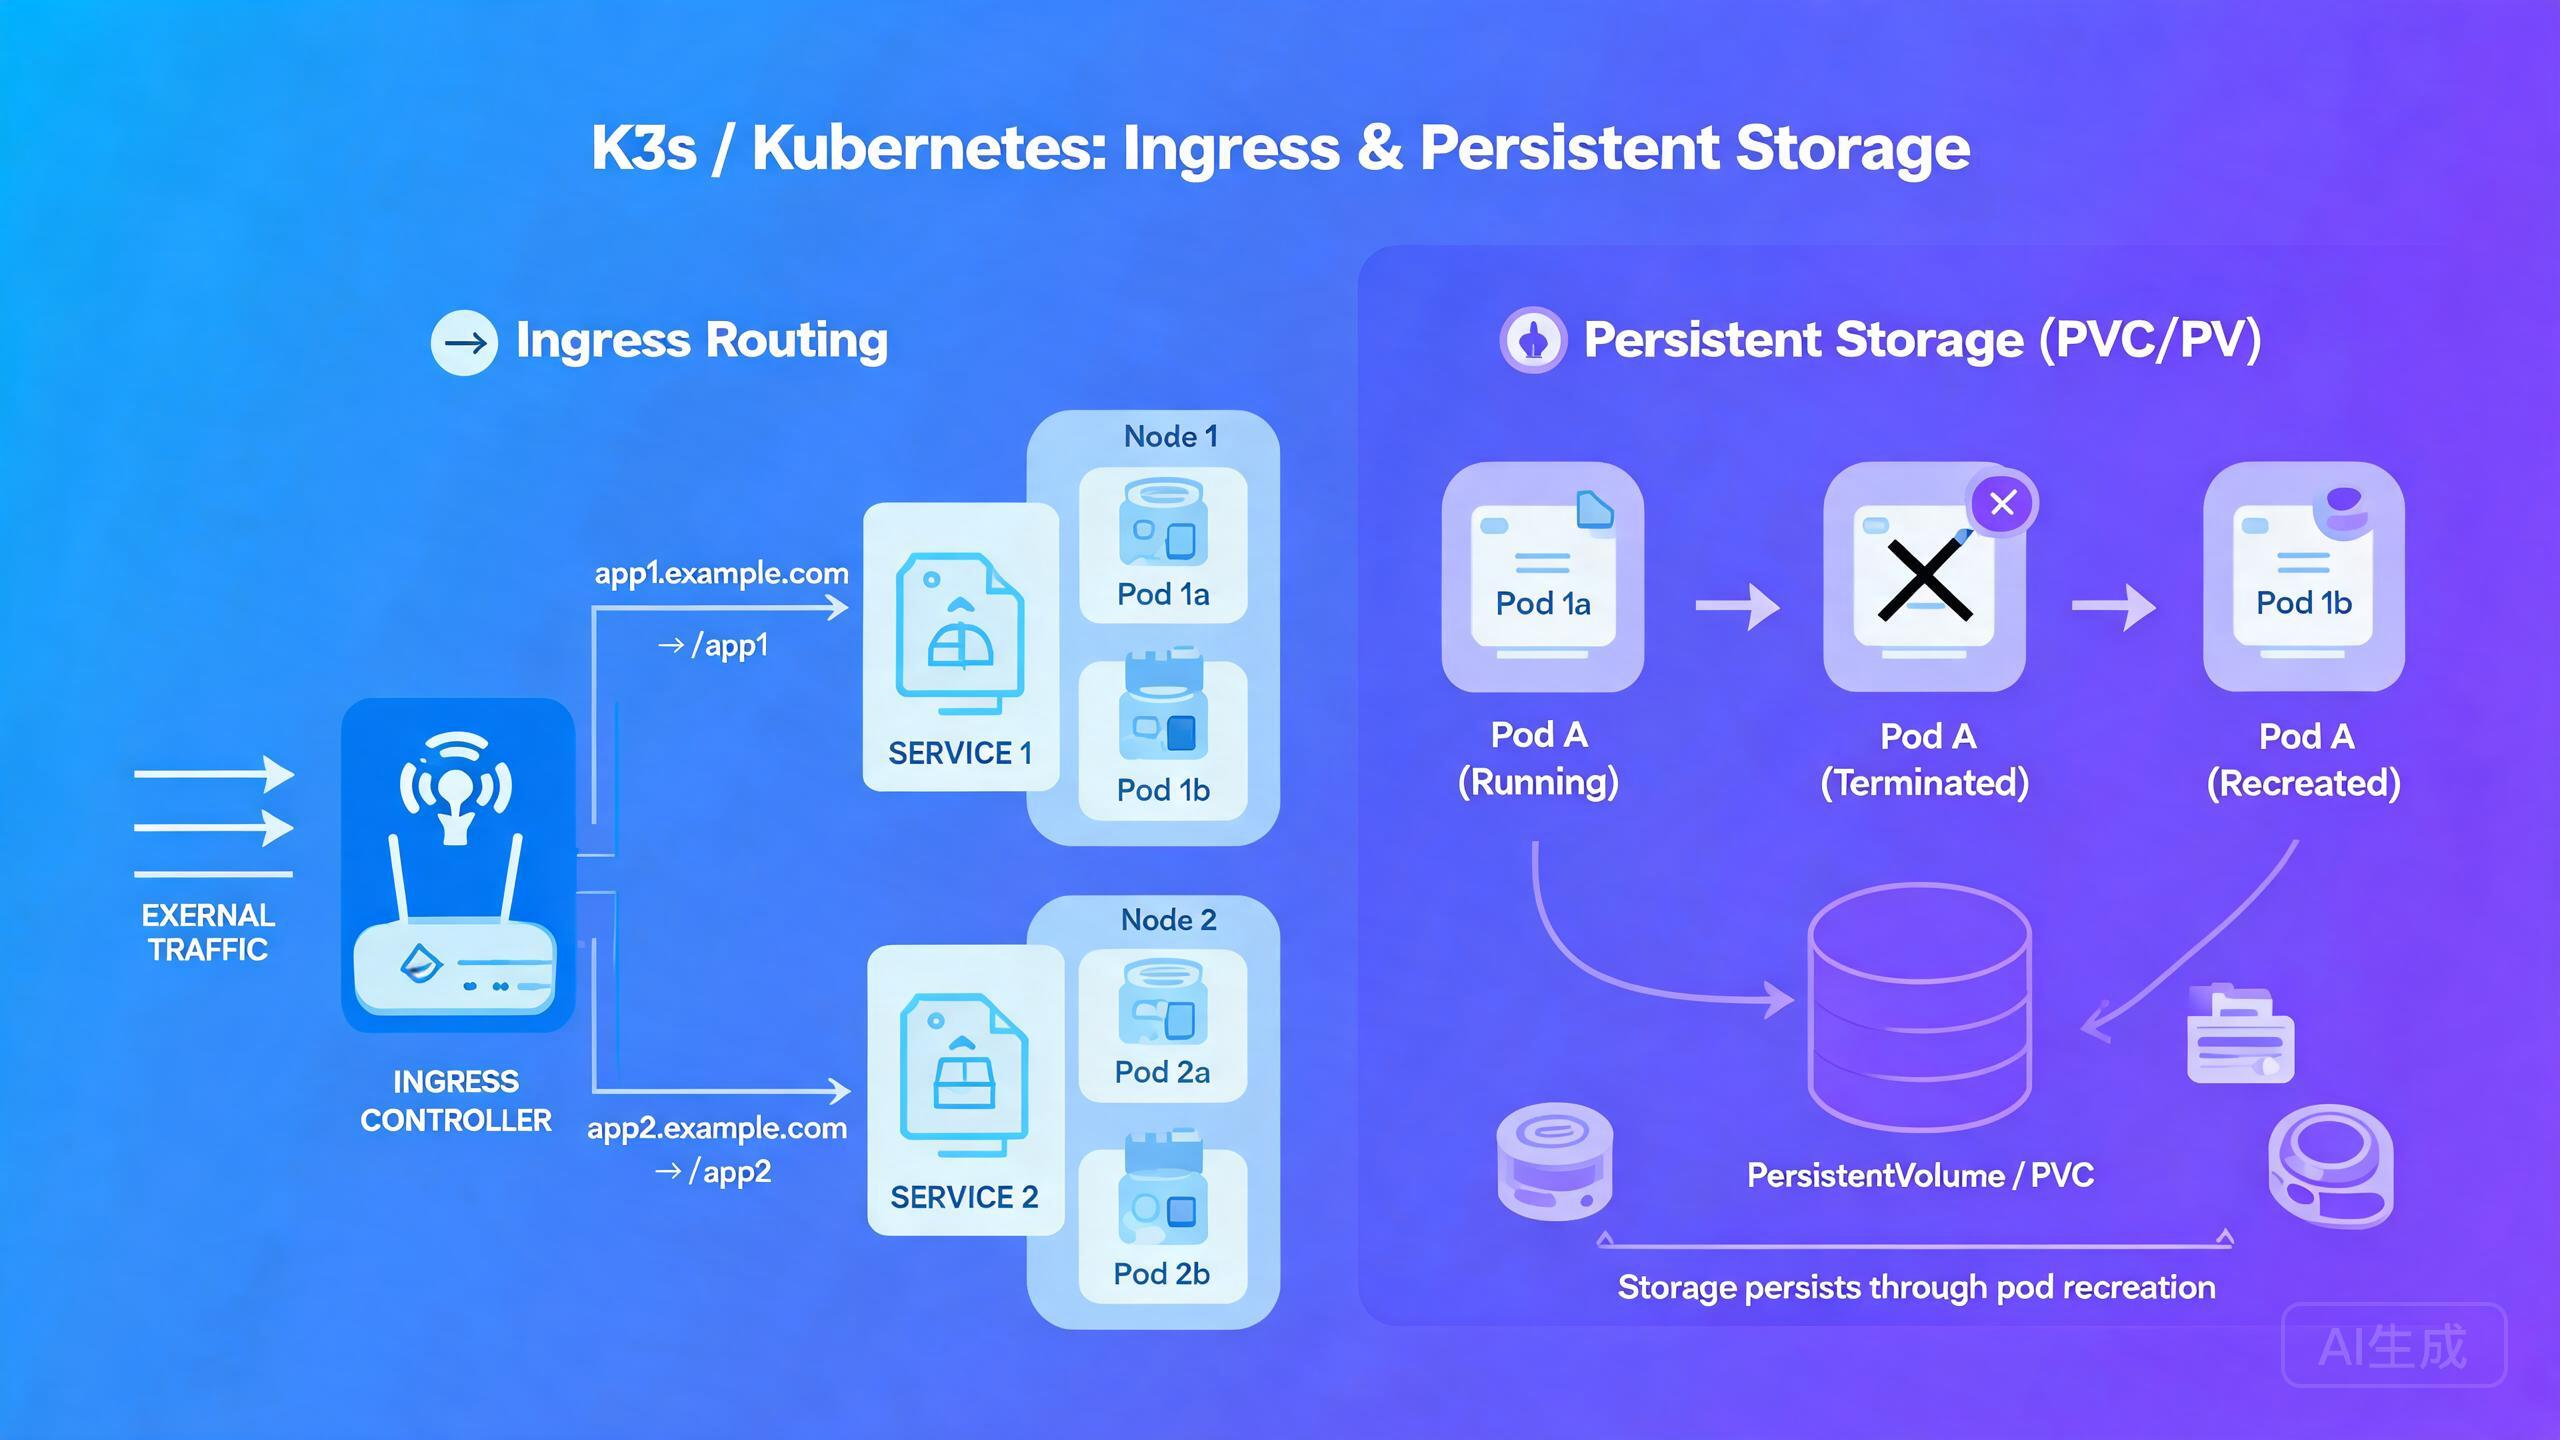
StatefulSet 的两个核心机制:一是稳定序号与网络身份——每个 Pod `服务名-序号`(如 app-db-0),配合 Headless Service(clusterIP: None)用这个名字做 DNS,让副本能互相以稳定名字寻址(数据库节点间要用 peer 地址);二是 VolumeClaimTemplates——你声明"每个副本要一块怎样的 PVC",控制器为每个副本创建并绑定独立的持久卷,且这个绑定在 Pod 重建后由新的同名 Pod 继承(数据还在)。于是"db-0 的数据在 db-0-pvc 里"这种确定性就建立起来了。
# StatefulSet 关键字段示意(含 Headless Service)
apiVersion: v1
kind: Service                 # Headless Service:不分配 ClusterIP,提供稳定 DNS
metadata: { name: db }
spec: { clusterIP: None, selector: { app: db }, ports: [ { port: 3306 } ] }

apiVersion: apps/v1
kind: StatefulSet
metadata: { name: db }
spec:
  serviceName: db            # 关联上面的 Headless Service
  replicas: 2
  selector: { matchLabels: { app: db } }
  template:
    metadata: { labels: { app: db } }
    spec:
      containers: [ { name: db, image: mysql:8 } ]
  volumeClaimTemplates:      # 每个副本一块独立 PVC
    - metadata: { name: data }
      spec:
        accessModes: ["ReadWriteOnce"]
        resources: { requests: { storage: 10Gi } }
# 效果:Pod 名叫 db-0、db-1,各自绑定 data-db-0、data-db-1 两块 PVC
# Pod 重建后仍是同名,数据仍挂在这块 PVC 上——身份与数据都稳定
用 StatefulSet 的坑主要是"把顺序/身份当约束滥用"与"存储与调度配合":StatefulSet 是顺序启动、终止与更新(0→N),对重启时间敏感或要求并行伸缩的场景未必合适;而"数据卷绑定"与前面聊的调度(Pod 想迁移但 local PV 钉在某节点)要配合——用 network-store(NFS 等)则要确认 RWO 语义与性能是否匹配。先想清"你要的是稳定身份 + 稳定数据",再决定是否值得付出它的约束。
三、Operator 是什么:把"复杂的数据库运维"交给懂它的控制器
StatefulSet 解决了"有身份的 Pod + 稳定的数据",但"把一套数据库跑好"还远不止这些:要做初始化、主从配置、备份、扩缩容、升级、故障自愈——这些"业务化运维",普通清单表达不了。Operator 就是"把运维某个应用的领域知识,写成一组自定义资源 + 控制器":你声明 `kind: MySQLCluster` 并写"我要 3 副本、要备份到某处",Operator 的控制器就自动去创建 StatefulSet、配主从、做备份、处理扩缩容和故障。自托管里最典型的 Operator 是数据库类(MySQL/Postgres/Redis 的官方或社区 Operator),把"手工配一整套数据库"变成"声明一下就自动搞定"。
# 数据库 Operator 的声明式用法示意(以某 MySQL Operator 为例)
apiVersion: mysql.oracle.com/v2
kind: MySQLCluster
metadata: { name: mycluster }
spec:
  version: "8.4.0"
  replicas: 3                  # 一写多读,Operator 自动配主从
  backupProfile:
    backupSecretName: mybackup-secret
    fullBackupSchedule: "0 2 * * 0"   # 每周定时全量备份到 S3/MinIO
  router: { replicas: 2 }
# 你只需要声明"要一个怎样的集群",初始化/主从/备份/升级都由 Operator 打理
Operator 的坑是"引入了一个你不太懂的控制器":它大幅自动化,但也把复杂度藏进了自己的逻辑里——Operator 崩溃、版本升级、声明与它内部状态不一致时,排障更难。所以用 Operator 的原则是"选成熟、文档全、有社区的主流 Operator,别为了用而去用自制/小众的";并把它的状态、备份、日志纳入监控,别让"自动化"变成"黑盒"。
四、常见坑:把无状态套 StatefulSet、存储类型选错、Operator 黑盒、升级数据
有状态应用落地,四个坑要尤其防。一是"把无状态服务硬套 StatefulSet":Web/API 本可用 Deployment 随意滚动,套 StatefulSet 反而背上顺序更新等约束、还占资源——先判应用有没有状态。二是"存储类型选错":local volume 类型把数据钉在某台节点、Pod 迁移受限;共享网络存储(NFS 等)可迁移但要看 RWO/RWX 与性能——按"要不要迁移 + 性能要求"选存储类。三是"Operator 黑盒":以为声明完就万事大吉,其实 Operator 的备份、升级、故障处理都要验证与监控,别把关键数据交给一个"没照看过"的自动化。四是"升级的取舍":有状态应用升级(换镜像版本)是高风险动作,要做好备份与回退预案、在主从侧先升从再升主的节奏下进行——别像无状态那样一把梭滚动。
# 有状态应用升级/变更的安全节奏(以数据库为例)
#   1) 操作前:做一次完整备份(备份到独立位置)
#   2) 升级顺序:先升从库、验证正常,再升主库/做主备切换
#   3) 升级后:验证读写、同步状态,能回退的做好回退预案
#   别把数据库升级当成普通无状态应用的滚动升级来做
把它当排障 SOP:StatefulSet 出的问题先看"Pod 序号/身份是否稳定、PVC 是否绑定到正确节点";Operator 出的问题先看"它的自定义资源状态与事件(kubectl get
五、边界:StatefulSet/Operator 管"身份与自动运维",不替代真备份与架构分层
这层的边界要认清:StatefulSet 保证"身份与数据的稳定绑定",Operator 自动做"常规运维"(初始化/主从/备份任务编排),但**都不替代"可靠且经演练的数据备份与恢复"**——Operator 的备份也依赖你接的对象存储/存储后端的可靠性,恢复演练仍要做。其次,有状态服务在 K8s 里的复杂度本就高于虚拟机/裸机,是否值得上 Operator、是否把数据库放 K8s,都要评估"维护成本 vs 收益"。最后,Operator 是"控制器代码",同样有 bug 与升级风险,不能因为"它自动"就放松监督与演练。
把 StatefulSet 与 Operator 放回自托管整体:它们是 K8s 能承接"数据库这类有状态服务"的关键能力——StatefulSet 解决"有身份 + 数据钉住",Operator 解决"自动化的专用运维"。落地要点:先判应用有没有状态,有状态才用 StatefulSet(稳定名字 + Headless Service + VolumeClaimTemplates 绑 PVC);对数据库这类复杂运维,选成熟官方/社区 Operator 做初始化、主从、备份与扩缩容的声明式自动化;防住套错、存储类型选错、Operator 黑盒、升级不备份四坑,升级走"先备份、先从后主、可回退"的节奏;并认清它们不替代真备份与演练。当你把有状态服务用 StatefulSet 钉住身份与数据、用 Operator 接住自动运维,K8s 才能真正成为"能扛数据库"的可靠底座。
结语
StatefulSet 与 Operator 的价值,是让 Kubernetes 能承接"数据库这类有状态服务":StatefulSet 给每个 Pod 稳定的名字、网络身份并让数据通过 PVC 钉住,Operator 把初始化/主从/备份/扩缩容这些复杂运维做成声明式自动化。落地要点:先判应用有无状态,有状态才用 StatefulSet(Headless Service + VolumeClaimTemplates + RWO 存储)确保"哪个实例对应哪块数据"稳定;对数据库用成熟 Operator 声明式打理,并把它纳入监控而非当黑盒;防住套错、存储类型选错、Operator 黑盒、升级不备份四坑,升级走"先备份、先从后主、可回退"的节奏;并认清它们不替代真备份与恢复演练。当"身份、数据、自动运维"三件事由 StatefulSet 与 Operator 稳稳接住,K8s 自托管才算真正敢把关键数据服务放进去。