自托管服务器的"够不够用",很多人靠感觉:"好像有点卡""高峰期页面慢"。但这其实是最容易被骗的:感觉到的"慢"到底慢在 CPU、内存、磁盘还是网络?平时够用,流量冲高时会不会直接挂?——这些不量化,就只能一次次"出事了才扩容"。容量规划与性能基准回答的正是两件事:一是"这台机器/集群到底能扛多少"(通过压测量出基线),二是"按当前的量和增长,资源该怎么配"(据此做留量与扩容决策)。这篇讲清它与压测的分工、怎么量基线、怎么按增长做规划、怎么监控与留量,以及常见坑与边界。
一、容量规划解决什么:把"够不够用"从感觉变成"可量化的判断"
容量问题的本质是"需求 vs 供给"的匹配:服务器资源(CPU/内存/磁盘/带宽/连接数)是供给,访问量、数据量、并发是需求。容量规划就是先"度量供给的瓶颈在哪、能扛多少",再"推需求的现状与增长",然后得出"何时该扩什么、留多少余量"的判断。它让"要不要加内存/换机器/加节点"从拍脑袋变成有数据支撑——你不用等到"高峰期白屏"才被动扩容,而是"按增长曲线预留,提前从容应对"。对自托管尤其有价值:一台机器挂了多个服务,谁最该扩容、什么时候扩,是有讲究的。
它和性能压测的分工:压测是"手段",回答"在给定负载下系统表现如何、能扛多少并发/吞吐";容量规划是"工程",回答"结合压测出的基线与真实业务的增长,该配多少资源、何时扩"。压测给的是"现在的天花板",容量规划把"天花板 + 需求增长"换算成"够用多久、什么时候扩"。
二、怎么量基线:压测 + 监控度量"真实能扛多少"
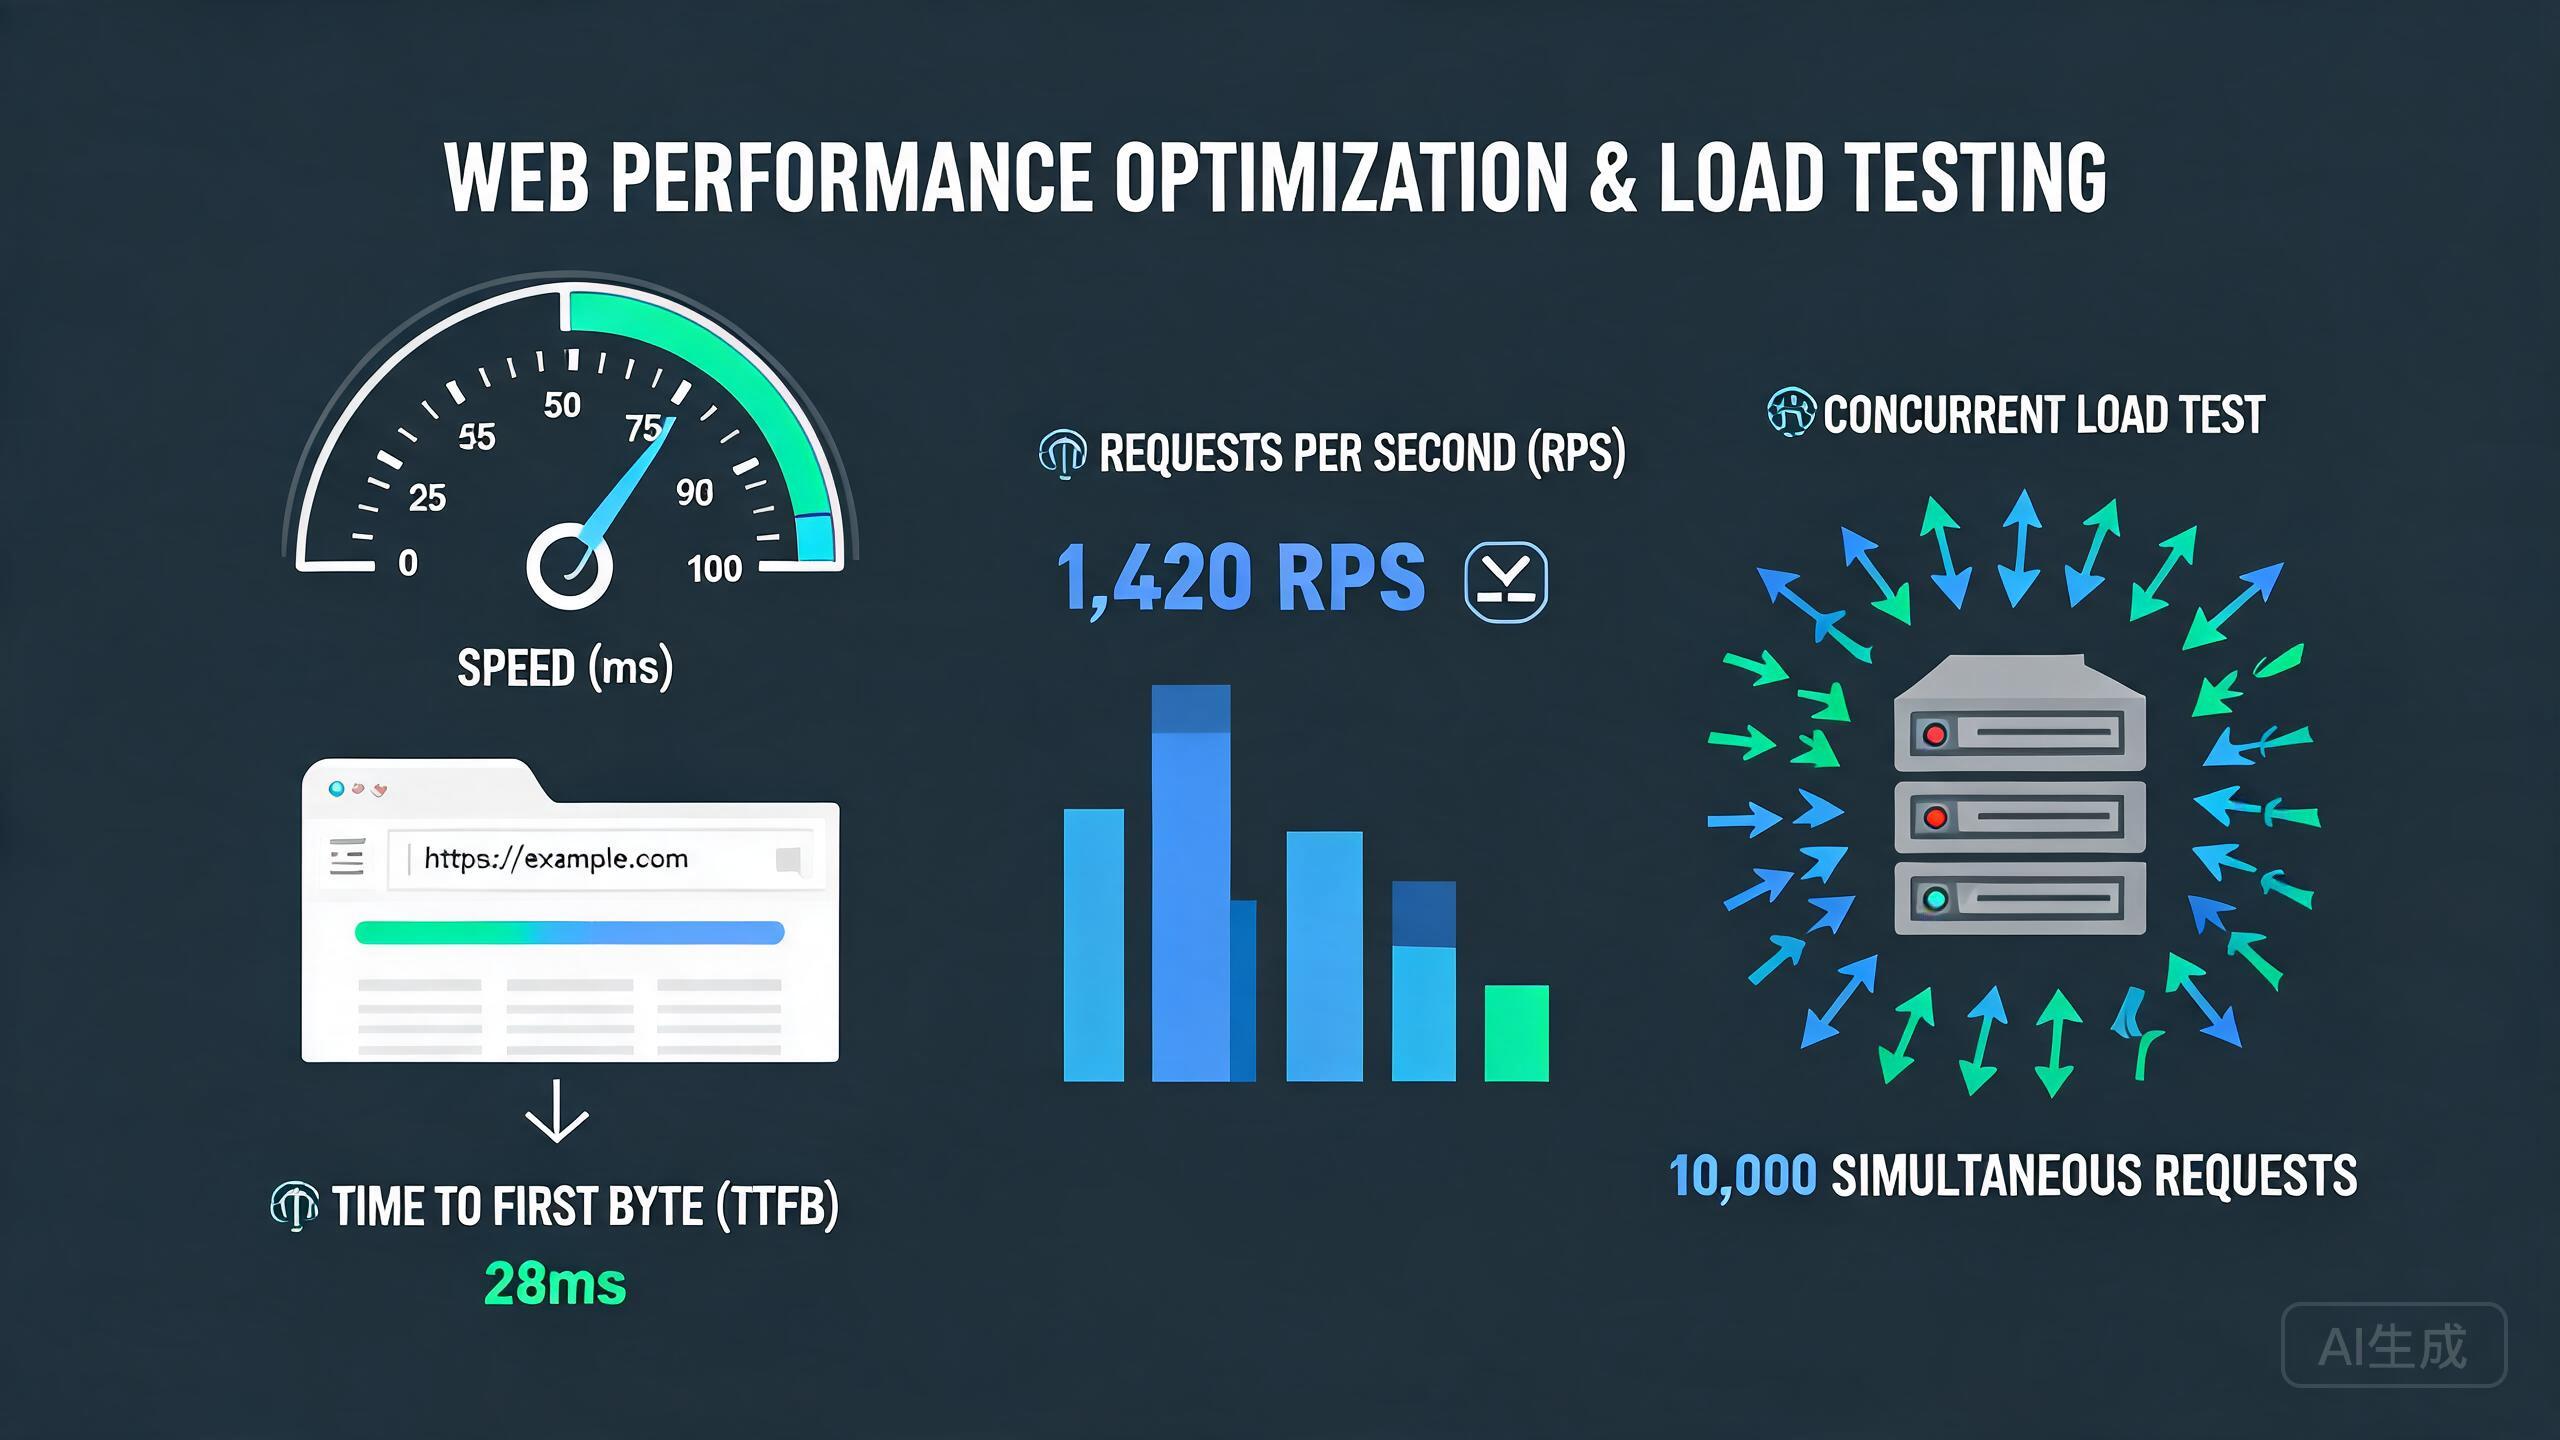
容量规划的第一步是拿到"这台机器的能力基线",方法就是前文聊过的压测:用 hey/wrk/ab 对入口做不同并发的压测,量出"请求吞吐(Requests/sec)、P95 延迟、错误率"随并发上升的变化曲线——找到"拐点"(再多并发,吞吐上不去、延迟暴涨、错误冒头的那个点),就知道这台服务的实际能力上限。同时用监控(Prometheus/系统指标,前面聊过)记录压测时 CPU/内存/IO/带宽的变化,定位"先饱和的瓶颈是哪个资源"——因为瓶颈往往不一定是你以为的那个。
# 量基线的典型做法(配合监控看瓶颈)
hey -n 20000 -c 50  https://你的域/api
hey -n 20000 -c 200 https://你的域/api   # 加大并发,看吞吐/延迟/错误怎么变
# 重点看:吞吐是否到顶不再涨(饱和)、P95 延迟是否暴涨、错误率是否抬头
# 同时看系统指标:CPU 是否打满、内存是否吃紧、磁盘 IO / 带宽是否先到瓶颈
量基线的坑:一是"压测负载不真实"——只压个静态首页和真实"查库 + 返回"的接口差很多,要用有代表性的、高频的真实接口(配合前面的 SQL/应用调优把真实路径跑起来);二是"别靠单次数据下结论"——多做几档并发、重复几次取稳定区间,别被一次抖动带偏;三是"记下当时的环境"——压测结果只在"那个被测版本/配置"下成立,版本或配置一变基线就要重测。
三、按需求与增长做规划:利用率、余量与扩容点
拿到基线后,把"现实需求"放进来:平时/高峰的真实访问量、数据增速、新增服务带来的增量。容量规划的一个实用模型:看"当前利用率"与"未来增长"——如果现在高峰 CPU 就常年 >80%,几乎不留余量,那么要么扩容、要么优化;如果高峰才 40%,但每月 +15%,就要算"几个月后会到 70~80%"那个拐点,提前扩。这里的关键是"余量"不是"越空越好":太低浪费钱,太满没缓冲,通常"高峰利用率不超过 70~80%"是较稳的经验线,给增长和突发留地。
# 一个粗糙但有用的估算示例
#   现在高峰 CPU 65%,月增 10% 访问量 → 约 2~3 个月后到 ~80%(接近饱和)
#   决策:在“到 80% 之前”提前扩容或优化,别等到白屏才动手
#   判断哪个资源先到顶:看监控里谁最接近饱和(CPU/内存/磁盘/带宽)
#   优化 vs 扩容:先优化(SQL/缓存/静态化,前面几篇),还不行再扩容
这块最容易犯的错是"只盯 CPU/内存,忽略磁盘与带宽":磁盘在数据增长时最易爆(且最不易扩)、带宽在流量上涨时先卡、连接数/文件句柄也会先到顶——都用监控数据看"谁先接近极限"。另一个是"把优化当扩容的解药":很多容量问题先被"优化"(SQL/缓存/压缩)缓解了,别一股脑只往"加资源"上想,优化在前、扩容在后。
四、监控与常态:让容量决策从"临时救火"变成"持续有数"
容量规划不是"做一次就完",而是要求"持续可见":把利用率、增长、瓶颈趋势做成监控看板(Prometheus + Grafana,前面聊过),配合"资源水位 + 增长预测"的告警,让"谁快满了、什么时候到临界"能被提前发现。这样容量决策从"哪次事故才想起"变成"常态有数、提前预案"。要点是"看趋势而非单点":单看某天 80% 可能是偶发,看一个月的趋势才能判断增长与季节波动。
# 容量监控看板/告警的关注项
#   - CPU/内存/磁盘/带宽 利用率与趋势(近 7/30 天)
#   - 高峰时段的资源水位(不是平均值,而是 P95/P99 或峰值)
#   - 各服务的请求量增长(判断谁在涨、涨多快)
#   - 资源水位逼近阈值(如持续 >80%)时告警,提前处理
这块的坑是"看错指标":看平均利用率会被"低峰拉低"掩盖高峰爆满——容量要看峰值/分位数而非平均;以及"有数据但没行动"——趋势看得一清二楚、到点不处理,等于白看,把告警接到前面聊的 Webhook 通知,让"该扩了"会主动到达责任人。
五、常见坑与边界:只盯单一资源、基线与现实脱节、过度留量
容量规划四个坑要尤其注意。一是"只盯单一资源":内存够了但磁盘要满、CPU 空闲但带宽卡死,都可能导致"其实已经到顶了"——全维度看,别只看自以为的瓶颈。二是"基线与现实脱节":压测基线和真实业务差太多(负载模型、缓存命中、网络位置不同),规划会失真——用真实接口、真实并发、真实网络去做。三是"过度留量":余量留得太大(常年 20% 利用率的机器堆着)是成本浪费——留量要贴着"增长 + 突发缓冲"来定,不是越空越好。四是"有规划不执行(没预案)":算出了"3 个月后要扩"却到了点不动手,规划就只是纸面——把扩容/优化做成带时间的行动项,并预演一次"怎么扩不打断服务"。
把它当排障 SOP:先"看监控全维度谁最接近饱和",再"用压测的基线判断离真实能力还有多远",后"结合增长算拐点、预留余量、定扩/优动作"。容量规划的价值在"提前看见拐点、从容采取动作",而不是"事后解释为什么挂了"。
把容量规划放回自托管整体:它是把"够不够用"从感觉变成"压测量基线 + 监控做趋势 + 按增长留量"的可量化工程,也是"优化在前、扩容在后"的决策依据。落地要点:用压测对真实接口量出能力基线与瓶颈资源;结合当前利用率与增长算"何时到临界",留合理余量(高峰 ≤70~80%)并"优化优先、扩容兜底";用监控看板 + 趋势告警让资源水位常态可见、到点有人处理;防住只盯单一资源、基线与现实脱节、过度留量、有规划不执行四坑。认清它是"决策依据"而非"预测模型"——当容量从"感觉够用"变成"量得出当前、推得到明天",自托管服务器才不会被"突然不够"打个措手不及。
结语
容量规划与性能基准的价值,是让"服务器够不够用"从凭感觉变成"压测量基线 → 监控看趋势 → 按增长留量"的可量化判断,从而在变慢/白屏之前提前扩容或优化。落地要点:用 hey/wrk 压测真实接口,量出吞吐曲线、P95 延迟与"先饱和的瓶颈资源";把当前利用率与增长结合起来算拐点,留 70~80% 高峰利用率的缓冲余量,坚持"先优化、后扩容";用监控看板与趋势告警让资源水位常态可见、到点有人处理;防住只盯单一资源、基线与现实脱节、过度留量、有规划不执行四坑;并认清它是决策依据而非精确预测。当容量从"救火式应对"变成"提前量化规划",自托管的资源才真正被用得既够又省。