监控里有一个"看得见却说不清"的盲区:Prometheus 能告诉你"这个 API 的延迟变高了",但它说不清"这个请求到底慢在哪个环节、是被哪一层拖住的"。当系统是"网关 → 认证 → 服务 → 数据库 → 缓存"这样一层套一层时,想知道"一次请求慢的这 200ms,究竟是卡在数据库查询还是卡在某个外部调用",就需要分布式追踪。OpenTelemetry(常简称 OTel)就是为此而生的"可观测性的统一标准":它不自己收数据,而是定义了一套规范和一个标准 agent/SDK,让你的服务用统一格式产生 traces(追踪)、metrics(指标)、logs(日志)三种信号。这篇讲清它为什么重要、一条 trace 由哪些要素构成、怎么接入自己的服务并把数据送到 Jaeger 这类后端,以及它和 Prometheus 的分工。
一、为什么需要追踪:从"服务慢"到"到底慢在哪一层"
没有追踪时,你分析"某个请求很慢"只能靠猜测和逐层打日志。追踪改变了这一点:它为"一个请求从入口到所有内部步骤"建立一条完整的时间线,把每一跳(一次 HTTP 调用、一个数据库查询、一次外部请求)都标上耗时,于是你能一眼看到"这 200ms 其实有 150ms 花在数据库查询上"。这在单体里是锦上添花,在"多个服务互相调用"的自托管栈(反代 → 应用 → 数据库/缓存)里几乎是唯一能高效定位"慢在哪个环节"的办法。
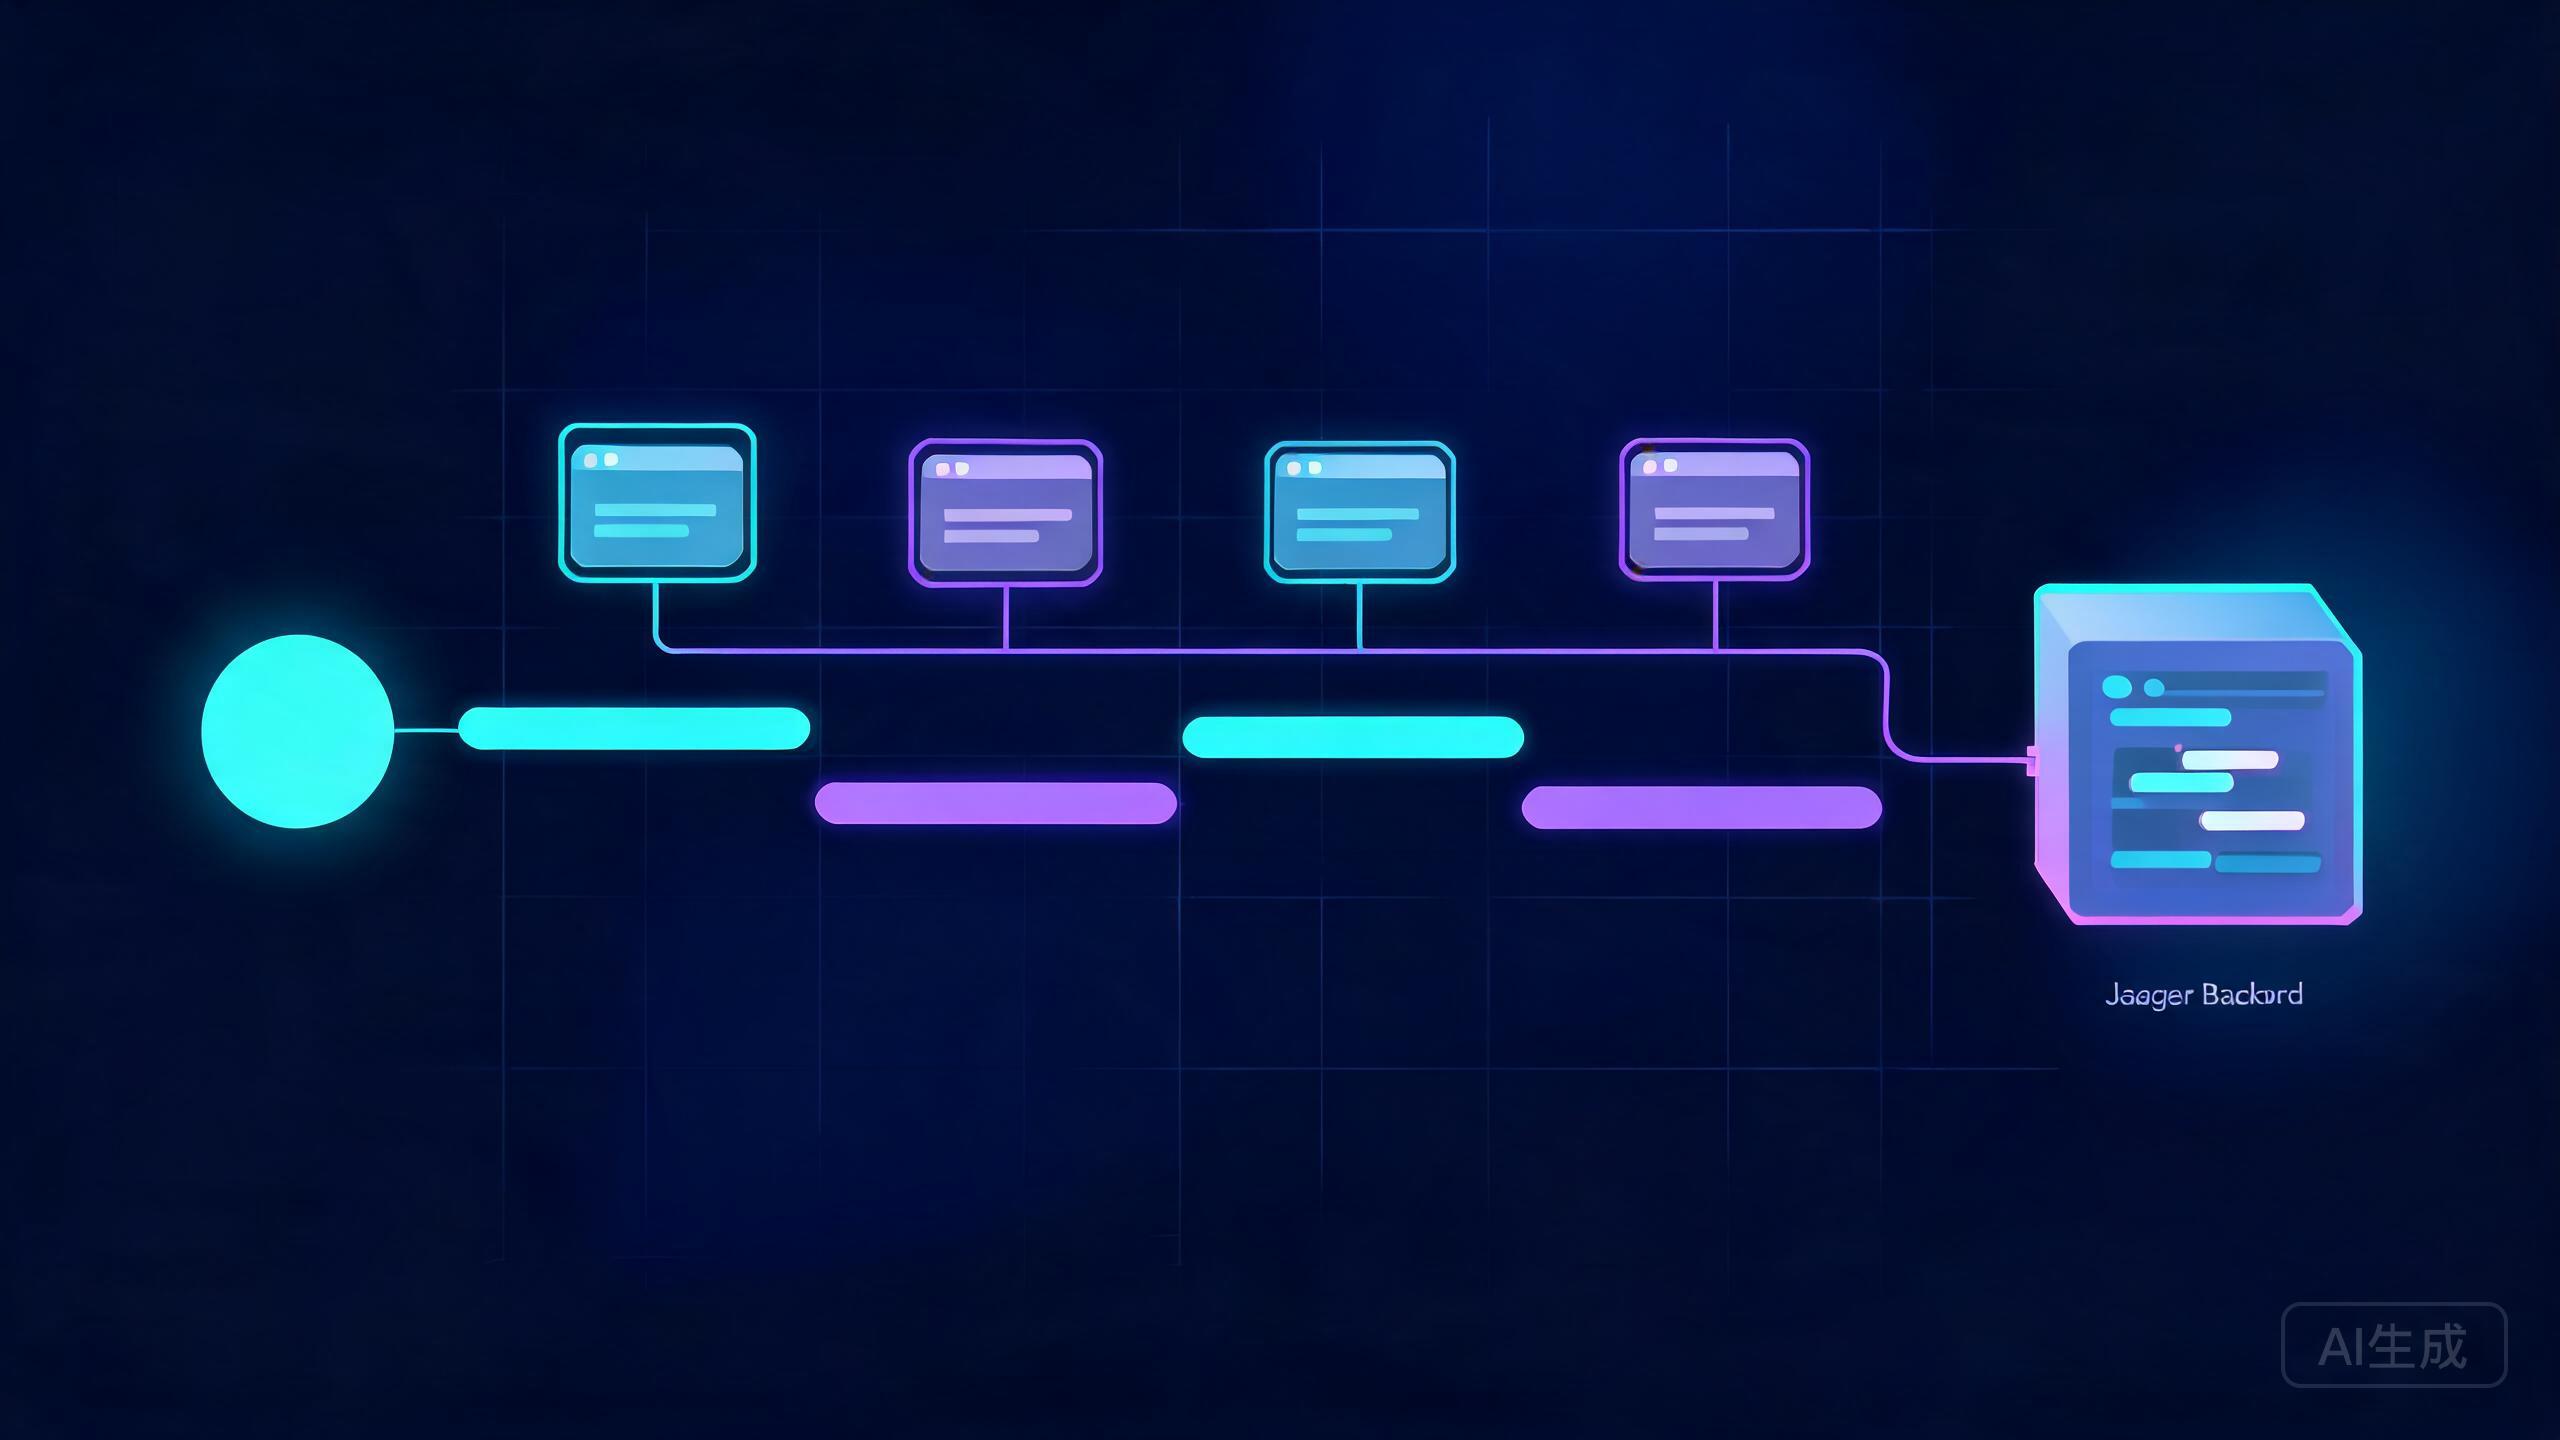
追踪的本质可以这样理解:给每个请求发一个全局唯一的 trace id,无论它流经多少服务,这些服务都会把自己这一步的 span(时间片段)挂到同一个 trace 下,再通过上下文传播把它串成一条完整链。于是"这一个请求去了哪些服务、每个服务花多久、谁调用谁"一目了然。对自托管的人来说,它适合"已经有多层调用、且真的遇到了'知道慢、却不知慢在哪'问题"的阶段,而不是单服务时就要上。
二、一条 trace 长什么样:trace / span / 服务名的三段式
理解 OTel 的三个最基本概念,就够读了:trace 是一次完整请求的整条轨迹;span 是这条轨迹里的一小步(一个动作的时间片段,比如"查数据库""调外部 API"),span 之间可以嵌套(谁调用了谁)或串行;attribute 是给 span 挂的键值信息(如 http.method、db.system)。一次请求=一个 trace,内含若干 span,每个 span 带自己的耗时、状态和属性。
# 一个 trace 的示意(追踪:request-abc123)
#   └─ span#0  [GET /api/orders]         耗时 220ms
#        └─ span#1  [db: query orders]    耗时 150ms  ← 慢在这
#        └─ span#2  [http: call billing]  耗时 60ms
# 从这可看出:慢主要是数据库查询(150ms),不是外部调用
练会"看懂 trace 树"就够了:自上而下看整棵树的耗时分布,找那个"支出占比异常大"的子 span,它就是瓶颈所在。这比"看总延迟"信息量大得多,也是追踪相对指标/日志的核心增量。
三、接入:SDK + 自动埋点,几乎不用改业务代码
OpenTelemetry 最舒服的一点是接入成本低:它对主流语言提供 SDK,并内置"自动埋点(auto-instrumentation)"——你只需在服务里初始化一个 OTel agent/SDK 并配置导出端点,常用的 Web 框架、HTTP 客户端、数据库驱动就会被自动插桩,自动产生 trace,不用手工把每个调用都改写一遍。以常用的侧车/agent 方式,或代码内几行初始化为例:
# 概念的初始化示意(Node/Python 等以各自 SDK 支持的形态实现)
# 在进程启动时导入 OTel 并设置 exporter 指向追踪后端
service = TracerProvider(resource=[service.name, "my-service"])
exporter = OTLPSpanExporter(endpoint="http://jaeger:4317")   # 经典后端 Jaeger
provider.add_span_processor(BatchSpanProcessor(exporter))
# 之后框架自动把每个进来的请求加上 span,无需改业务代码
接入流程可以拆成三步走:先在所在语言装 OTel SDK 并把导出端点点到后端(下面讲的 Jaeger/Tempo 之一)→ 启动后确认自动埋点能产生 trace → 需要时才给"关键但没被自动覆盖"的调用手写 span(用 SDK 提供的 span API)。大多数常见的自托管服务,自动埋点就覆盖了九成的链路。
四、数据送往哪:Jaeger / Tempo 这类追踪后端与查一查
OTel 只管"产生并导出",真正查的界面由"追踪后端"提供。最经典的是 Jaeger(专门做 distributed tracing 存储 + 查询 UI),另一常见的是 Grafana Tempo(和 Grafana 生态集成)。它们的共同点都是:接收 OTLP 格式的 trace,按 trace id 存起来,供你在界面里按服务/延迟搜索并查看某条 trace 的完整瀑布图。
# 用 Docker 起一个最小 Jaeger 作为 OTel 的追踪后端
docker run -d --name jaeger -p 16686:16686 -p 4317:4317 \
  -e COLLECTOR_OTLP_ENABLED=true \
  jaegertracing/all-in-one:latest

# 访问 http://服务器IP:16686 就能看到追踪搜索与瀑布视图
会用最关键的一个动作:在 Jaeger 里按选中的服务与接口搜到一条慢 trace,点开看瀑布图里哪一横条最宽。这一下就能回答"慢在哪一层的哪一次调用"。但要注意两个事项:追踪数据量级增长快(每条请求都记),要设置采样率避免被数据量淹没;追踪只保留一段时间(要配清理/保留策略),不像指标能做长期趋势。
五、定位:OTel 和 Prometheus / Loki 谁管什么
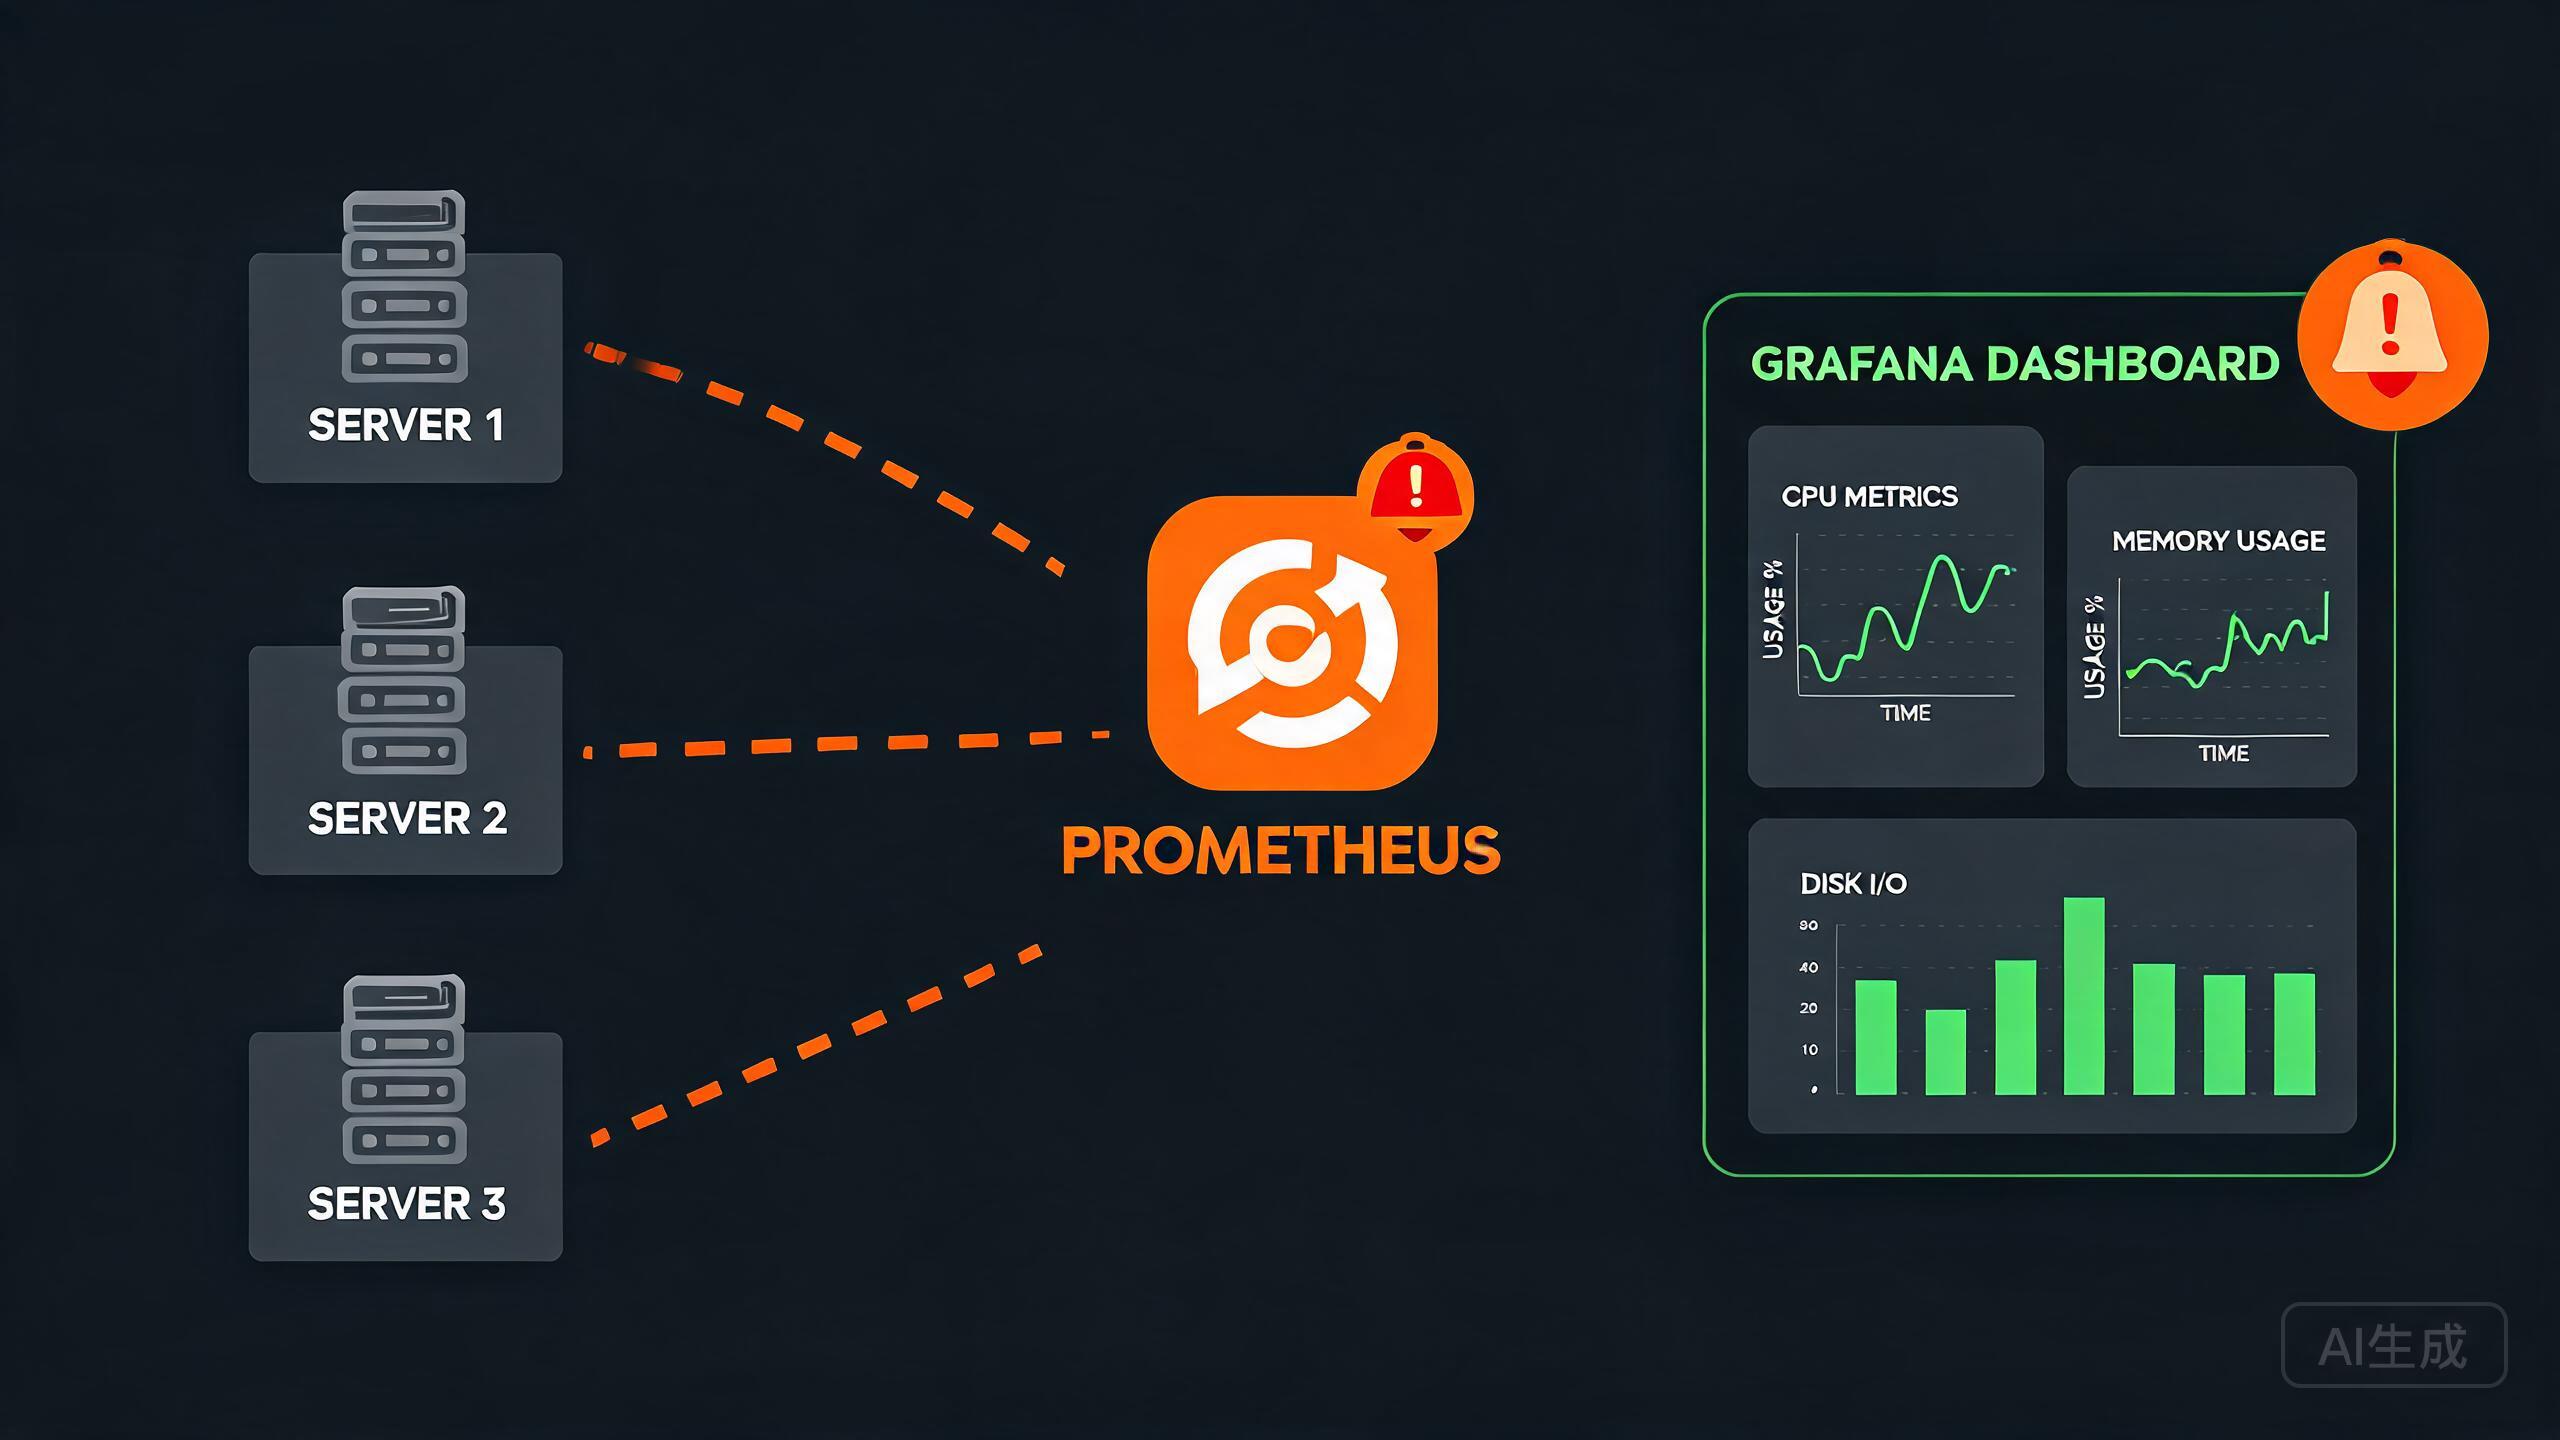
把"可观测性三件套"放进一张图就不容易混:Prometheus 管"指标(metrics)"——趋势、告警、这台机器或服务整体是不是健康;Loki 管"日志(logs)"——具体到某条报错的原话;OpenTelemetry 管"追踪(traces)"——这个请求在多层之间层层耗时如何分布。它们回答不同的问题:"是不是挂了"(指标)、"报了什么"(日志)、"到底慢在哪一层"(追踪)。OTel 甚至能把 metrics 也按统一格式送出来,但理念上它最标志性的能力还是 traces。
落到自托管,不必一上来就把三件套都上齐。务实的顺序是:先有 Prometheus 把"有没有挂/趋势/告警"底子打好;真遇到"系统整体看起来正常、但某些请求就是慢、又定位不到慢在哪",再引入 OTel + Jaeger 去查具体链路;日志(Loki)在要回看某段上下文时补上。别一上来就全铺——三套各有运维成本,按需逐层补,比一次性堆齐更省心。
结语
OpenTelemetry 的价值,是把"只知道服务慢"升级成"看得见慢在哪一层的哪一次调用"。抓住几个点就能上手:明白 trace/span/attribute 三段式、看懂 trace 树的耗时分布;用 SDK + 自动埋点几乎不改业务代码就能接出 trace;导出到 Jaeger/Tempo 这类后端并按"最宽的 span 找瓶颈";并把它和 Prometheus/Loki 按"指标答是否健康、日志答报什么、追踪答慢在哪层"分工。别急着全铺,而是当"多层调用 + 定位不到慢在哪"真实出现时,再用 OTel 补齐这道"看内部分布"的视角——它会让你排查慢请求时,从"靠猜"变成"拿着完整时间线说话"。