大多数 VPS 用户对"文件系统"的认知是"ext4 或 xfs,挂到 / 上就完事",最多知道"数据要备份"。可当你真正在意"数据会不会静默损坏""坏了能不能发现、能不能快速回到某个时刻",会发现传统文件系统给不了很好的答案。ZFS 是另一条路:它把"文件系统 + 卷管理 + 校验和 + 快照 + 压缩 + 复制"合成了一个整体,尤其以"数据完整性(永远校验收到的每个数据块)"和"快照/复制"著称。这篇讲清 ZFS 的画风与它解决什么问题、怎么在一台机器上建池与数据集、为什么它的"副本/RAID-Z/快照"和备份是两码事,以及自托管该在什么时机用它。
一、ZFS 和 "ext4 + 手动备份" 的根本不同
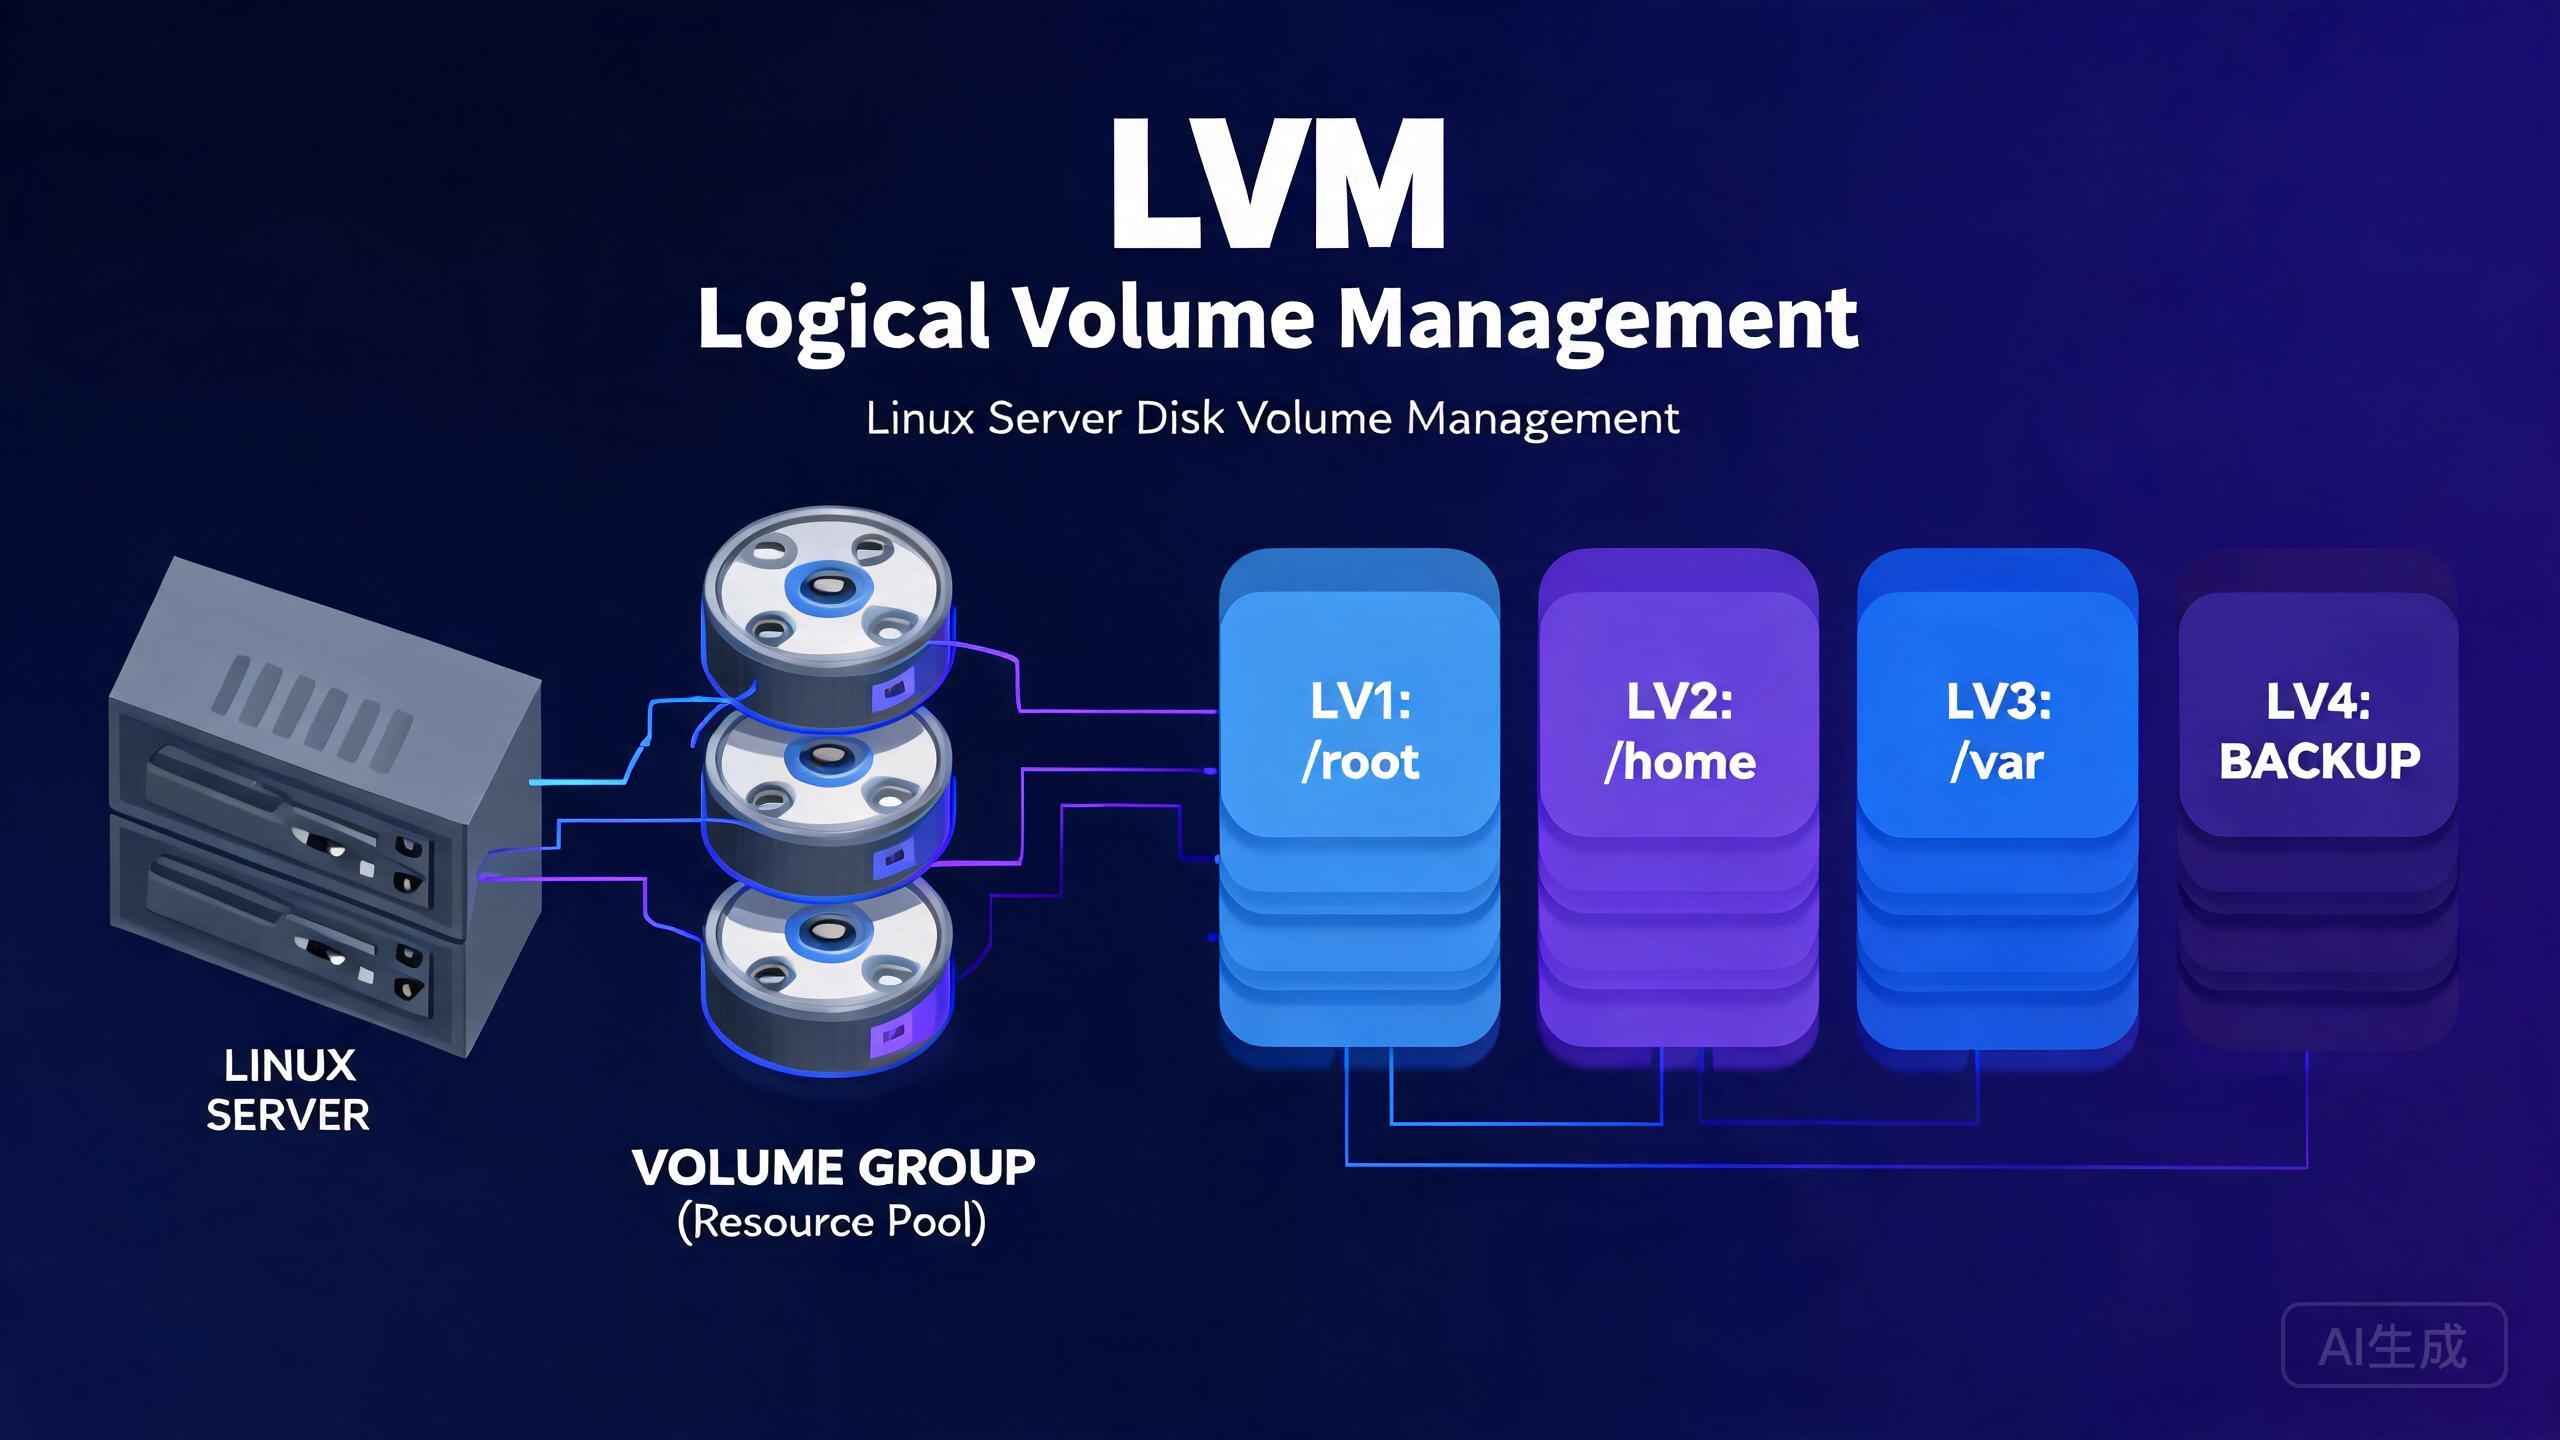
传统的文件系统通常把"文件管理"和"磁盘管理"分开:ext4 管单个文件的元数据和内容,RAID 或 LVM 管"哪几块盘拼成一块"。ZFS 把这层合并了——它自己既是文件系统又是卷管理(用"池 pool"直接管原始磁盘/分区),并引入了一个关键设计:每个数据块写入时都带一个校验和并在读取时校验,因此"数据是否损坏"不再是你猜的,而是能主动检测(bitrot / 静默损坏能暴露出来)。
对自托管/小规模 NAS 的人来说,这个"数据完整性"的价值被低估了:磁盘在役期发生静默位翻转、内存错误、掉电后写坏一两个块,都是真实存在的事。普通文件系统不报错,等你想起来时坏数据可能已经被复制到备份里。ZFS 的校验 + 修复(在有冗余时自愈)让"数据坏没坏"变得透明。它背后要做这些,也就注定比传统 fs 更吃内存,这是一开始就要权衡的。
二、最小上手:建池、建数据集、看属性
先厘清三个 ZFS 的基础概念:池(pool)是底层存储的集合,比如把两块盘放进一个池;数据集(dataset)是在池里划分出来的逻辑卷,可以独立设配额、设压缩、独立做快照。基本操作如下:
# 假设系统里有 /dev/sdb 和 /dev/sdc 两块全新数据盘
# 把两块盘建成一个镜像池(mirror,一份数据两份,能容忍一块盘坏)
zpool create tank mirror /dev/sdb /dev/sdc

# 在池里建数据集,并开启压缩
zfs create tank/nextcloud
zfs set compression=lz4 tank/nextcloud

# 查看池状态、数据集与容量
zpool status
zfs list
这里"mirror 双盘"对应最常见的自托管起步:它既给了"一块盘坏了数据仍在"的冗余(等同 RAID1),又能读性能、还能在坏盘时重建。ZFS 的分层(pool → dataset)是它好用的关键——把不同用途(比如"系统盘""数据盘""备份盘")分成不同数据集,各设各的策略,比"一个 ext4 根分区 + 一堆目录"好管得多。
三、RAID-Z 与副本:用冗余对抗"盘坏"的两种思路
ZFS 提供两种"冗余"思路。一是物理层面的 RAID-Z(等价 RAID5/6:允许坏一块或两块物理盘而不丢数据,但需要至少三块盘、写入性能略低),适合数据量大、盘位多的磁盘阵列。二是逻辑层面的"副本(copies=N)",针对"只有单块盘 / 想防坏块不想付物理盘成本"的场景——它把同一份数据多写几份到同一块盘的不同位置,读取时互相校验。对"我只有一块盘"的 VPS 级/家庭级用户,这就是不会上 RAID 时最用得上的保障。
# 只有一块盘也能"校验自愈",给关键数据集开副本=2(写两份互相校验)
zfs set copies=2 tank/important
心里要有杆秤:RAID-Z"防的是整块物理盘坏",副本"防的是个别数据块损坏",它们既不互相替代、也不等于备份。很多人以为"开了 RAID 就安全了",其实 RAID 只防"硬盘故障",防不了"误删、勒索、软件 bug、命令手滑"——那才是数据丢失最常发生的方式,只能靠"写到另一处的快照/备份副本"来兜底。分清"冗余"和"备份",是 ZFS 新手最重要的一课。
四、快照与发送:ZFS 的杀手锏,也不是备份的替代
ZFS 把"回到某个时刻"变得极度方便,靠的是快照(snapshot)——它是数据集在一瞬间的只读副本,几乎不占空间、创建几乎瞬时,专门用来"后悔药"。你可以对关键数据集隔几小时拍一个快照,误删/改坏了就用 `zfs rollback` 或挂载快照找回。配上 `zfs send | ssh ... | zfs receive`,还能把快照增量复制到另一台机器——这是把 ZFS 当"异地备份管道"最常用的方式。
# 拍一个快照,并回滚到它(防止手滑/勒索把数据搞坏)
zfs snapshot tank/nextcloud@before-update
zfs rollback tank/nextcloud@before-update

# 把快照增量复制到远端(另一台开启了接收的 ZFS 机器)
zfs send tank/nextcloud@before-update | ssh backuphost "zfs receive tank/backup/nextcloud"
但要再次强调:快照虽然强大,它一般还"在同一份存储里"——如果你的整个池坏了或机子没了,快照也跟着没了。快照防的是"想回到过去",跨机的 `zfs send` 才承担"真正的异地备份"。把两者搭配:本地快照负责恢复时效,异地 send 负责地理容灾,再配合之前聊过的通用备份换个地方再留一份,才构成完整防线。
五、别急着上:ZFS 的代价、时机与自托管建议
ZFS 不是无成本的银弹。它比较吃内存(做缓存 / 校验),起步建议至少给足 RAM 以防不足导致 OOM;建池和数据集的取舍一旦定下、迁移麻烦,所以"先想清楚再动手"。它对 VPS 也常有限制:很多云主机给的是"一块系统盘 + 虚拟盘",能否用另建池要看挂载与磁盘权限,且多数 VPS 场景很难真正用 multi-disk RAID——这时 ZFS 在单盘上的价值主要在"校验自愈 + 快照"(copies + snapshot),仍值得,但要放低对"硬冗余"的预期。
务实的自托管建议是分场景:如果数据大多是"丢了可惜但可重建"(应用、容器),不一定值得为 ZFS 付出内存和复杂度;如果承载的是"无可替代的资料、照片、数据库"这类最怕静默损坏和误删的数据,那 ZFS 的校验自愈 + 快照 + 远端 send,几乎是"性价比最高的数据保险"。原则是"为真正重要的数据把 ZFS 用起来",而不是全套撒上、为炫技背复杂度。
结语
ZFS 把"文件系统、卷管理、校验、快照、压缩、复制"揉进一层,换来的是别处给不齐的"数据完整性可见"和"回到过去的能力"。抓住几条就能用对:理解 pool → dataset 的分层并分数据集管策略;mirror/RAID-Z 防的是物理盘坏,copies 防的是数据块坏,两者都不是备份;快照负责"后悔药"、跨机 send 才承担真正异地备份;并清醒它的内存代价与 VPS 上的限制。当你的照片、数据库、文档这些"丢不起"的数据越来越多时,ZFS 就是那层"让静默损坏能被发现、让手滑能回过去、让关键数据在异地多一份"的保险——它让"备份"从一句口号变成你能说得清、查得到、用得上的动作。