自托管服务一旦暴露到公网,你迟早会碰到两类不速之客:一类是"爬虫/采集"——它们可以在很短时间内把你的页面、API 抓走、占满带宽、甚至拖垮服务;另一类是"攻击/滥用"——暴力撞登录、接口被狂刷、薅羊毛、甚至 DDoS 打到你宕机。面对这些,防火墙挡的是"不该进门的端口",而你已经放行的 Web 端口里,靠什么区分"正常用户"和"异常流量"?限流与防爬就是在这层做文章的:对同一个来源/同一个资源限制访问频率,识别并拦掉爬虫与滥用,让有限的资源优先服务真实用户。这篇讲清它解决什么、常见限流与防爬手段、怎么用反代/工具落地,以及它的边界与误伤风险。
一、它解决什么:在"已经放开"的入口里再做第二道分辨
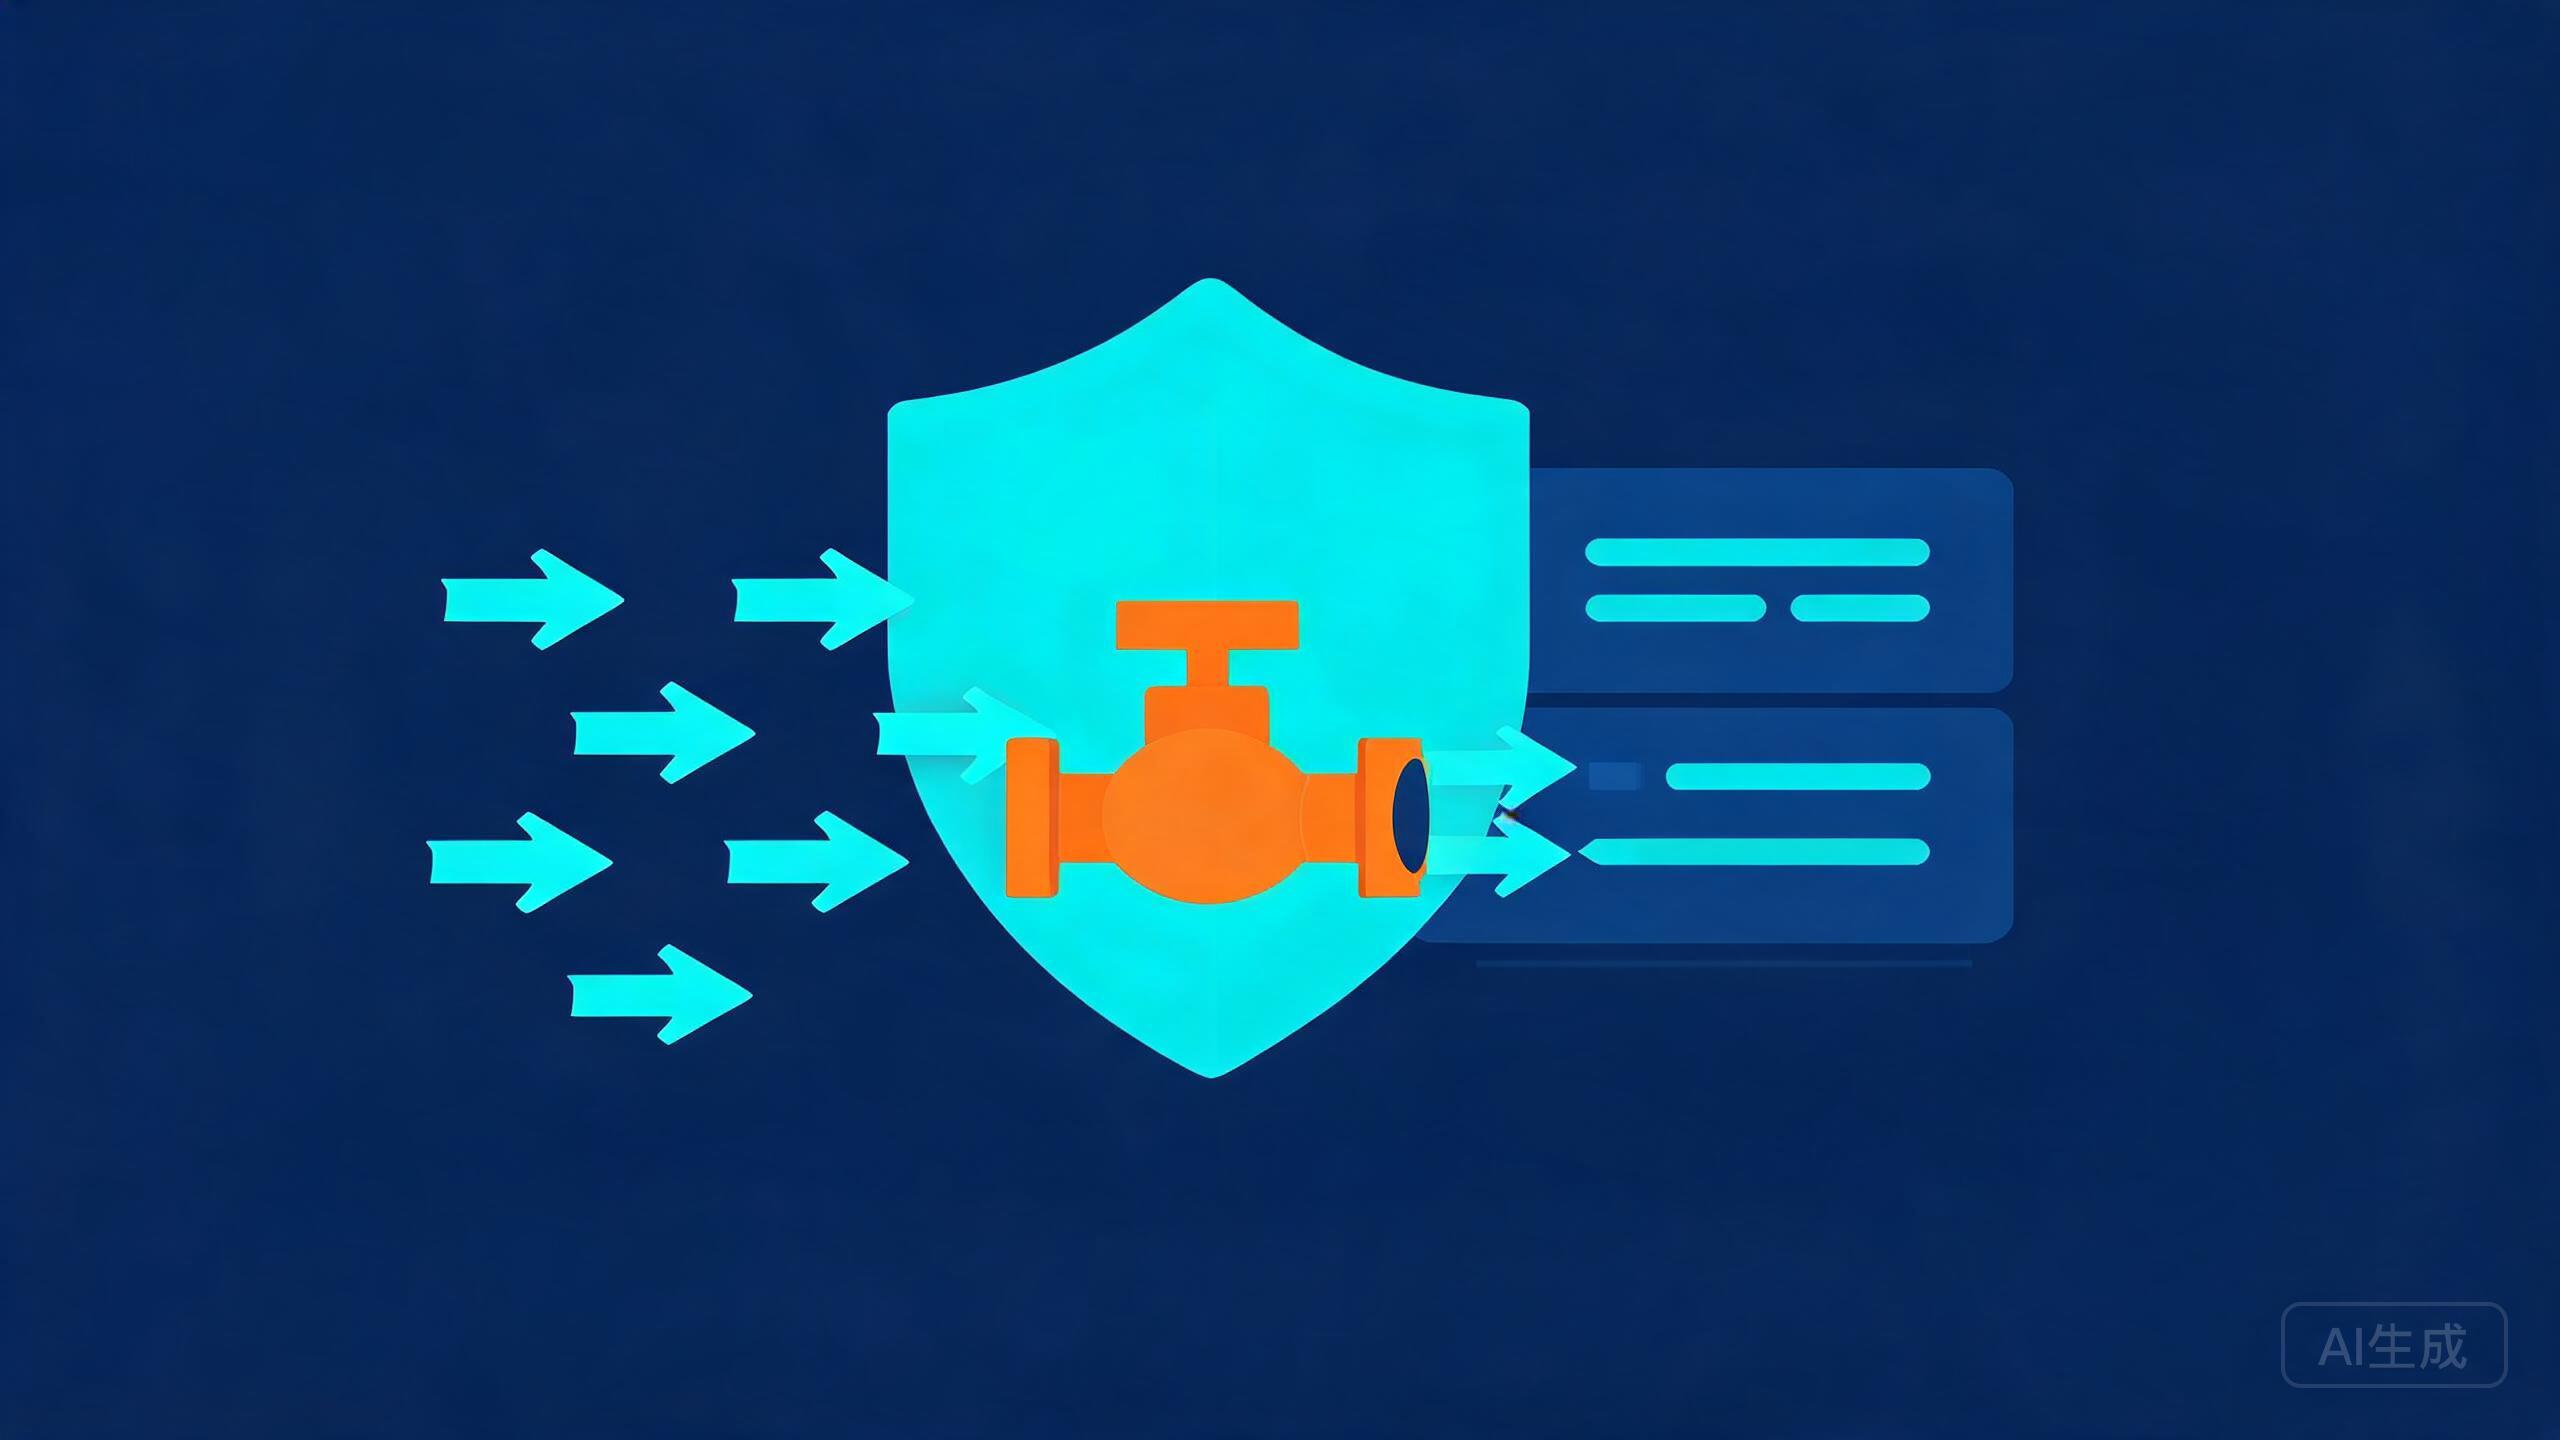
你已经做过防火墙(默认拒绝、只放必要端口),也配好了 HTTPS 与反代。但公网入口开着,就意味着任何机器都能来请求——于是你面临的不是"谁进不来",而是"进来的先后里,如何让正常请求和滥用区分对待"。限流解决的是"频率"维度:限制同一来源/IP/账号在一定时间内的请求次数,防暴力、防刷接口、防被扫爆。防爬解决的是"来源与行为"维度:识别看起来像机器/爬虫的访问(特征、UA、行为、IP 来源),拦掉或减缓它,避免它把资源抓空。
二者共同的本质是"默认对所有入站请求不完全信任、按风险定级",把有限的 CPU/带宽/数据库连接优先保障真实用户与关键业务。对自托管者尤其重要,因为你往往没有云厂商那套现成的防护,要自己配好这层"入口内的闸";理解它才能避免"我明明开放了该开放的,却还是被打爆/抓垮"的无力感。
二、限流怎么做:反代层与工具层各有抓手
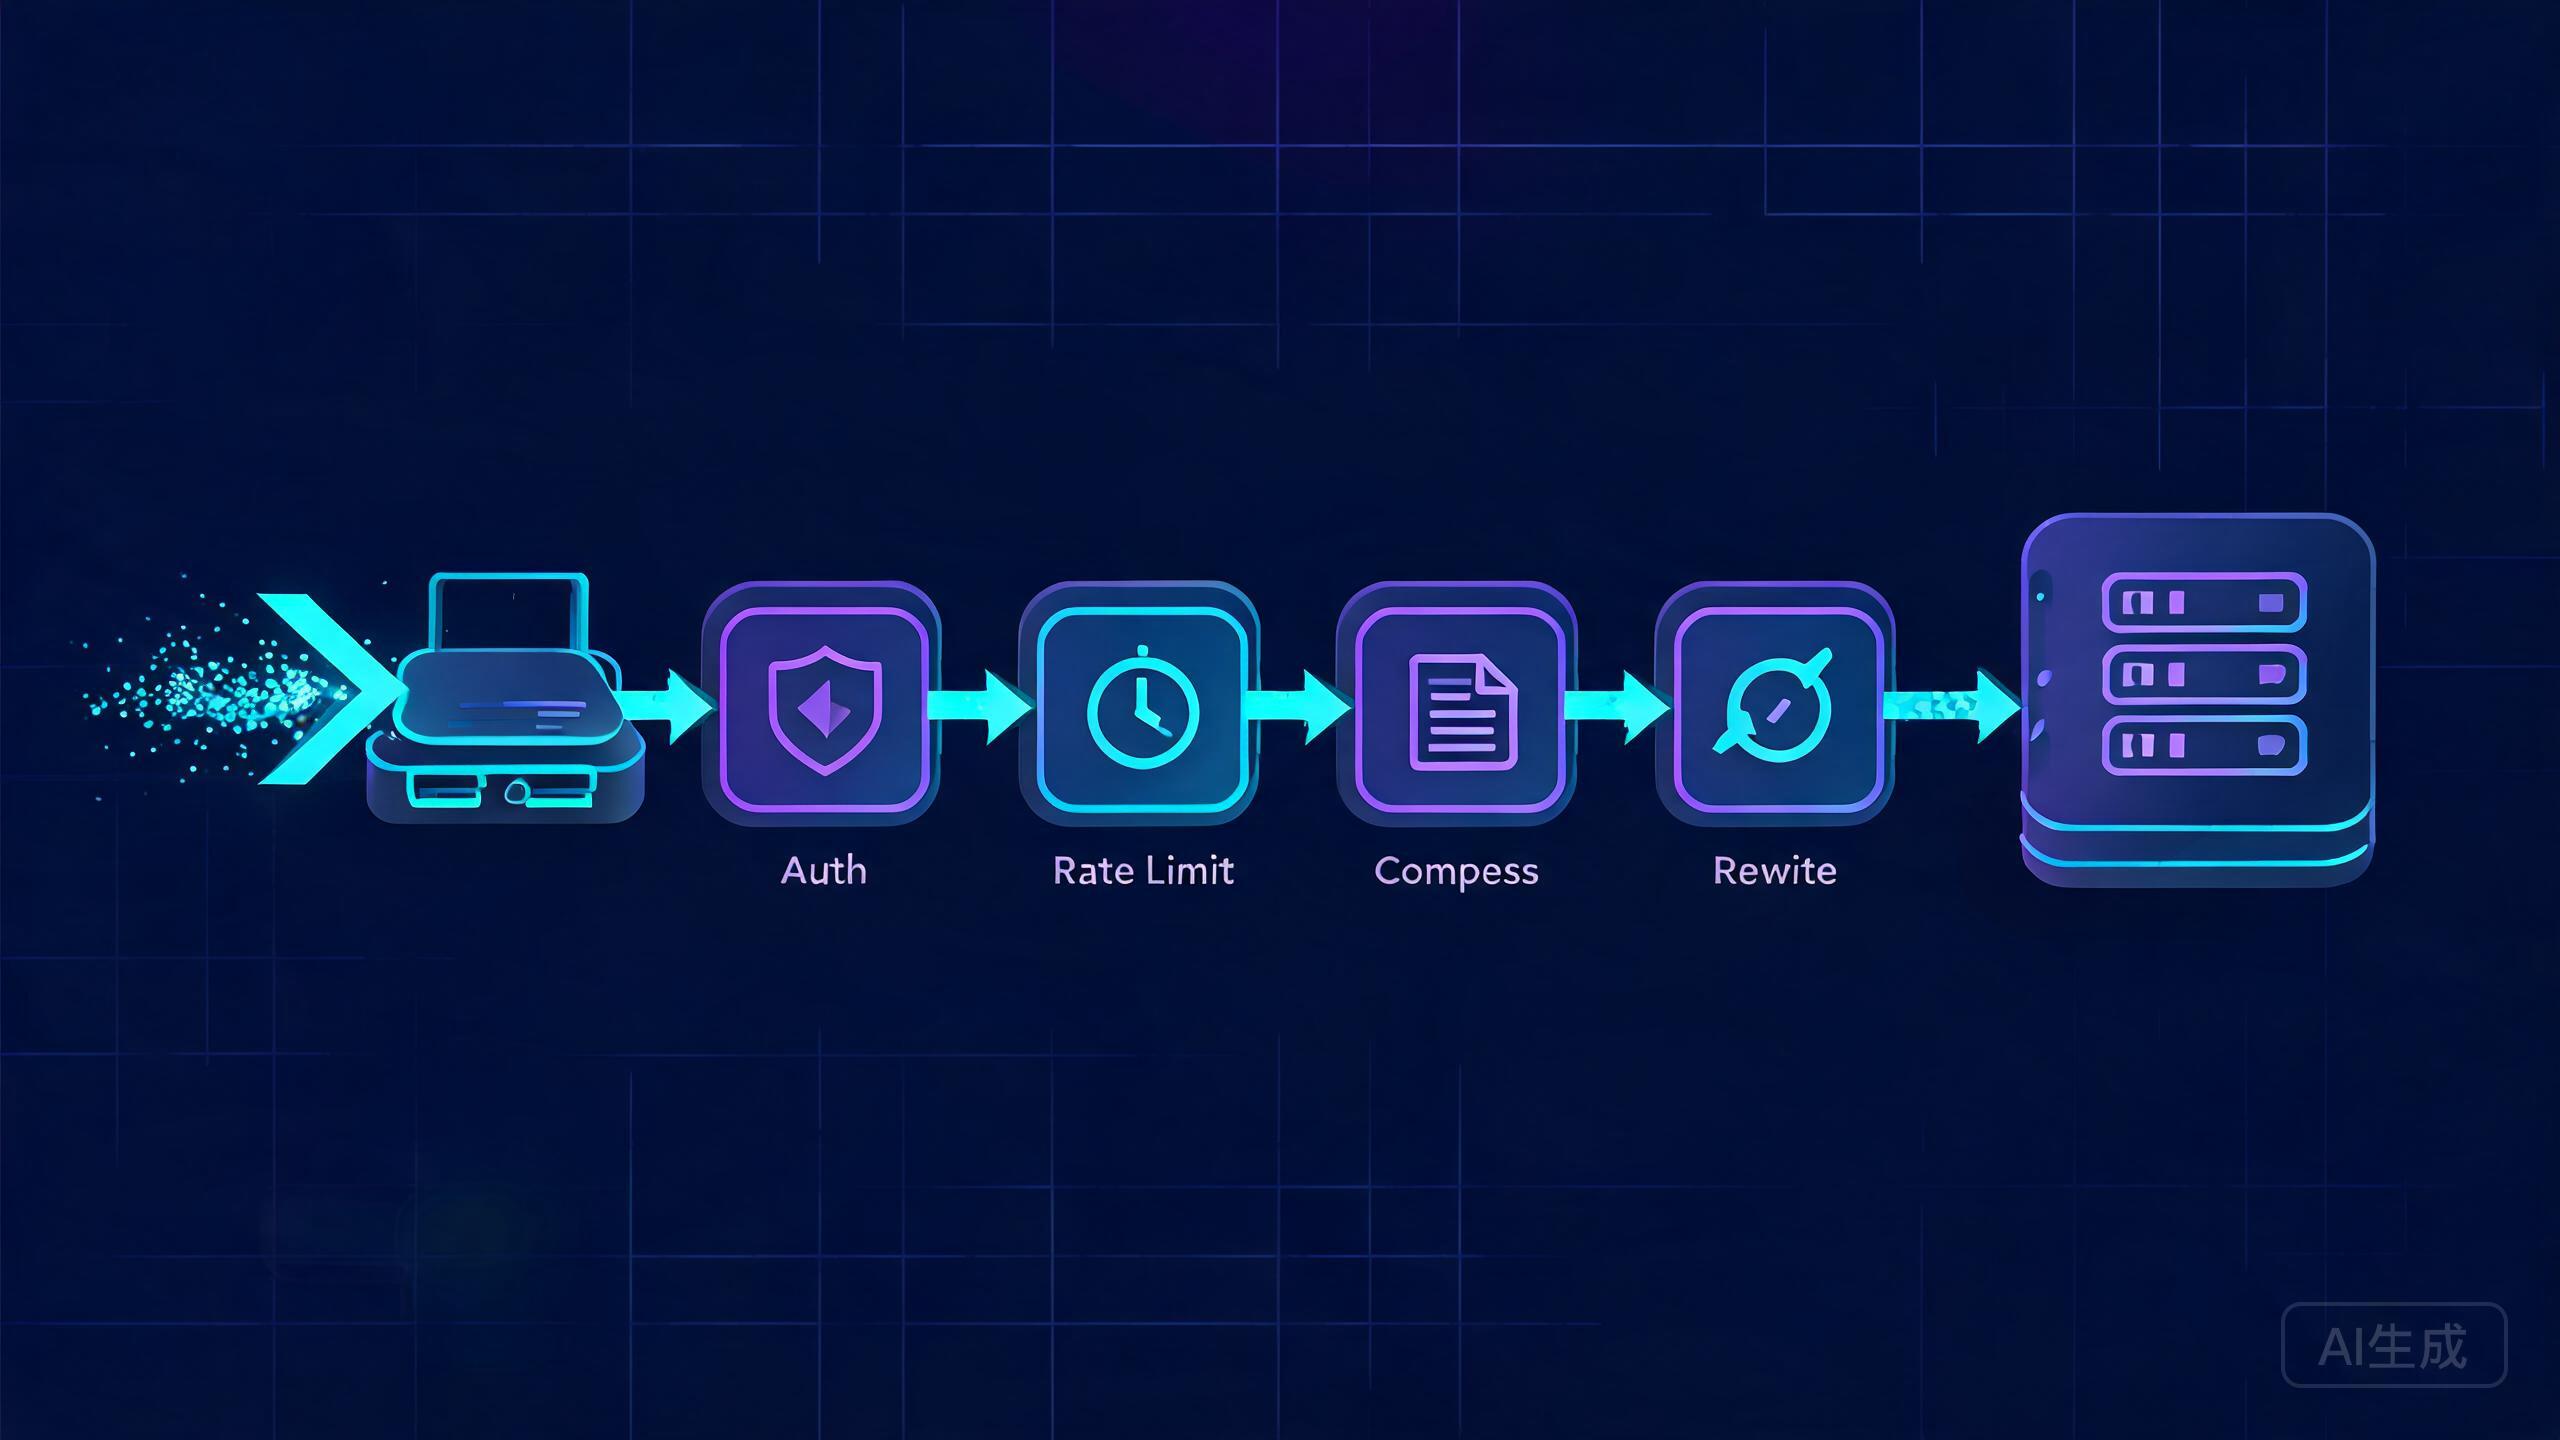
限流最常见的落点是在反向代理层,因为流量先到网关、在这里拦截最省资源。以 Nginx 为例,`limit_req`(漏桶式限频)和 `limit_conn`(限制并发连接)能按 key(常用来源 IP)限制请求频率/连接数,超出的可排队或返回 429/拒绝。更细的还可以配合脚本/中间件,对"登录/高价值接口"这类更敏感的位置做更严的限频。给一个 Nginx 限流的示意:
# Nginx 限流示意(按 IP 限制,超出返回 429)
limit_req_zone $binary_remote_addr zone=one:10m rate=10r/s;
server {
  location /api/ {
    limit_req zone=one burst=20 nodelay;   # 峰值可放宽一点,防误伤
    proxy_pass http://backend;
  }
}
# 配合:对登录接口可更严,用单独的 zone/更低 rate
# 合理的 length:正常用户不至于触发,异常来源才被限
落地要注意"别误伤正常用户":限流参数的 burst(突发容忍)和 rate(恒定速率)要按你的真实访问量来定,宁可略宽松也别把正常用户卡掉;同时要能区分——对"来自同一出口 IP 但其实是多人的正常流量"要充分考虑。把"限得太死刷到自己人、限得太松等于没限"之间的平衡找到,才算把限流用到位,而不是给它一刀切。
三、防爬识别的几个抓手:行为、特征与来源
限流管"频率",防爬还要识别"是不是机器"。常用抓手有几类:一是"行为特征"——瞬间拉连很多页面/接口、很少有停顿、几乎无不同 UA/设备变化的,更像爬虫;二是"特征信号"——异常/批量 UA、请求头缺失、命中已知爬虫库的,可显式拦截;三是"来源与触发"——来自数据中心 IP、已知攻击源,或触发到蜜罐路径的,可整体降权或拒绝。自托管里可以靠反代日志分析,或引入专门工具(如 CrowdSec 那类异常检测/态势共享、fail2ban 那种基于日志上报规则)来加分批拦截。
# 简单防爬思路(示意,与限流配合):
#   - 对明显像机器的高频来源(短时间大量请求且无正常交互)返回 429/蜜罐拒绝
#   - 用 CrowdSec/fail2ban 这类工具:基于日志模式识别异常来源并临时封禁
#   - 对 /admin 这类敏感路径做更严的访问控制(限 IP/加认证/封异常)
把"限流打频率 + 行为识别打机器 + 来源/蜜罐判风险"组合起来,比单靠一种更有效。落地顺序上建议"先限流(成本低、立刻有效)→ 再看有没有必要上更重的行为识别/工具"。别一上来就上复杂规则把自己维护到疲;先用限流把"被刷爆"压住,遇到确凿的爬虫再逐个加规则,稳扎稳打地防。
四、把它做成"数据支撑的防御",也纳入告警
真正有效的限流与防爬,应当是有数据支撑、可观测的,而不是写了规则就没人看。落地要点:让反代/防御层的日志能统计出"哪个来源触发大量 429/被拦截"——这既帮你发现是不是有爬虫/攻击在打,也帮你判断限流是否误伤;同时对"拦截量异常上涨、某个接口被狂刷"设告警,让自己及时知道而不是等事故发生。把防护和可观测结合起来,才不会出现"人走了、规则还在乱拦"。
# 可观测思路:
#   - 统计 429/拦截日志,看 top 来源,判断是否真有人在刷/是否误伤
#   - 对"某接口高并发/大量被拦截"设告警,配合前面的监控(Prometheus/Uptime Kuma)
#   - 定期回顾限流参数是否合当前访问量,防僵化
把"防护日志 + 告警 + 定期回顾"作为限流/防爬的配套,防御就变成了动态可调、可量化的系统工程,而不是一堆"设完再也不看"的静态规则。用手里的监控栈盯住这块,能让你在有人试图刷爆你之前,就已经在数据上看见苗头——这才是限流与防爬该有的健康状态。
五、边界:它是"第二道闸",不是"绝对防护",也别误伤真实用户
最后把边界包含清楚。第一,限流/防爬是"入口内基于访问的分辨",它挡的是大多数滥用与普通扫描,但不等于完全防住高明的攻击或真正的大规模 DDoS——那种规模和手法仍可能需要专门的防护/CDN/清洗能力,自托管别指望几行规则挡一切。第二,最大的风险是"误伤真实用户":限流太紧、封 IP 太激进,可能把同一出口的正常用户也卡掉。解决办法永远是"先观察、先宽松、有问题再收紧、始终能看日志回退",并把"敏感但可能多人共用 IP"的场景想清楚。
# 防误伤的几条铁律:
#   - 限流参数先按真实流量掂量,别一开始就卡得死死的
#   - 识别为目标明确的爬虫/攻击源泉再封禁,避免粗放地大范围封 IP
#   - 敏感路径(登录/后台)宁严不松,但普通访问宁宽不误伤
把限流/防爬当成"有数据、可调、会告警、尊重真实用户的第二道闸"来用,它就能显著减轻爬虫与滥用的压力,又不会把自己人挡在门外。认清它做不到"绝对防护"、需要与防火墙、蜜罐、CDN/清洗能力分层配合,才能既不迷信也不忽视这一层。当这层做稳,你的自托管入口就从"敞开的门"变成"有节奏、有分辨、有退路"的一道可控闸口。
结语
限流与防爬的价值,是在"已经放开的公网入口"里再做一道分辨:用频率限制(限流)挡住刷接口与暴力,用行为/特征/来源识别(防爬)拦掉爬虫与滥用,把有限的资源优先保障真实用户。落地要点:在 Nginx/Caddy 反代用 `limit_req`/`limit_conn` 按 IP 做限流并与真实流量掂量平衡、防误伤;结合行为特征、UA/来源、蜜罐路径与 CrowdSec/fail2ban 等工具做防爬;把拦截日志、告警与定期回顾做成数据支撑的防御。边界是它挡普通滥用而非绝对防护,且最怕误伤——始终"先宽后紧、能回退、敏感路径宁严、普通访问宁宽"。把这层当成你入口内可控、可观测的第二道闸,自托管服务就能更稳地面对爬虫与滥用。