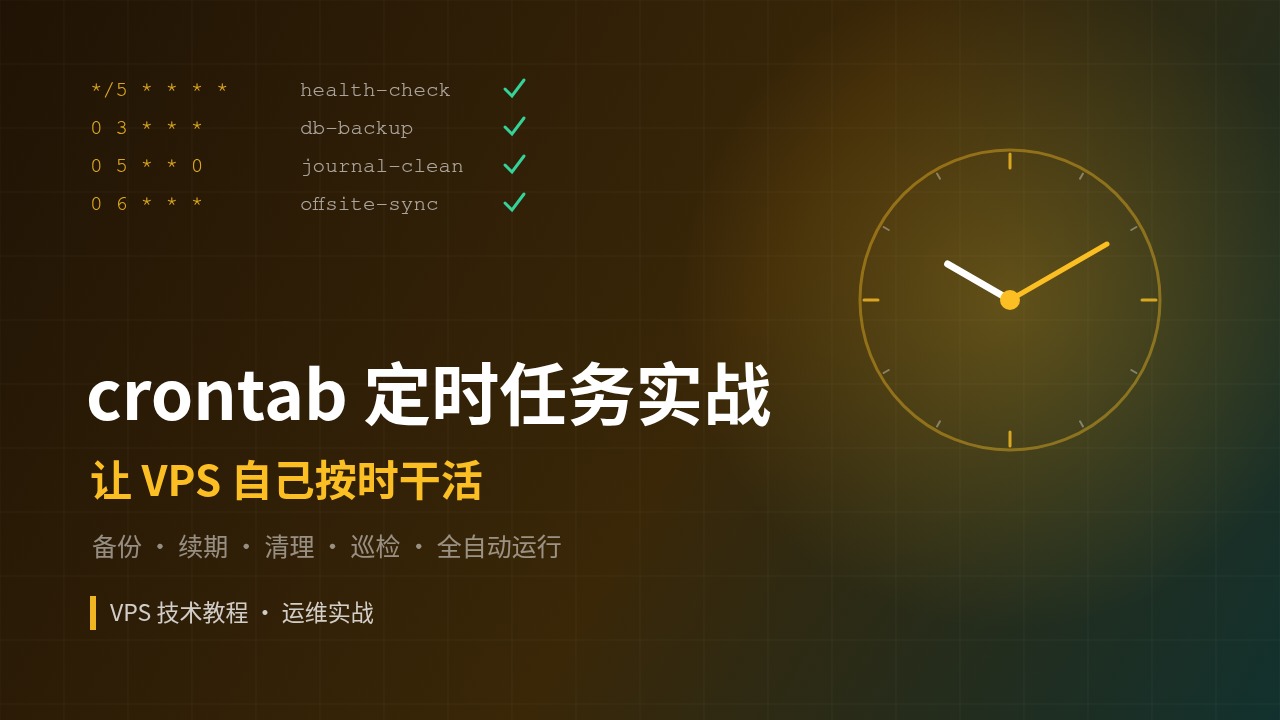
自托管的事做久了,你会发现大量琐事在反复出现:每天清理日志、定时把数据库备份传到远端、早上起来看一眼磁盘剩余空间、定期同步某个文件夹——这些"手工反复做"的活儿,正是脚本与定时任务(cron)存在的意义。而最常被用来自动化它们的,就是 Linux 上几乎无处不在的 Bash 脚本加 cron 定时器:把"我要做的事"写成可重复执行的脚本,再交给 cron 在约定时刻自动运行,从此你只管检查执行结果,不必每次手工敲命令。这篇讲清 Bash 脚本解决什么、怎么写一个"有健壮性"的脚本(错误处理、set -e、日志与退出码)、怎么用 cron 定时与 systemd timer 调度,以及定时任务常见的坑与边界。
一、为什么自动化是自托管的"底气":让电脑替你按时干活
自动化的核心不是"省一次敲命令",而是"把重复动作升级为可预期、可复现、可交接的流程"。你写的脚本一旦跑通,它就成了一个确定性的执行单元:今天跑、明天跑、放到另一台机器跑,行为都一致,而这正是把运维从"凭记忆手工"变成"看脚本就跑"的关键。对自托管者尤其如此——你不可能 24 小时守在服务器前做磁盘清理、备份、日志轮转,把这类固定动作交给脚本与定时器,才能让"一堆常驻服务"安稳运转下去。
它和前面聊的更大工具(如 Ansible 做整机配置、Restic 做等等专用备份)其实是同一思路的不同尺度:专用工具负责它专业的那类任务的编排,而 Bash + cron 是最朴素、零依赖、几乎任何机器都有的"原子自动化"手段。先把最基础的这套用熟练,再去挑专用工具,是最可靠的路径。
二、写好一个"有自知之明"的脚本:错误处理、set -e、日志与退出码
初学者常以为脚本就是把一堆命令按顺序排下来;但专业写法的关键是让脚本"知道自己在出错时停下来,并且能被外部判断成败"。最基础三招:开头 `set -e`(一出错就退出,避免带病执行后续)、必要时 `set -u`(用未定义变量立即报错)、以及整个脚本用合适的退出码(0 成功、非 0 失败)表达结果——这样定时任务或监控才能可靠地判断"这趟到底成没成"。再配合把关键步骤打日志到文件,出问题时才有据可查。
#!/usr/bin/env bash
set -euo pipefail            # 出错即停 + 未定义变量报错 + 管道失败算失败
log=/var/log/my-task.log
echo "[$(date '+%F %T')] 开始备份" >> "$log"
if ! command -v restic >/dev/null; then
  echo "缺少 restic" >> "$log"; exit 1
fi
restic backup /srv/data --tag nightly   # 关键动作,失败会因 set -e 退出
echo "[$(date '+%F %T')] 备份完成" >> "$log"
给脚本定几条实用铁律:所有关键数据路径用变量定义在一处,避免到处硬编码;每个可能失败的外部命令都要想"它失败了我该怎么办"(靠 set -e 兜底或显式判断);日志时间戳打全,方便排查;脚本执行权限与所有者设置好,别用 root 乱跑普通任务。写脚本最省钱的做法是"先让它在出错时不悄悄掩盖、能被一眼看破",这样以后迭代才不返工。
三、用 cron 按时调度 + 用 systemd timer 做更可靠的替代
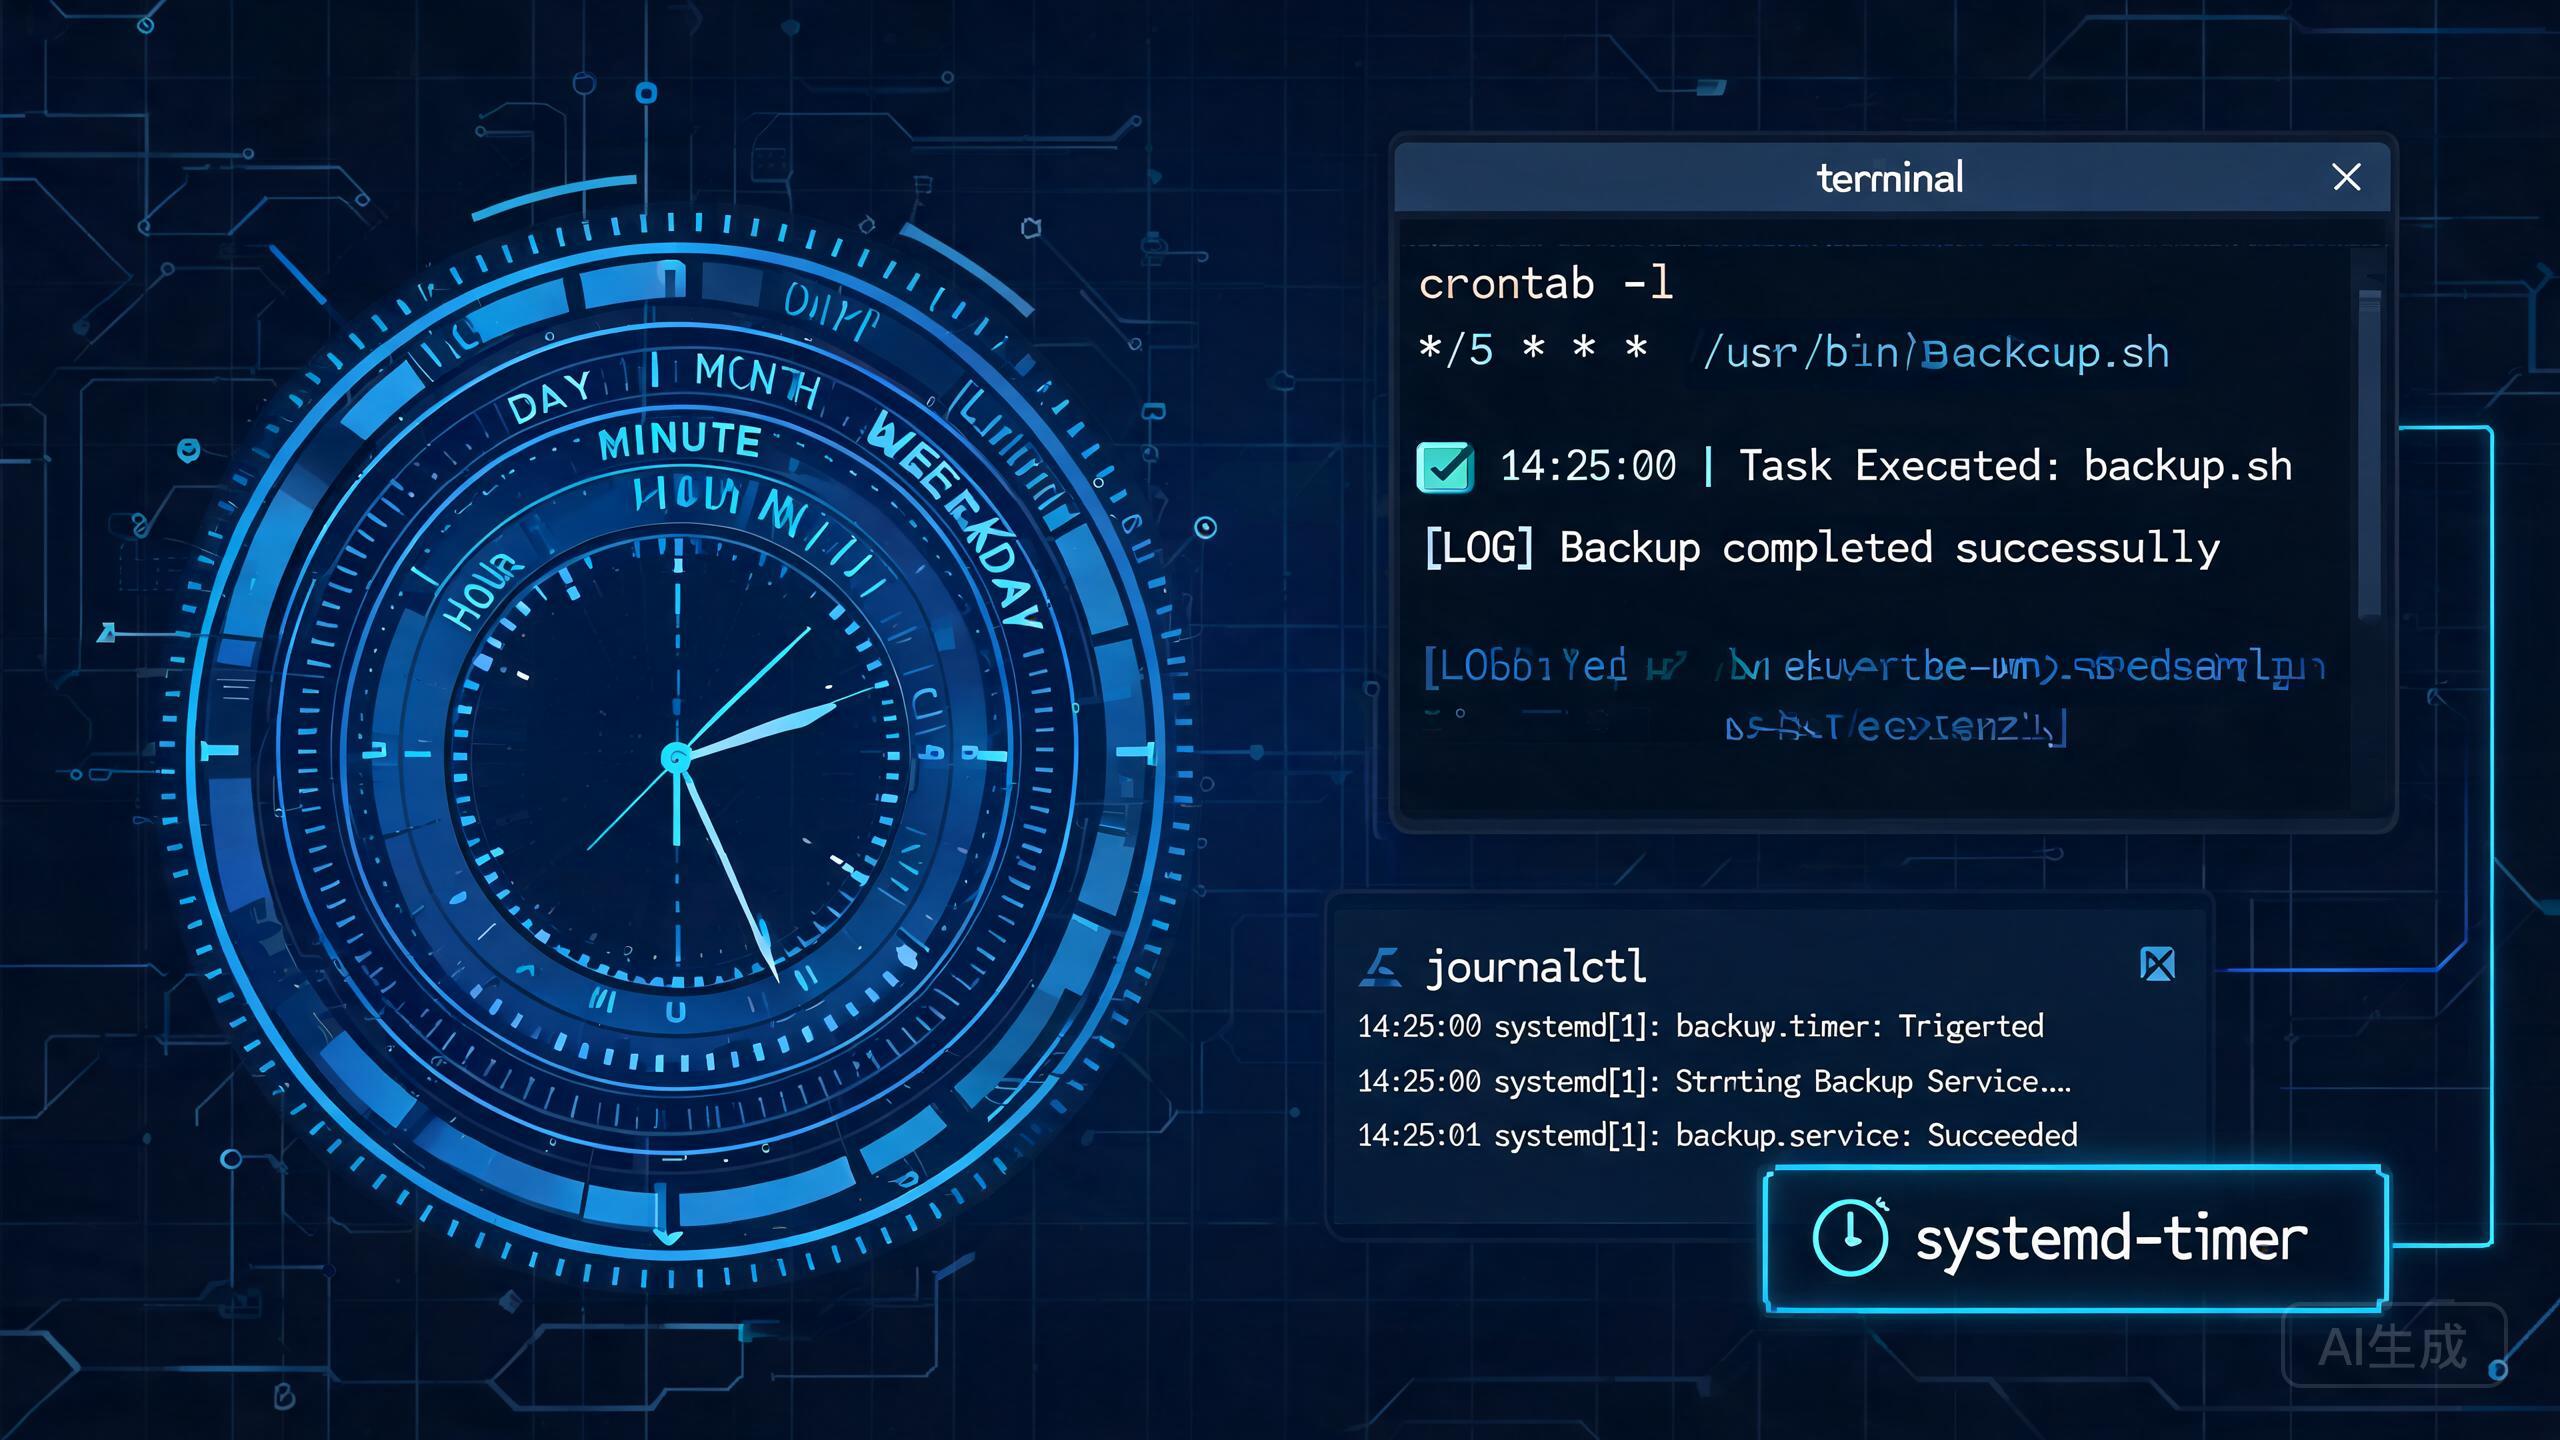
有了脚本,下一步是让它"到点自动跑"。最经典的是 cron:编辑 `crontab -e`,一行"分 时 日 月 周 + 命令"即可定时执行。更现代也更被推荐的是 systemd timer:把任务写成 systemd 服务单元 + 一个 timer 单元,能精确控制"错过时间怎么办""防重入""依赖网络/服务就绪后再跑",还自带日志(journal),比裸 cron 更稳、更能防叠跑。
# 方式一:cron,每天 02:30 跑
# 30 2 * * *  /usr/local/bin/nightly-backup.sh >> /var/log/cron-backup.log 2>&1

# 方式二:systemd timer(更可靠,防重入、错过时间可补跑)
# /etc/systemd/system/backup.service  与 backup.timer
# [Service] ExecStart=/usr/local/bin/nightly-backup.sh
# [Timer] OnCalendar=*-*-* 02:30:00   Persistent=true   (错过可补跑)
选调度的判断:简单日常任务 cron 够用;涉及"防重入、错过补跑、依赖某服务先起、想看 journal 日志"的任务,用 systemd timer 更稳。无论用哪种,都要先"手动把脚本跑一遍确认没问题",再交给定时器——别让一个本身有 bug 的脚本披上"定时任务"的外衣定期出错。把"到点自动跑 + 失败能被发现"这条闭环做成自动化的大前提。
四、常见的坑:路径、时区、重入、没看日志
定时任务出问题,多半不在脚本本身而在环境与细节。四个高频坑要预防。一是"环境变量与路径":cron 环境很干净,PATH 往往不完整,脚本里要用绝对路径、source 好你需要的环境(如数据库密码文件),别指望 cron 替你加载 shell 配置。二是"时区":服务器默认时区可能是 UTC,你以为的每天 0 点可能是北京 8 点,先把服务器时区设对再看 cron 时间。三是"重入与耗时":一次任务没跑完下次又启动,常见于耗时的备份/同步任务,用文件锁或 systemd 的防重入来兜底,避免两个备份同时在跑。四是"没看日志":任务跑完从不看输出,等于把错误当静态数据存放——定时任务务必配"失败告警"或至少定时抽查日志,否则自动化反而变成"看不见的错误源"。
# 防重入:用锁文件(flock)
exec 9>/var/lock/mybackup.lock
flock -n 9 || { echo "已有实例在跑"; exit 1; }
# 之后才是真正的备份逻辑
把这几条当成排障 SOP:先跑一次看输出,再查是否真有执行(日志里有没有新行),再确认路径/环境/时区/重入,最后决定要不要改脚本而不是盲目加定时。定时任务敢不敢交给"静默全自动",取决于它有没有"失败会被看见"的设计——这比跑了几次更快更重要。
五、边界:自动化替你干活,不是替你做决策
自动化的边界也要认清。第一,它负责"可按固定规则反复执行"的动作,但"判断该不该删、视情况决定启用哪套策略"这类需视态决策的,仍要保留人工/谨慎的复核——尤其是删数据、清磁盘这类不可逆动作,脚本可以提"删除清单",但高风险操作的确认回头再聊。第二,自动化工具本身也要纳管:脚本仓库要做版本管理、权限最小化,定时任务不要跑一堆没人维护的僵尸脚本——它们是日常运维的"债务"。
把自动化放回自托管整体里看:它是整个数据安全体系里"按时、可靠、可复核地执行固定动作"的基础能力。把"写稳脚本 + 用对调度 + 让失败可见"这套吃透后,备份、日志轮转、磁盘检查这些维护固化成自动闭环,你才能把精力留给真正需要判断的事。自动化不替你做头疼脑热的判断,但它能确保"那些该定时做完的事"永远不会因为你的遗忘而漏掉——这正是'把服务器当长期资产养'与'随缘手工折腾'的分水岭。
结语
Bash 脚本与 cron/systemd timer 的价值,是把"重复、固定、易忘"的维护动作固化成可预期、可复现、可交接的自动流程。落地要点:用 `set -euo pipefail`、退出码与日志让脚本"出错即停、结果可判定";用 cron 做简单、systemd timer 做"防重入、错过补跑、看 journal"的更可靠调度;排队脚本要先手动跑通再交给定时器;防住"路径/时区/重入/没看日志"四坑,并让每次失败都能被看见。让脚本为定时任务补齐"可靠执行 + 可判定成败"的地基,你才能把服务器长期、安稳、可交接地养下去。